В этой статье мы вместе с небольшим примером рассмотрим, как HashGNN хэширует узлы графа в пространство встраивания.
Если вы предпочитаете посмотреть видео об этом, вы можете сделать это здесь.
HashGG (#GNN) — это метод встраивания узлов, в котором используются концепции нейронных сетей передачи сообщений (MPNN) для захвата свойств близости и узлов высокого порядка. Это значительно ускоряет вычисления по сравнению с традиционными нейронными сетями за счет использования метода аппроксимации, называемого MinHashing. Таким образом, это подход, основанный на хешировании, и он вводит компромисс между эффективностью и точностью. В этой статье мы поймем, что все это значит, и рассмотрим на небольшом примере, как работают алгоритмы.
Вложения узлов: узлы с похожими контекстами должны быть близки в пространстве встраивания.
Многие варианты использования графового машинного обучения, такие как предсказание ссылок и классификация узлов, требуют вычисления сходства узлов. В контексте графа эти сходства наиболее выразительны, когда они охватывают (i) окрестности (то есть структуру графа) и (ii) свойства встраиваемого узла. Алгоритмы встраивания узлов проецируют узлы в низкоразмерное пространство вложений, т. е. они назначают каждому узлу числовой вектор. Эти векторы — вложения — можно использовать для дальнейшего численного прогностического анализа (например, алгоритмов машинного обучения). Алгоритмы встраивания оптимизируют метрику: узлы с похожим контекстом графа (окрестности) и/или свойствами должны быть отображены близко в пространстве встраивания. Алгоритмы встраивания графов обычно используют два основных шага: (i) определение механизма выборки контекста узлов (случайное блуждание в node2vec, k-кратная матрица перехода в FastRP) и (ii) последующее уменьшение размерности при сохранении попарных расстояний (SGD в node2vec, случайные проекции в FastRP).
HashGNN: обойти обучение нейронной сети
Подсказка о HashGNN заключается в том, что он не требует от нас обучения нейронной сети на основе функции потерь, как это было бы необходимо в традиционной нейронной сети передачи сообщений. Поскольку алгоритмы встраивания узлов оптимизируются для «похожих узлов должны быть близки в пространстве встраивания», оценка потерь включает в себя вычисление истинного сходства пары узлов. Затем это используется в качестве обратной связи для обучения, насколько точны прогнозы, и для соответствующей корректировки весов. Часто в качестве меры подобия используется косинусное сходство.
HashGNN обходит обучение модели и фактически вообще не использует нейронную сеть. Вместо обучения весовых матриц и определения функции потерь он использует рандомизированную схему хеширования, которая хэширует векторы узлов до одной и той же сигнатуры с вероятностью их сходства, что означает, что мы можем встраивать узлы без необходимости прямого сравнения узлов друг с другом ( т. е. нет необходимости вычислять косинусное сходство). Этот метод хеширования известен как MinHashing и изначально был определен для аппроксимации сходства двух наборов без их сравнения. Поскольку наборы кодируются как двоичные векторы, HashGNN требует двоичного представления узла. Чтобы понять, как это можно использовать для встраивания узлов общего графа, требуется несколько методов. Давайте посмотрим.
Минхеширование
Прежде всего, давайте поговорим о MinHashing. MinHashing — это метод хеширования, чувствительный к местонахождению, для аппроксимации подобия Жаккара двух наборов. Сходство Жаккара измеряет перекрытие (пересечение) двух наборов путем деления размера пересечения на количество уникальных элементов, присутствующих (объединение) в двух наборах. Он определяется наборами, которые закодированы как двоичные векторы: каждому элементу во вселенной (множеству всех элементов) назначается уникальный индекс строки. Если конкретный набор содержит элемент, он представляется как значение 1 в соответствующей строке вектора набора. Алгоритм MinHashing независимо хеширует двоичный вектор каждого набора и использует K хеш-функции для создания для него K-мерной подписи. Интуитивное объяснение MinHashing заключается в случайном выборе ненулевого элемента K раз, выбирая элемент с наименьшим значением хеш-функции. Это даст вектор подписи для входного набора. Интересно то, что если мы сделаем это для двух наборов, не сравнивая их, они будут хешироваться с одной и той же сигнатурой с вероятностью сходства по Жаккару (если K достаточно велико). Другими словами: вероятность сходится против подобия Жаккара.
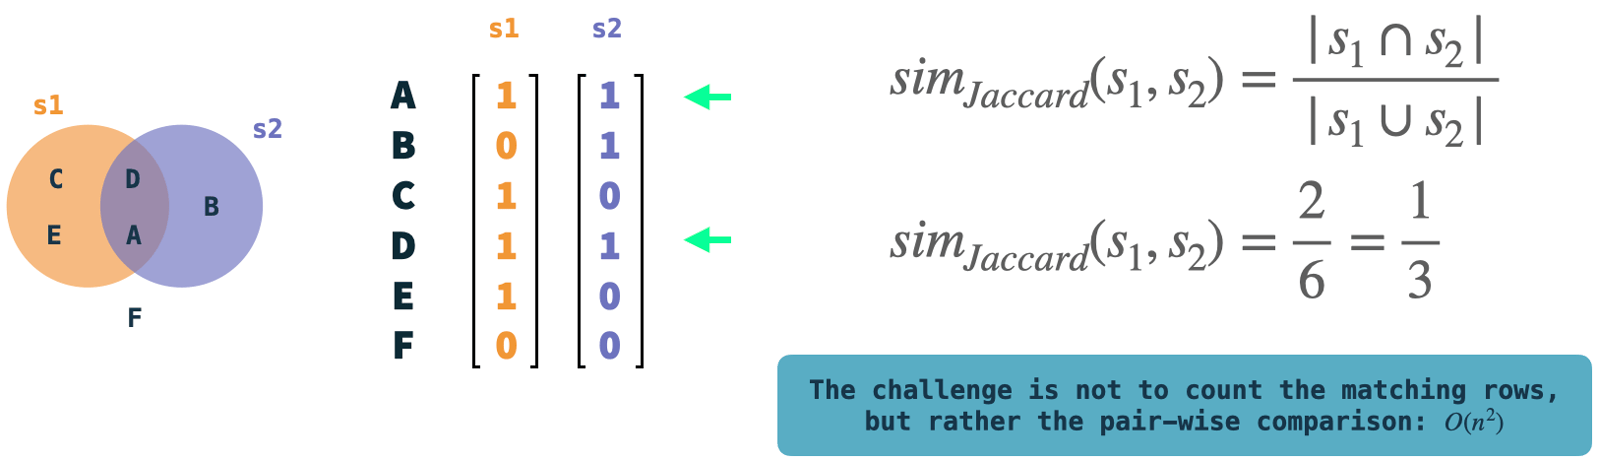
На иллюстрации: Наборы примеров s1 и s2 представлены в виде бинарных векторов. Мы можем легко вычислить сходство Жаккара, сравнив два и подсчитав строки, в которых оба вектора имеют 1. Это довольно простые операции, но сложность заключается в попарном сравнении векторов, если у нас много векторов.
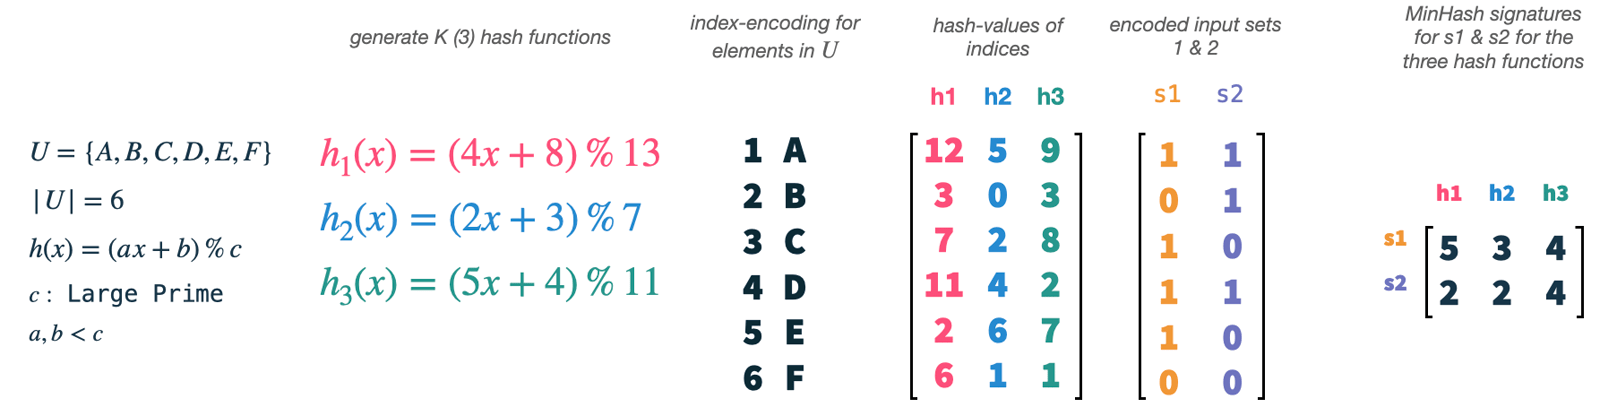
Наша вселенная U имеет размер 6, и мы выбираем K (количество хеш-функций) равным 3. Мы можем легко генерировать новые хэш-функции, используя простую формулу и границы для a, b и c. Теперь, что мы на самом деле делаем, так это хешируем индексы наших векторов (1-6), каждый из которых относится к одному элементу в нашей вселенной, с каждой из наших хеш-функций. Это даст нам 3 случайных перестановки индексов и, следовательно, элементов в нашей вселенной. Впоследствии мы можем взять наши векторы наборов s1 и s2 и использовать их в качестве масок для наших переставленных функций. Для каждой перестановки и набора векторов мы выбираем индекс наименьшего хеш-значения, которое присутствует в наборе. Это даст два трехмерных вектора, по одному для каждого набора, который называется сигнатурой MinHash набора.
MinHashing просто выбирает случайные признаки из входных наборов, а хеш-функции нужны нам только как средство для одинакового воспроизведения этой случайности на всех входных наборах. Мы должны использовать один и тот же набор хеш-функций для всех векторов, чтобы значения сигнатур двух входных наборов сталкивались, если в обоих присутствует выбранный элемент. Значения подписи будут сталкиваться с вероятностью сходства наборов по Жаккару.
WLKNN (нейронная сеть ядра Вайсфейлера-Лемана)
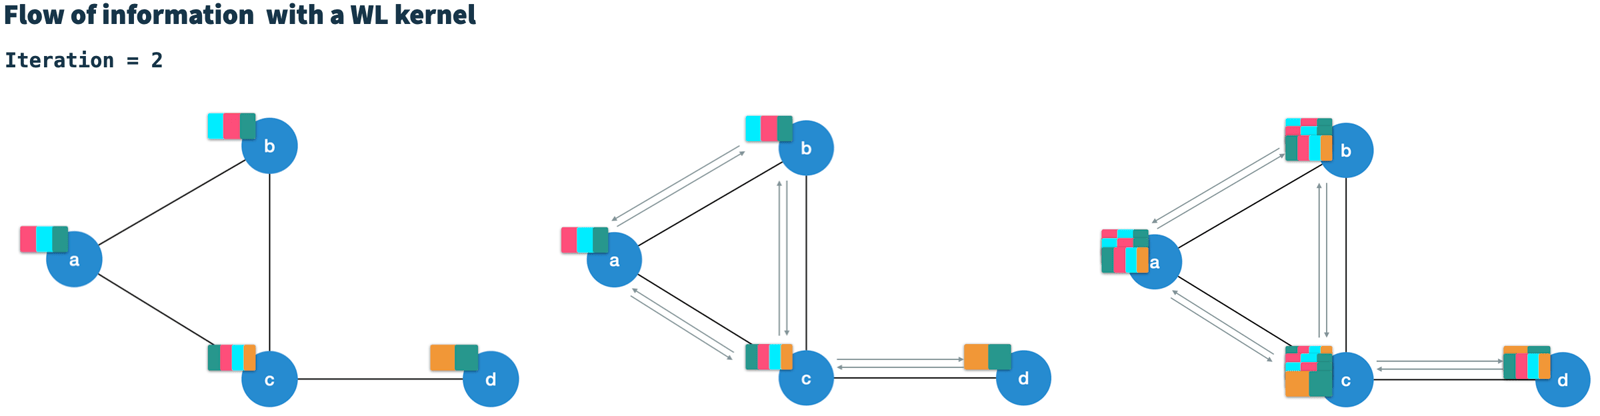
HashGNN использует схему передачи сообщений, определенную в нейронных сетях ядра Вайсфейлера-Лемана (WLKNN), для захвата структуры графа высокого порядка и свойств узла. Он определяет стратегию выборки контекста, как упоминалось ранее для HashGNN. WLK выполняется T итераций. На каждой итерации он генерирует новый вектор узла для каждого узла, комбинируя текущий вектор узла с векторами всех непосредственно связанных соседей. Поэтому считается, что сообщения (векторы узлов) передаются по ребрам к соседним узлам.
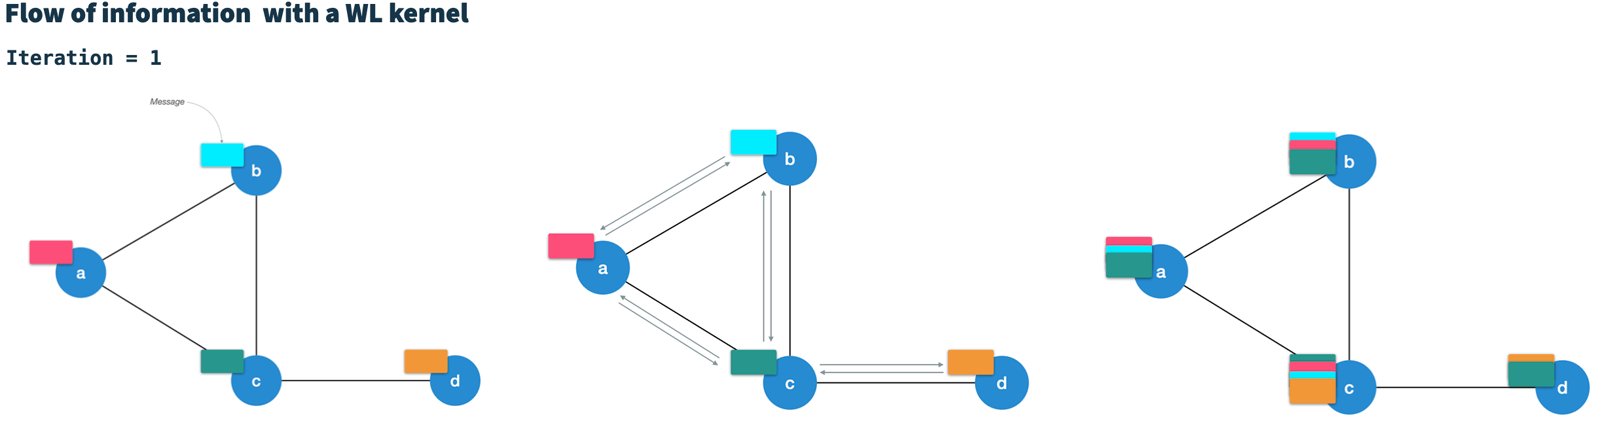
После T итераций каждый узел содержит информацию об узлах на расстоянии T переходов (высокий порядок). Вычисление нового вектора узлов на итерации t по существу объединяет все соседние сообщения (из итерации t-1) в одно соседнее сообщение, а затем объединяет его с вектором узлов предыдущей итерации. Кроме того, WLKNN использует три нейронные сети (весовые матрицы и функцию активации); (i) для агрегированного соседнего вектора, (ii) для узлового вектора и (iii) для их комбинации. Примечательной особенностью WLK является то, что расчет на итерации t зависит только от результата итерации t-1. Следовательно, ее можно считать цепью Маркова.
HashGNN на примере
Давайте рассмотрим, как HashGNN сочетает два подхода для эффективного встраивания векторов графа в встраивание векторов. Как и WLKNN, алгоритм HashGNN работает за T итераций, вычисляя новый вектор узлов для каждого узла путем агрегирования векторов соседей и собственного вектора узлов из предыдущей итерации. Однако вместо обучения трех весовых матриц он использует три схемы хеширования для хеширования с учетом местоположения. Каждая из схем хэширования состоит из K случайно сконструированных хэш-функций для извлечения K случайных признаков из двоичного вектора.
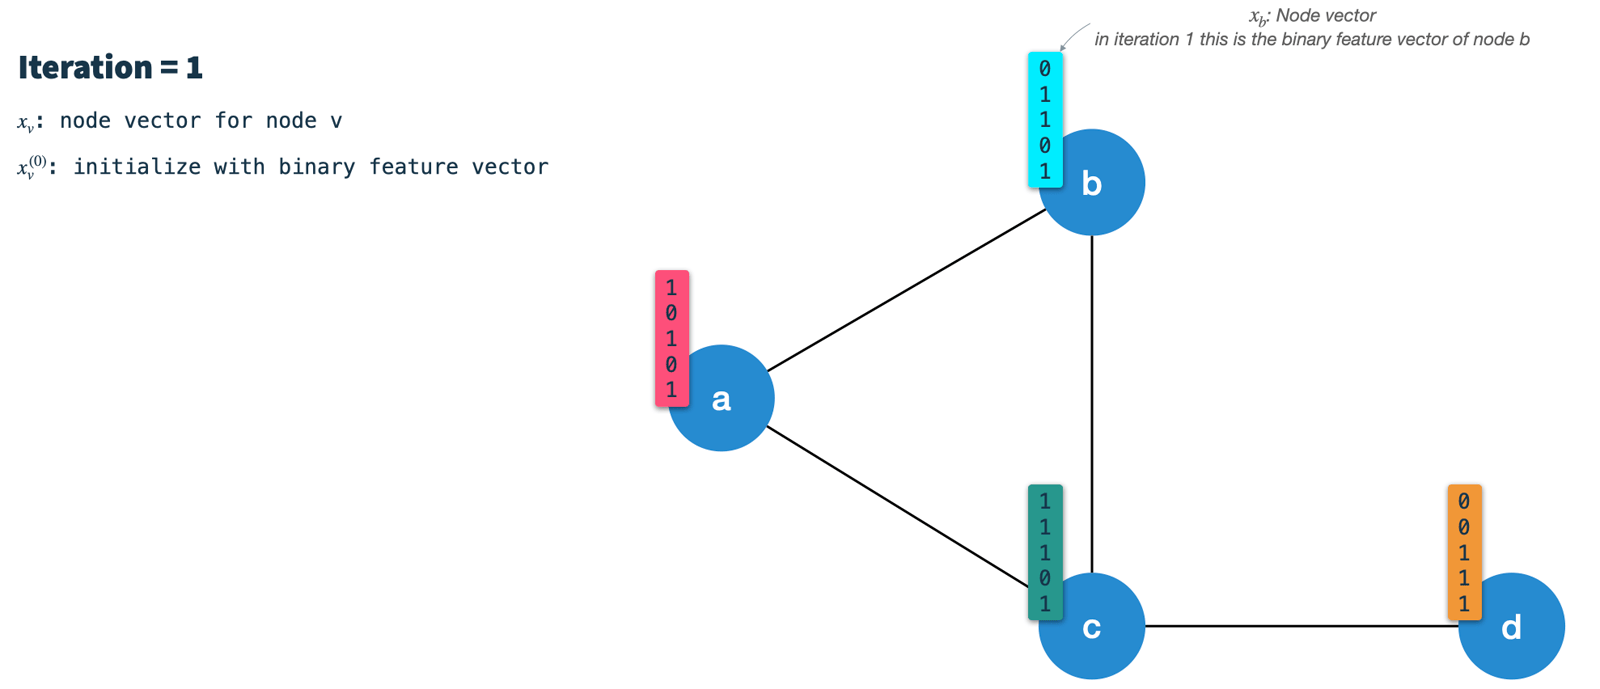
В каждой итерации мы выполняем следующие шаги:
Шаг 1. Вычислите вектор подписи узла: Мин-хеш (случайно выберите K признаков) вектор узла из предыдущей итерации с использованием схемы хеширования 3. В первой итерации узлы инициализируются своими бинарными векторами признаков. (мы поговорим о том, как бинаризировать узлы позже). Результирующий вектор подписи (или сообщения) передается по ребрам всем соседям. Поэтому мы должны сделать это для всех узлов сначала на каждой итерации.
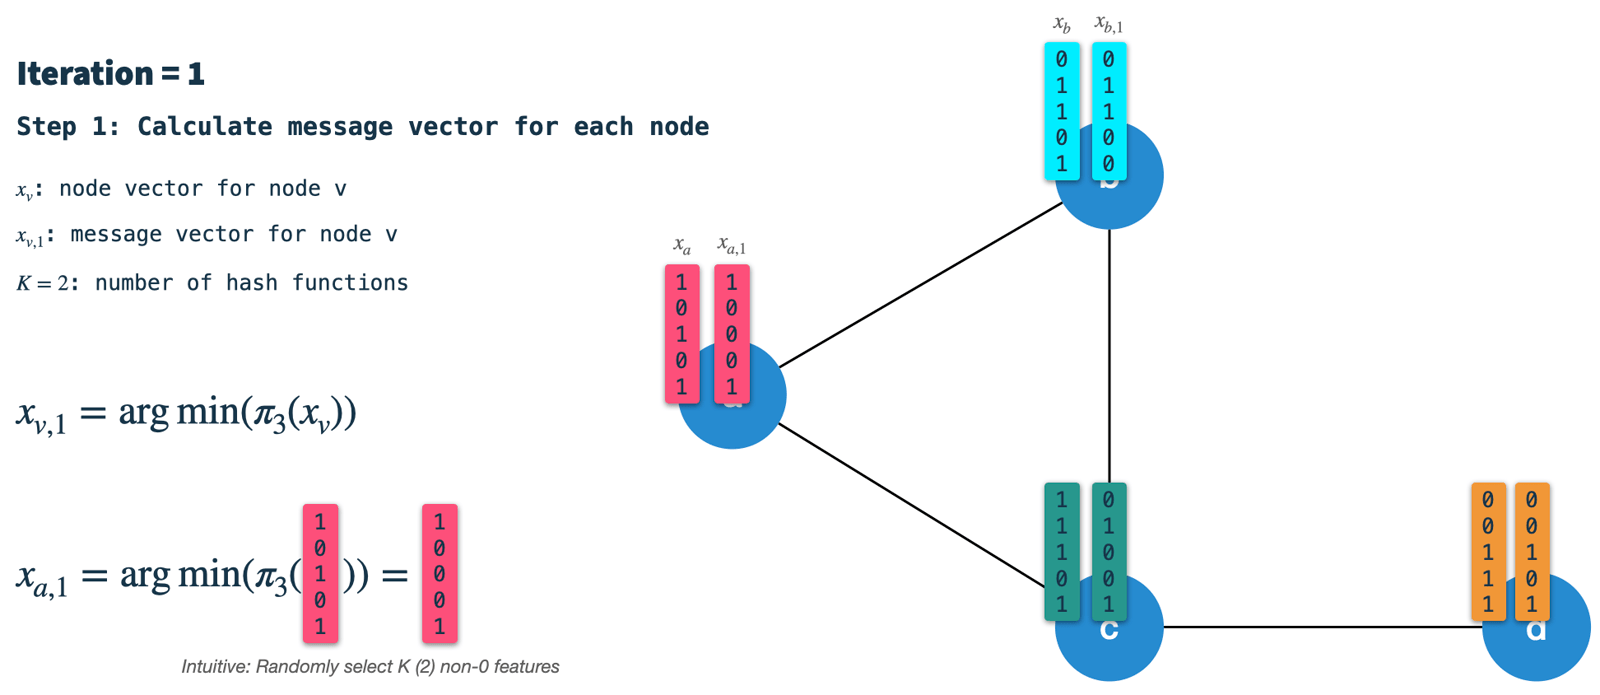
Шаг 2. Создайте вектор соседей. В каждом узле мы получим векторы подписей от всех напрямую подключенных соседей и объединим их в один двоичный вектор. Затем мы используем схему хеширования 2 для выбора K случайных признаков из агрегированного вектора соседей и называем результат вектором соседей.

Шаг 3. Объедините вектор узлов и соседей в новый вектор узлов. Наконец, мы используем схему хеширования 1, чтобы случайным образом выбрать K признаков из вектора узлов предыдущей итерации и объединить результат с вектором соседей. Результирующий вектор является новым вектором узла, который является отправной точкой для следующей итерации. Обратите внимание, что это не то же самое, что и на шаге 1: здесь мы применяем схему хеширования 3 к вектору узла для построения вектора сообщения/подписи.
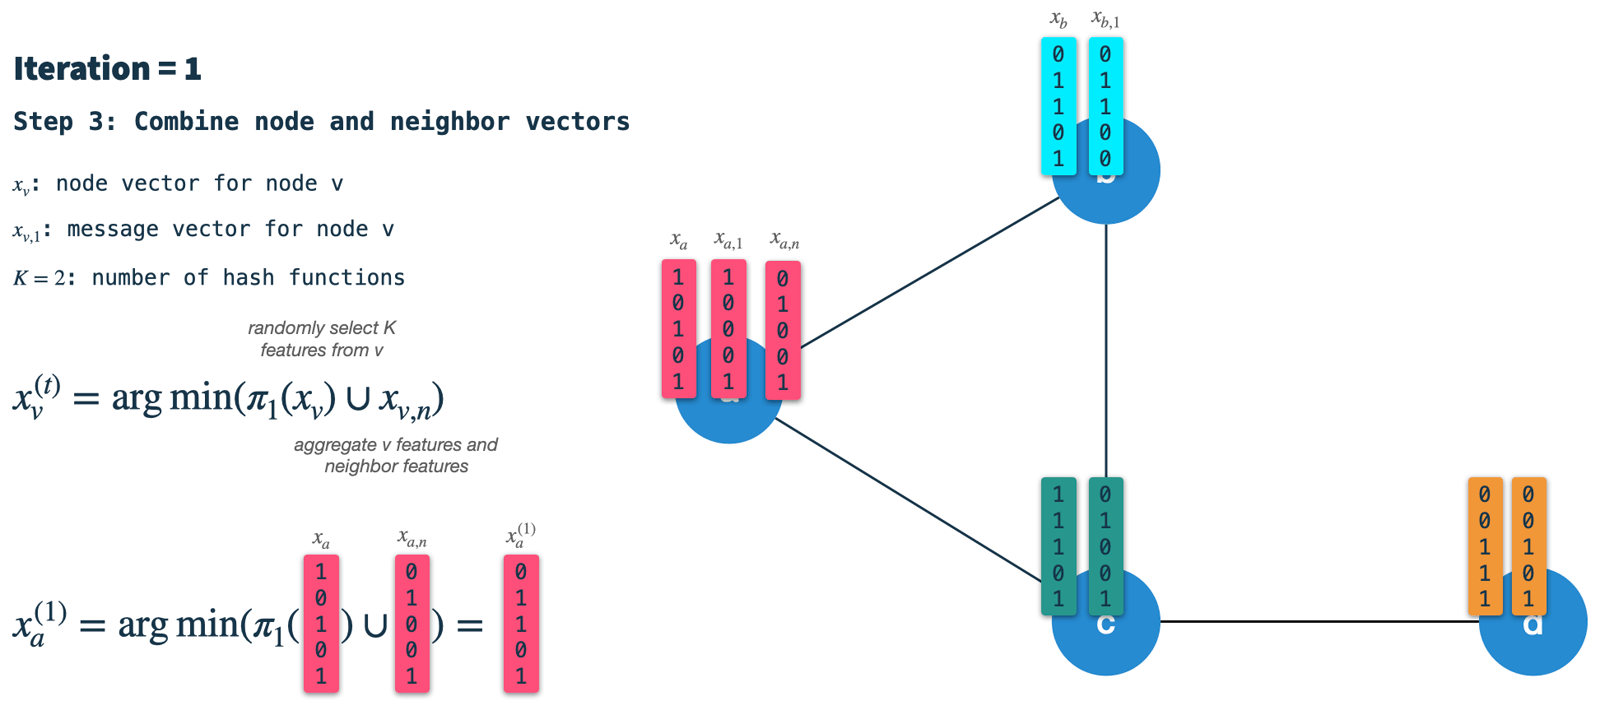
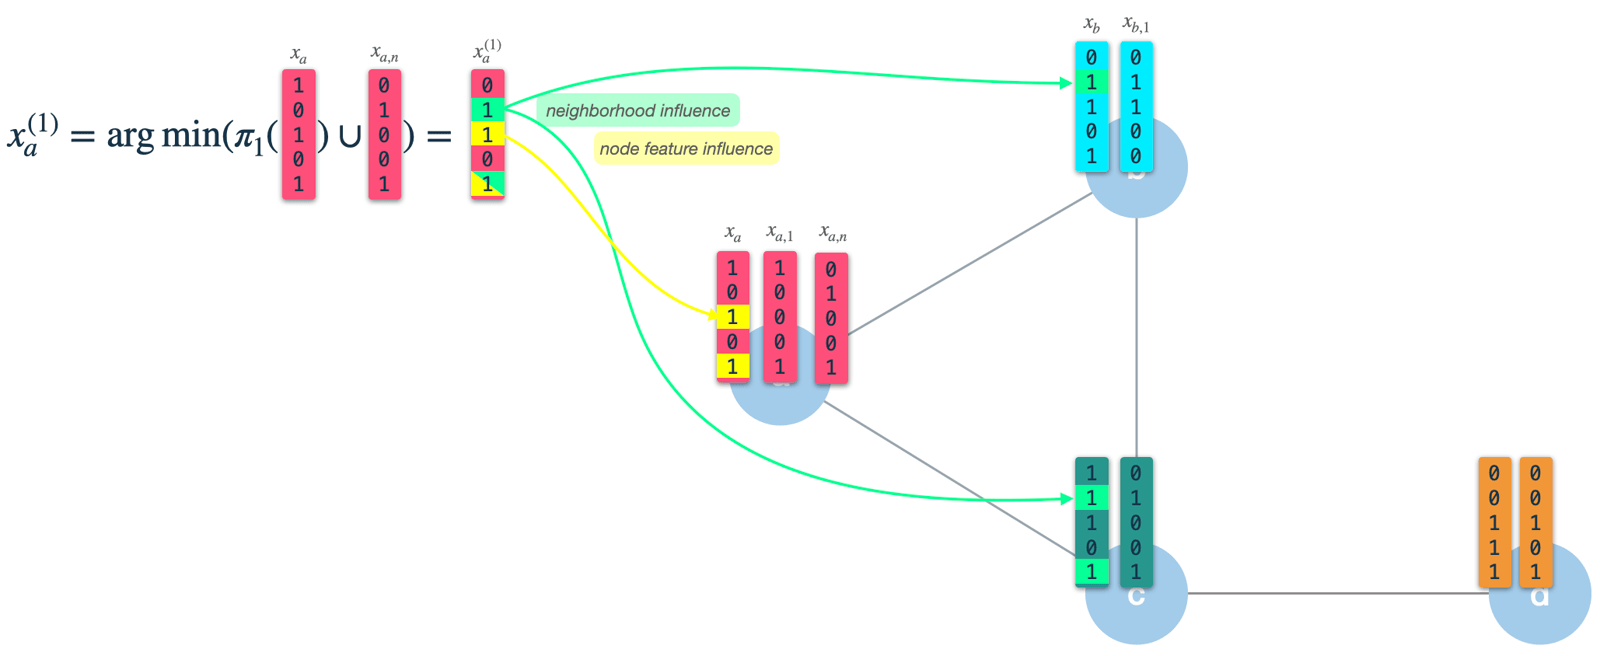
Как мы видим, результирующий (новый) вектор узлов имеет влияние своих собственных признаков узлов (3 и 5), а также признаков его соседей (2 и 5). После итерации 1 вектор узла будет собирать информацию от соседей с расстоянием в 1 скачок. Однако, поскольку мы используем это в качестве входных данных для итерации 2, на него уже будут влиять функции, находящиеся на расстоянии 2 прыжков.
Обобщения Neo4j GDS
HashGNN был реализован Neo4j GDS (Graph Data Science Library) и добавляет к алгоритму некоторые полезные обобщения.
Одним из важных вспомогательных шагов в GDS является бинаризация признаков. MinHashing и, следовательно, HashGNN требуют двоичных векторов в качестве входных данных. Neo4j предлагает дополнительный этап подготовки для преобразования векторов узлов с действительными значениями в векторы бинарных признаков. Они используют метод, называемый округлением гиперплоскости. Алгоритм работы следующий:
Шаг 1. Определите характеристики узла. Определите (действительные) свойства узла, которые будут использоваться в качестве характеристик узла. Это делается с помощью параметра featureProperties. Мы назовем его входным вектором узла f.
Шаг 2. Создайте случайные бинарные классификаторы. Определите одну гиперплоскость для каждого целевого измерения. Количество результирующих измерений контролируется параметром dimensions. Гиперплоскость является многомерной плоскостью и, пока она находится в начале координат, может быть описана исключительно своим вектором нормали n. Вектор n ортогонален поверхности плоскости и поэтому описывает ее ориентацию. В нашем случае вектор n должен иметь ту же размерность, что и входные векторы узла (dim(f) = dim(n)). Чтобы построить гиперплоскость, мы просто рисуем dim(f) раз из распределения Гаусса.
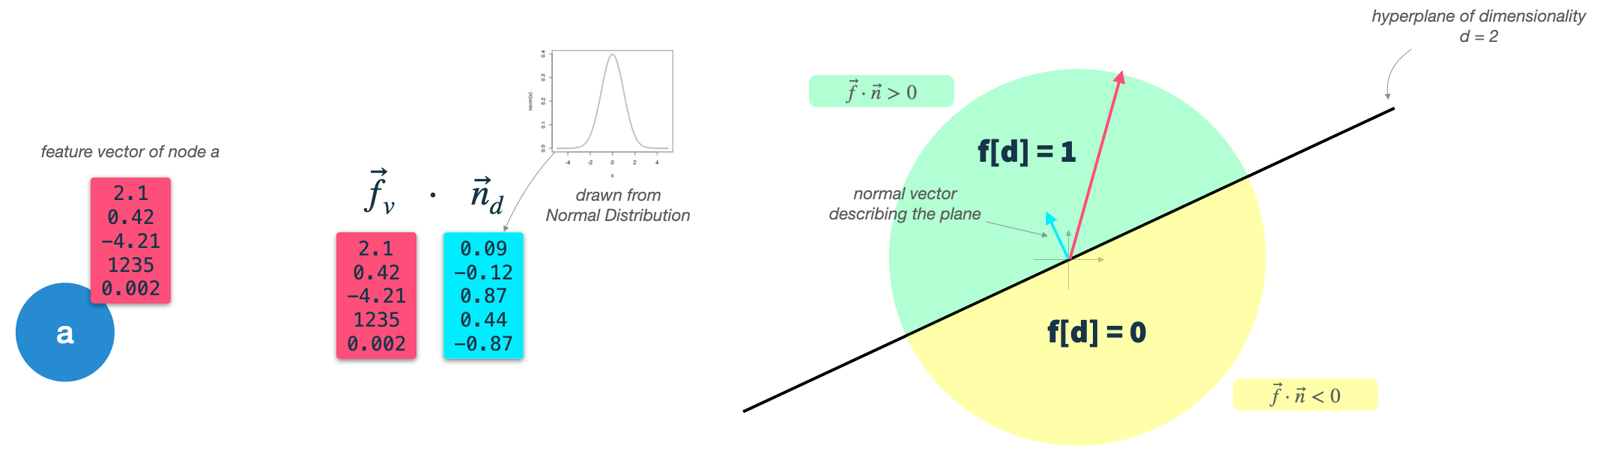
Шаг 3. Классификация векторов узлов. Вычислите скалярное произведение входного вектора узла и каждого вектора гиперплоскости, что дает угол между гиперплоскостью и входным вектором. Используя параметр threshold, мы можем решить, находится ли входной вектор выше (1) или ниже (0) гиперплоскости, и присвоить соответствующее значение результирующему вектору бинарных признаков. Именно это и происходит в бинарной классификации — с той лишь разницей, что мы не итеративно оптимизируем нашу гиперплоскость, а используем случайные гауссовские классификаторы.
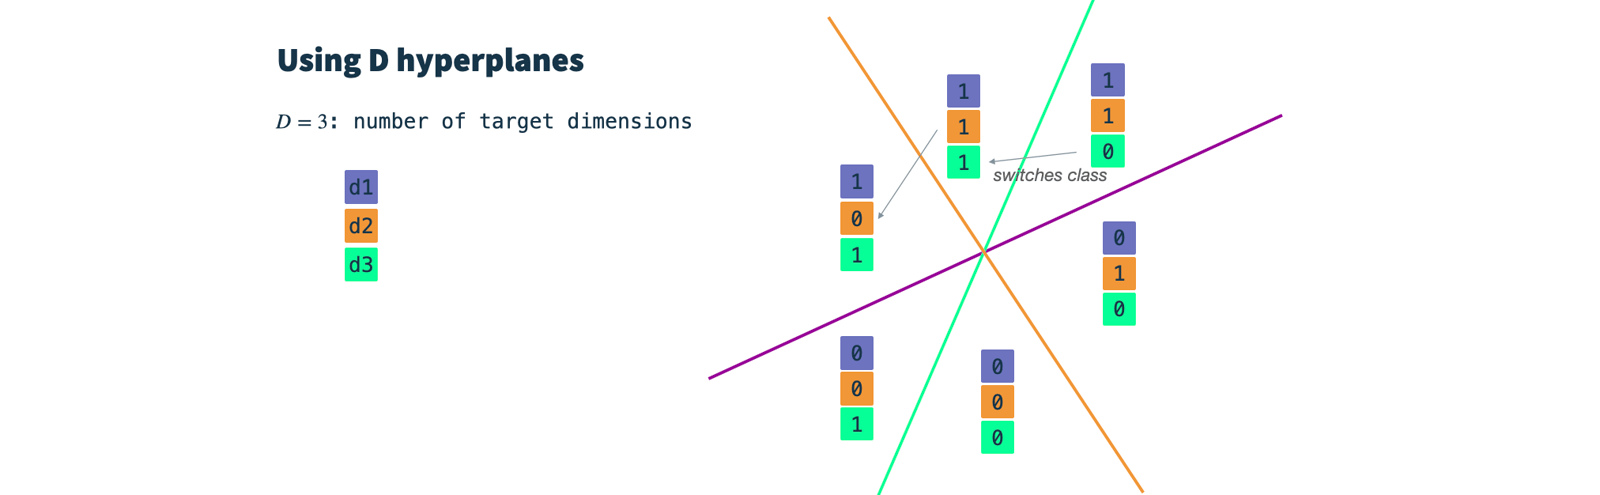
По сути, мы рисуем один случайный гауссовский классификатор для каждого целевого измерения и устанавливаем пороговый параметр. Затем мы классифицируем наши входные векторы для каждого целевого измерения и получаем d-мерный двоичный вектор, который мы используем в качестве входных данных для HashGNN.
Заключение
HashGNN использует хеширование с учетом местоположения для встраивания векторов узлов в пространство встраивания. Используя этот метод, он обходит интенсивное вычислительное итеративное обучение нейронной сети (или другую оптимизацию), а также прямое сравнение узлов. Авторы статьи сообщают о времени выполнения на 2–4 порядка быстрее, чем алгоритмы на основе обучения, такие как SEAL и P-GNN, при этом обеспечивая сопоставимую (в некоторых случаях даже лучшую) точность.
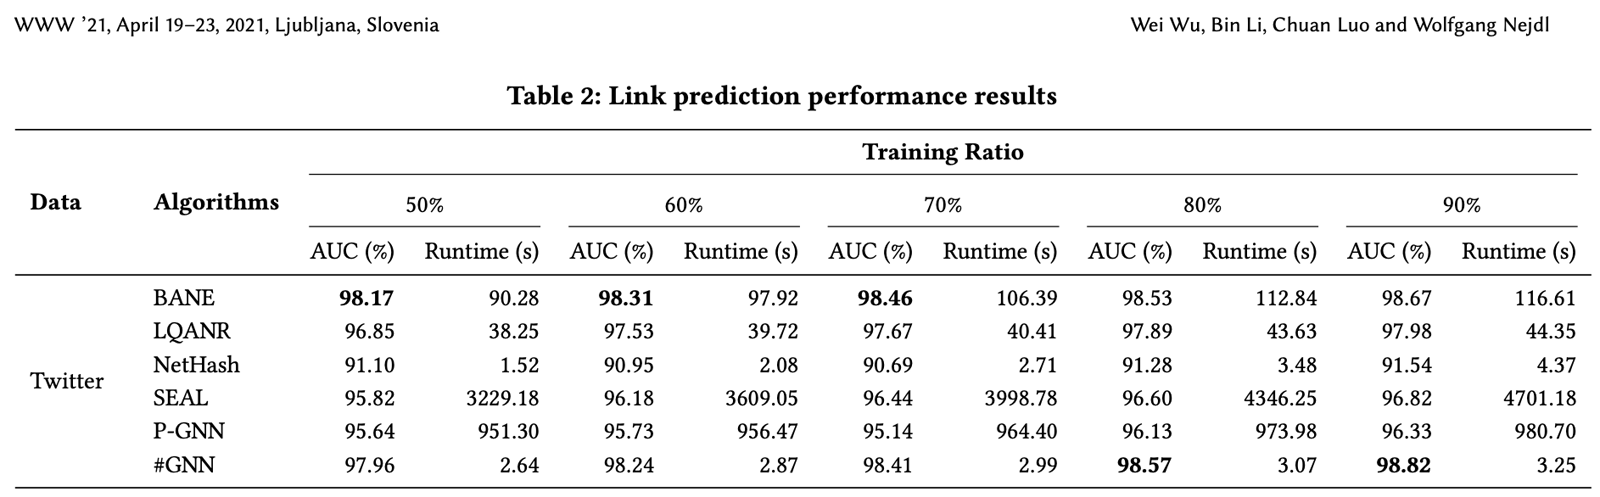
HashGNN реализован в Neo4j GDS (Graph Data Science Library) и поэтому может быть готов к использованию на вашем графике Neo4j. В следующем посте я подробно расскажу о том, как его использовать и о чем следует помнить.
Спасибо, что заглянули и увидимся в следующий раз. 🚀
