Используйте GPT-4 в качестве эксперта в предметной области, чтобы извлечь информацию из стенограммы видео.
Пару дней назад я получил доступ к GPT-4.
Первое, что пришло мне в голову, — проверить, насколько хорошо она работает в качестве модели извлечения информации, где задача состоит в извлечении соответствующих сущностей и отношений из заданного текста.
Я уже немного поигрался с GPT-3.5. Самое важное, что я заметил, это то, что мы не хотим использовать конечную точку GPT в качестве решения для связывания сущностей или придумывать какие-либо другие внешние ссылки, такие как цитаты, поскольку он любит галлюцинировать эти типы информация.
Однако преимущество GPT-3 или GPT-4 заключается в том, что они хорошо работают в различных областях. Например, мы можем использовать его для извлечения людей, организаций или мест из текста.
Однако я чувствую, что конкурировать со специализированными моделями НЛП — не то, в чем модели GPT блестят (хотя они работают хорошо). Вместо этого сила моделей GPT заключается в их способности обобщать и использовать в других областях, где другие модели с открытым исходным кодом терпят неудачу из-за ограниченных обучающих данных.
Мой друг Michael Hunger подал мне прекрасную идею протестировать GPT-4 на извлечении информации из документального фильма о природе.
Мне всегда нравился документальный фильм о морских глубинах, так как экосистема и животные сильно отличаются от наземных. Поэтому я решил проверить возможности извлечения информации GPT-4 на подводном документальном фильме. Кроме того, я не знаю ни одной модели NLP с открытым исходным кодом, обученной обнаруживать отношения между морскими растениями и существами. Таким образом, документальный фильм о морских глубинах является отличным примером использования GPT-4 для построения графа знаний.
Весь код доступен на GitHub в виде Jupyter Notebook.
Набор данных
Самым доступным местом для поиска документальных фильмов является YouTube. Хотя GPT-4 является мультимодальным (поддерживает видео, аудио и текст), текущая версия конечной точки поддерживает только ввод текста. Поэтому мы будем анализировать аудиозапись видео, а не само видео.
Мы будем анализировать стенограмму следующего документального фильма.
Прежде всего, мне нравится тема документального фильма: Захватывающий подводный мир коралловых рифов.»
Во-вторых, извлечь субтитры из видео на YouTube совсем несложно, поскольку нам вообще не нужно использовать какие-либо модели audio2text. Однако преобразование аудио в текст со всеми доступными моделями HuggingFace или даже Whisper от OpenAI не должно быть большой проблемой.
В-третьих, субтитры к этому видео не создаются автоматически. Сначала я пытался извлечь информацию из автоматически сгенерированных титров на YouTube, но понял, что они могут быть не лучшим исходным материалом. Поэтому, если можете, избегайте использования автоматически создаваемых субтитров YouTube.
Субтитры можно легко получить с помощью YouTube Transcript/Subtitle library. Все, что нам нужно сделать, это указать идентификатор видео.
from youtube_transcript_api import YouTubeTranscriptApi

video_id = "nrI483C5Tro"
transcript = YouTubeTranscriptApi.get_transcript(video_id)
print(transcript[:5])
Выписка имеет следующую структуру.
[
   {
      "text":"water the liquid that oceans are made of",
      "start":5.46,
      "duration":4.38
   },
   {
      "text":"and it fills endless depths only few will venture\\xa0\\xa0",
      "start":12.24,
      "duration":4.92
   },
   {
      "text":"out into the endless open ocean\\xa0\nof this vast underwater world",
      "start":17.16,
      "duration":4.68
   }
]
Субтитры разбиты на фрагменты, которые можно использовать в качестве субтитров к видео. Таким образом, информация о начале и продолжительности предоставляется вместе с текстом. Вы также можете заметить пару специальных символов, таких как \xa0 и \n.
Несмотря на то, что конечная точка GPT-4 поддерживает до 8 000 токенов на запрос, требуется больше для обработки всей расшифровки в одном запросе. Поэтому нам необходимо разделить расшифровку на несколько частей.
Итак, я решил разделить стенограмму на несколько частей, где конец части определяется, когда пять или более секунд отсутствуют субтитры, объявляя о короткой паузе в повествовании. Используя этот подход, я стремлюсь объединить весь связующий текст и сохранить соответствующую информацию в одном разделе.
Я использовал следующий код, чтобы сгруппировать стенограмму в несколько разделов.
# Split into sections and include start and end timestamps
sections = []
current_section = ""
start_time = None
previous_end = 0
pause_threshold = 5

for line in transcript:
    if current_section and (line["start"] - previous_end > pause_threshold):
        # If there is a pause greater than 5s, we deem the end of section
        end_time = line["start"]
        sections.append(
            {
                "text": current_section.strip(),
                "start_time": start_time,
                "end_time": end_time,
            }
        )
        current_section = ""
        start_time = None
    else:
        # If this is the start of a new section, record the start time
        if not start_time:
            start_time = line["start"]

        # Add the line to the current paragraph
        clean_text = line["text"].replace("\n", " ").replace("\xa0", " ")
        current_section += " ".join(clean_text.split()) + " "
        # Tag the end of the dialogue
        previous_end = line["start"] + line["duration"]

# If there's a paragraph left at the end, add it to the list of paragraphs
if current_section:
    end_time = transcript[-1]["start"] + transcript[-1]["duration"]
    sections.append(
        {
            "text": current_section.strip().replace("\n", " ").replace("\xa0", " "),
            "start_time": start_time,
            "end_time": end_time,
        }
    )
# Remove empty paragraphs
sections = [p for p in sections if p["text"]]
Для оценки результатов группировки разделов я напечатал следующую информацию.
# Number of paragraphs
print(f"Number of paragraphs: {len(sections)}")
print(f"Max characters per paragraph: {max([len(el['text']) for el in sections])}")
Всего 77 разделов, самый длинный из которых содержит 1267 символов. Мы далеки от предела токенов GPT-4, и я думаю, что описанный выше подход обеспечивает хорошую детализацию текста, по крайней мере, в этом примере.
Извлечение информации с помощью GPT-4
Конечная точка GPT-4 оптимизирована для чата, но хорошо подходит для традиционных задач завершения. Поскольку модель оптимизирована для разговора, мы можем предоставить системное сообщение, которое помогает настроить поведение помощника вместе с любыми предыдущими сообщениями, которые могут помочь сохранить контекст диалога. Однако, поскольку мы используем конечную точку GPT-4 для задачи завершения текста, мы не будем предоставлять какие-либо предыдущие сообщения.
Я использовал следующую подсказку в качестве системного сообщения.
system = "You are an archeology and biology expert helping us extract relevant information."
Однако я заметил, что модель вела себя почти одинаково, когда я предоставлял системное сообщение или нет. Затем я разработал следующую подсказку через несколько итераций, которая извлекает соответствующие сущности и отношения из заданного текста.
# Set up the prompt for GPT-3 to complete
prompt = """#This a transcript from a sea documentary.
#The task is to extract as many relevant entities to biology, chemistry, or archeology.
#The entities should include all animals, biological entities, locations.
#However, the entities should not include distances or time durations.
#Also, return the type of an entity using the Wikipedia class system and the sentiment of the mentioned entity,
#where the sentiment value ranges from -1 to 1, and -1 being very negative, 1 being very positive
#Additionally, extract all relevant relationships between identified entities.
#The relationships should follow the Wikipedia schema type.
#The output of a relationship should be in a form of a triple Head, Relationship, Tail, for example
#Peter, WORKS_AT, Hospital/n
# An example "St. Peter is located in Paris" should have an output with the following format
entity
St. Peter, person, 0.0
Paris, location, 0.0

relationships
St.Peter, LOCATED_IN, Paris\n"""
GPT-4 предлагается извлечь соответствующие объекты из заданного текста. Кроме того, я добавил некоторые ограничения, согласно которым расстояния и продолжительность времени не должны рассматриваться как сущности. Извлеченные сущности должны содержать свое имя, тип и тональность. Что касается отношений, то они должны быть представлены в виде тройки. Я добавил несколько намеков на то, что модель должна следовать типу схемы Википедии, что сделало извлеченные типы отношений более стандартизированными. Я узнал, что всегда полезно предоставить пример вывода. В противном случае модель может по желанию использовать разные форматы вывода.
Следует отметить, что мы могли дать указание модели предоставить нам хорошее представление извлеченных сущностей и отношений в формате JSON. Хорошо структурированные данные, безусловно, могут быть плюсом. Тем не менее, вы платите цену за хорошо структурированные объекты JSON, поскольку стоимость API рассчитывается на основе количества входных и выходных токенов. Таким образом, шаблон JSON имеет свою цену.
Далее нам нужно определить функцию, которая вызывает конечную точку GPT-4 и обрабатывает ответ.
@retry(tries=3, delay=5)
def process_gpt4(text):
    paragraph = text

    completion = openai.ChatCompletion.create(
        model="gpt-4",
        # Try to be as deterministic as possible
        temperature=0,
        messages=[
            {"role": "system", "content": system},
            {"role": "user", "content": prompt + paragraph},
        ],
    )

    nlp_results = completion.choices[0].message.content

    if not "relationships" in nlp_results:
        raise Exception(
            "GPT-4 is not being nice and isn't returning results in correct format"
        )

    return parse_entities_and_relationships(nlp_results)
Несмотря на то, что мы явно определили формат вывода в подсказке, модель GPT-4 иногда ведет себя по-своему и не следует правилам. Со мной это случилось всего два раза из пары сотен запросов. Однако это раздражает, когда это происходит, и весь нисходящий поток данных не работает должным образом. Поэтому я добавил простую проверку ответа и добавил декоратор повторных попыток на случай, если это произойдет.
Кроме того, я добавил параметр temperature только для того, чтобы модель вела себя как можно более детерминированно. Однако, когда я повторно прогнал стенограмму пару раз, я получил несколько иные результаты. Обработка стенограммы выбранного видео с помощью GPT-4 стоит около 1,6 доллара США.
Графическая модель и импорт
Мы будем использовать Neo4j для хранения результатов конвейера извлечения информации. Я использовал бесплатный экземпляр Neo4j Sandbox для этого проекта, но вы также можете использовать AuraDB Free или локальную среду рабочего стола.
Одно можно сказать наверняка. Ни одна модель НЛП не идеальна. Поэтому мы хотим, чтобы все извлеченные сущности и отношения указывали на текст, из которого они были извлечены, что позволяет при необходимости проверить достоверность информации.
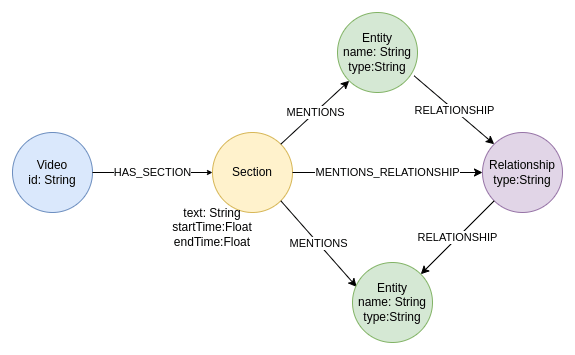
Поскольку мы хотим указать извлеченным объектам и отношениям соответствующий текст, нам нужно включить разделы вместе с видео в наш график. Узлы раздела содержат текст, время начала и окончания. Затем сущности и отношения подключаются к узлам раздела. Что может показаться нелогичным, так это то, что мы представляем извлеченные отношения как узел на нашем графике. Причина в том, что Neo4j не позволяет иметь отношения, указывающие на другие отношения. Однако мы хотим иметь связь между извлеченным отношением и его исходным текстом. Поэтому нам нужно смоделировать извлеченную связь как отдельный узел.
Оператор Cypher для импорта графа выглядит следующим образом:
import_query = """
MERGE (v:Video {id:$videoId})
CREATE (v)-[:HAS_SECTION]->(p:Section)
SET p.startTime = toFloat($start),
    p.endTime = toFloat($end),
    p.text = $text
FOREACH (e in $entities |
  MERGE (entity:Entity {name: e[0]})
  ON CREATE SET entity.type = e[1]
  MERGE (p)-[:MENTIONS{sentiment:toFloat(e[2])}]->(entity))
WITH p
UNWIND $relationships AS relation
MERGE (source:Entity {name: relation[0]})
MERGE (target:Entity {name: relation[2]})
MERGE (source)-[:RELATIONSHIP]->(r:Relationship {type: relation[1]})-[:RELATIONSHIP]->(target)
MERGE (p)-[mr:MENTIONS_RELATIONSHIP]->(r)
"""
Наконец, мы можем продолжить обработку всей стенограммы и импортировать извлеченную информацию в Neo4j, используя следующий код:
with driver.session() as session:
    for i, section in enumerate(sections):
        print(f"Processing {i} paragraph")
        text = section["text"]
        start = section["start_time"]
        end = section["end_time"]
        entities, relationships = process_gpt4(text)
        params = {
            "videoId": video_id,
            "start": start,
            "end": end,
            "text": text,
            "entities": entities,
            "relationships": relationships,
        }
        session.run(import_query, params)
Вы можете открыть браузер Neo4j и проверить импорт, выполнив следующую инструкцию Cypher.
CALL apoc.meta.graph()
Процедура метаграфа должна возвращать следующую визуализацию графа.

Устранение неоднозначности сущностей с помощью GPT-4
Изучив результаты GPT-4, я решил, что лучше всего выполнить простое устранение неоднозначности сущностей. Например, в настоящее время существует пять различных узлов для мурены:
- мурена
- мурена
- мурена угорь
- мурена
- мурены
Мы могли бы использовать строчные буквы для всех объектов и использовать различные методы НЛП, чтобы определить, какие узлы относятся к одним и тем же объектам. Однако мы также можем использовать конечную точку GPT-4 для устранения неоднозначности объектов. Я написал следующее приглашение для устранения неоднозначности сущности.
disambiguation_prompt = """
#Act as a entity disambiugation tool and tell me which values reference the same entity.
#For example if I give you
#
#Birds
#Bird
#Ant
#
#You return to me
#
#Birds, 1
#Bird, 1
#Ant, 2
#
#As the Bird and Birds values have the same integer assigned to them, it means that they reference the same entity.
#Now process the following values\n
"""
Идея состоит в том, чтобы присвоить одинаковые целые числа узлам, которые относятся к одному и тому же объекту. Используя это приглашение, мы можем пометить все узлы дополнительными свойствами устранения неоднозначности.
def disambiguate(entities):
    completion = openai.ChatCompletion.create(
        model="gpt-4",
        # Try to be as deterministic as possible
        temperature=0,
        messages=[
            {"role": "user", "content": disambiguation_prompt + "\n".join(all_animals)},
        ],
    )

    disambiguation_results = completion.choices[0].message.content
    return [row.split(", ") for row in disambiguation_results.split("\n")]

all_animals = run_query("""
MATCH (e:Entity {type: 'animal'})
RETURN e.name AS animal
""")['animal'].to_list()


disambiguation_params = disambiguate(all_animals)
run_query(
    """
UNWIND $data AS row
MATCH (e:Entity {name:row[0]})
SET e.disambiguation = row[1]
""",
    {"data": disambiguation_params},
)
Теперь, когда информация об устранении неоднозначности находится в базе данных, мы можем использовать ее для оценки результатов.
MATCH (e:Entity {type:"animal"})
RETURN e.disambiguation AS i, collect(e.name) AS entities
ORDER BY size(entities) DESC
LIMIT 5
Результаты
Хотя это устранение неоднозначности не так уж сложно, все же стоит отметить, что мы можем добиться этого без знания НЛП или разработки каких-либо правил, созданных вручную.
Анализ
На последнем этапе этого сообщения в блоге мы оценим результаты конвейера извлечения информации с использованием модели GPT-4.
Сначала мы рассмотрим тип и количество извлеченных сущностей.
MATCH (e:Entity)
RETURN e.type AS type, count(*) AS count
ORDER BY count DESC
LIMIT 5
Результаты
Большинство сущностей — это животные, места и биологические сущности. Однако мы можем заметить, что иногда модель решает использовать пробелы, а иногда подчеркивание для биологических объектов.
В ходе моих экспериментов с конечными точками GPT я заметил, что лучший подход — максимально точно определить, какую информацию и как вы хотите классифицировать. Поэтому в GPT-4 рекомендуется определять типы сущностей, которые мы хотим извлечь, поскольку результирующие типы будут более согласованными.
Кроме того, модель не классифицировала 33 типа сущностей. Дело в том, что GPT-4 может придумать какие-то типы для этих сущностей, если их попросят. Однако они появляются только в части результатов извлечения отношений, где типы сущностей не запрашиваются. Одним из обходных путей может быть запрос типов сущностей в части извлечения отношений.
Далее мы рассмотрим, какие животные больше всего упоминаются в видео.
MATCH (e:Entity {type:"animal"})
RETURN e.name AS entity, e.type AS type,
       count{(e)<-[:MENTIONS]-()} AS mentions
ORDER BY mentions DESC
LIMIT 5
Результаты
Наиболее упоминаемыми животными являются мурены, крылатки и офиуры. Я знаком только с угрями, поэтому посмотреть документальный фильм, чтобы узнать о других рыбах, может быть хорошей идеей.
Мы также можем оценить, какие отношения или факты были извлечены в отношении мурен.
MATCH (e:Entity {name:"morays"})-[:RELATIONSHIP]->(r)-[:RELATIONSHIP]->(target)
RETURN e.name AS source, r.type AS relationship, target.name AS target,
       count{(r)<-[:MENTIONS_RELATIONSHIP]-()} AS mentions
UNION ALL
MATCH (e:Entity {name:"morays"})<-[:RELATIONSHIP]->(r)<-[:RELATIONSHIP]-(source)
RETURN source.name AS source, r.type AS relationship, e.name AS target,
       count{(r)<-[:MENTIONS_RELATIONSHIP]-()} AS mentions
Результаты
Мы можем многое узнать о муренах. Они сотрудничают с морскими окунями, сосуществуют со спинорогами и чистятся креветками-чистильщиками. Кроме того, мурена, ищущая самку мурены, может иметь отношение.
Допустим, мы хотим проверить, верна ли взаимосвязь взаимодействия мурены с крылаткой. Мы можем получить исходный текст и проверить утверждение вручную.
MATCH (e:Entity)-[:RELATIONSHIP]->(r)-[:RELATIONSHIP]->(t:Entity)
WHERE e.name = "morays" AND r.type = "INTERACTS_WITH" AND t.name = "Lionfish"
MATCH (r)<-[:MENTIONS_RELATIONSHIP]-(s:Section)
RETURN s.text AS text
Результаты
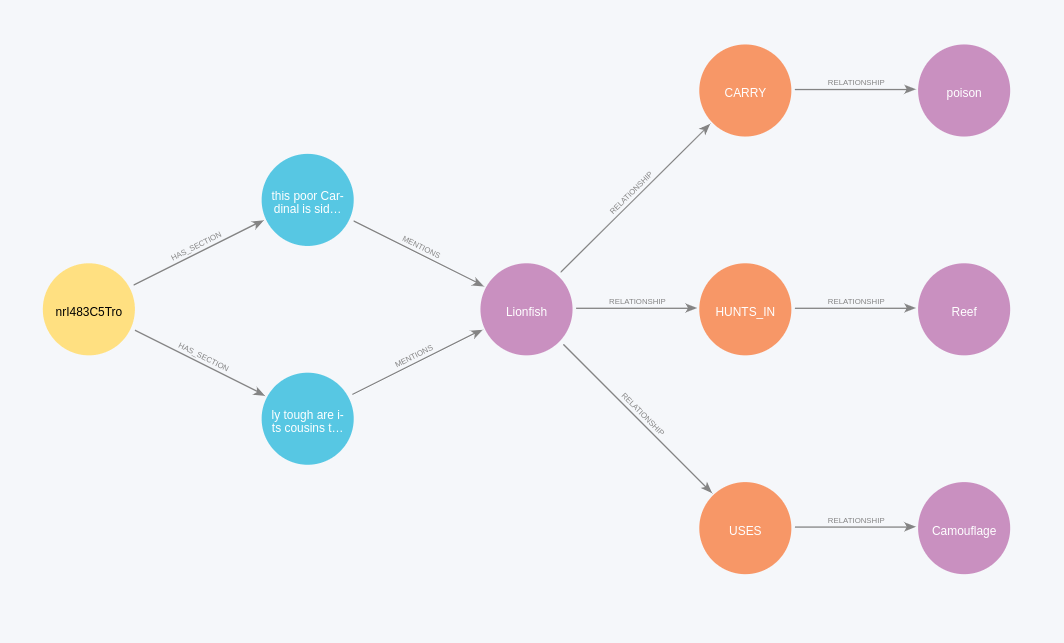
ly tough are its cousins the scorpion fishes they
lie there as if dead especially when others around
them freak out and even when moray eels fight with lionfishes for food
В тексте упоминается, что угри борются за пищу с крылатками. Мы также можем заметить, что расшифровка трудна для чтения и понимания даже человеком. Таким образом, мы можем похвалить GPT-4 за хорошую работу над стенограммой, с которой даже человек может столкнуться с трудностями.
Наконец, мы можем использовать граф знаний в качестве поисковой системы, которая возвращает временные метки разделов, в которых мы хотим видеть соответствующие объекты. Так, например, мы можем попросить базу данных вернуть все временные метки разделов, в которых упоминается крылатка.
MATCH (e:Entity {name:"Lionfish"})<-[:MENTIONS]-(s:Section)<-[:HAS_SECTION]-(v:Video)
RETURN s.startTime AS timestamp, s.endTime AS endTime,
       "https://youtube.com/watch?v=" + v.id + "&t=" + toString(toInteger(s.startTime)) AS URL
ORDER BY timestamp
Результаты
Краткое содержание
Замечательная способность моделей GPT-3.5 и GPT-4 обобщать различные области является мощным инструментом для изучения и анализа различных наборов данных для извлечения соответствующей информации. Честно говоря, я не совсем уверен, какую конечную точку я бы использовал для воссоздания этого сообщения в блоге без GPT-4. Насколько мне известно, моделей извлечения отношений или наборов данных о морских существах с открытым исходным кодом не существует. Поэтому, чтобы избежать хлопот с маркировкой набора данных и обучением пользовательской модели, мы можем просто использовать конечную точку GPT. Кроме того, я с нетерпением ожидаю возможности изучить обещанные возможности мультимодального анализа на основе ввода аудио или текста.
Как всегда, код доступен на GitHub.
