Первый шаг к созданию баз данных графов — максимально точная разработка модели данных графа. В этом блоге обсуждаются шаги, необходимые командам для эффективного создания графовой модели данных и создания основы для логических и осмысленных запросов и анализа в рабочей графовой базе данных.
Концептуальная модель
Дэйв Бехбергер и Джош Перриман напоминают нам, что концептуальная модель — это инструмент для передачи требований между бизнесом/конечными пользователями и разработчиками. Концептуальная модель служит предшественником графовой модели, описывая элементы в понятных терминах как для бизнеса, так и для конечных пользователей.
Бехбергер и Перриман в «Графических базах данных в действии» описывают термины концептуальной модели следующим образом: [1]
- Сущность. Обычно представленные существительными, сущности описывают вещи или типы вещей в домене (например, транспортные средства, пользователи или географические местоположения).
- Отношения. Часто представленные глаголами (или словесными фразами), отношения описывают, как сущности взаимодействуют друг с другом. Это может быть что-то вроде «движется», например, «автомобиль движется к определенному месту», или «друзья», как в значении этого слова в Facebook в качестве глагола (например, «человек дружит с другим человеком»).
- Атрибут. Аналогично объектам, также представленным существительным, но всегда в контексте объекта или отношения. Атрибуты описывают качество объекта или отношения.
- Шаблон доступа — описывает либо вопросы, либо методы взаимодействия в предметной области. Примерами могут быть такие вопросы, как «Куда движется этот автомобиль?» или Кто друзья этого человека?
Логическая модель
Важно отметить, что они будут переведены в термины, относящиеся к графам, для технической реализации базы данных графов. Существует несколько источников баз данных графов; термины, используемые для определения элементов базы данных графа, могут различаться в зависимости от источника. В дальнейшем в этом блоге будут использоваться термины, определенные Amazon Neptune.
База данных графа включает ряд элементов, включая вершины, ребра, метки (как для вершин, так и для ребер) и свойства. Основными элементами графовой базы данных являются вершины и ребра. Проще говоря, это точки или узлы графа и линии (ребра), соединяющие эти точки. Если мы представим взаимодействие между вершинами и ребрами как предложение, вершины — это существительные, а ребра — это глаголы, действующие на эти существительные. Продолжая аналогию с предложениями, мы можем рассматривать метки и свойства как дескрипторы наших вершин и ребер, точно так же, как прилагательные и наречия описывают существительные и глаголы в предложениях [2], [3], [4].
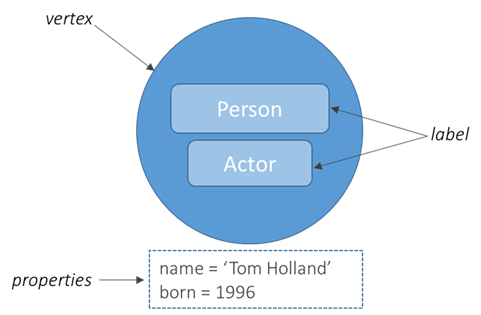
Вершины — это один из двух фундаментальных элементов, образующих граф (другой фундаментальный элемент — отношения). Каждый узел представляет сущность (человека, место, вещь, категорию или другой элемент данных). Узлы также могут представлять другие компоненты предметной области, в зависимости от варианта использования.метка – это конструкция именованного графа, которая группирует или классифицирует узлы в наборы; все узлы, помеченные одной и той же меткой, принадлежат одному и тому же множеству. Узлы могут иметь ноль или более меток для определения (классификации), к какому типу узлов они относятся. Например, узел может быть помечен как человек и как действующее лицо. [2], [3]
Ребра описывают, как связаны две вершины, исходная вершина и целевая вершина, и позволяют обнаруживать связанные вершины в данных. Учитывая, что мы используем термины и модели данных, определенные Amazon Neptune, границы являются однонаправленными; каждое ребро имеет только одно направление. Одно направление от исходной вершины к целевой вершине. Подобно меткам для вершин, ребра должны иметь метку, чтобы классифицировать связь между исходной вершиной и целевой вершиной. [4]

И вершины, и ребра могут иметь свойства (пары "ключ-значение"), которые позволяют хранить в модели данных дополнительную соответствующую информацию. Свойства часто можно определить, зная, какие вопросы необходимо задать данным, чтобы ответить на ваш вариант использования. Например: «В каком году родился Том Холланд?» или «Кто старше, Том Холланд или Эндрю Гарфилд?» Эти вопросы определяют потребность в свойстве born: в вершине, помеченной как человек и актер. (См. пример ниже на рис. 1.) Теперь, если еще один вопрос, на который мы хотим ответить, заключается в том, какой человек/актер действовал в конкретном фильме, ребро будет проходить от исходной вершины, помеченной человеком и актером, к целевой вершине фильма. На рис. 2 показано, как эта связь будет выглядеть в графовой базе данных. [2], [3]
Краткое содержание
В зависимости от характера моделируемых данных графовые базы данных потенциально могут использовать все преимущества связности данных. Вместо того, чтобы запускать несколько объединений за соединениями в реляционной базе данных, чтобы иметь связь данных между таблицами, графовые базы данных обрабатывают интенсивные связи данных с улучшенной производительностью. Моделирование с помощью графов или размышление об отношениях с точки зрения графа является естественным и интуитивно понятным. Графовые базы данных также предлагают гораздо более гибкую схему; графовые модели данных могут быть легко изменены и обновлены по сравнению с жесткостью и строгостью реляционных баз данных. Наряду с гибкостью графовые базы данных обладают гибкостью, позволяющей свободно изменять бизнес-требования или обновлять приложение. Neo4j лучше всех заявляет об этом: «Разработка с использованием графовых баз данных идеально согласуется с современными методами гибкой разработки, основанной на тестировании». Кроме того, есть дополнительный бонус в том, что графовые базы данных — ПОТРЯСАЮЩИЕ!
В следующем блоге из серии «Моделирование графических данных» будут подробно описаны этапы моделирования данных: 1) понять проблему или цель нашего тематического исследования, 2) создать доску или концептуальную модель и 3) создать логическую модель данных. Теперь, когда мы понимаем определение элементов, которые будут включены в нашу базу данных графов, в следующем блоге мы представим набор данных, который мы использовали для нашей модели данных, и идентифицируем эти элементы в наборе данных.
Рекомендации
[1] Бехбергер, Дэйв и Джош Перриман. Графические базы данных в действии. Публикации Мэннинга, 2020.
[2] Neo4j, Inc. Руководство по началу работы — Моделирование данных — Руководство по графическому моделированию. Нео4дж. 2021. https://neo4j.com/docs/getting-started/current/data-modeling/guide-data-modeling/.
[3] Neo4j, Inc. Руководство по началу работы — Приложение — Принципы базы данных Graph. Нео4дж. 2021. https://neo4j.com/docs/getting-started/current/appendix/graphdb-concepts/.
[4] Amazon Web Services Inc. Создайте свое первое графическое приложение с помощью Amazon Neptune. Amazon Web Services Inc., 2008–2023 гг. https://catalog.us-east-1.prod.workshops.aws/workshops/2ae99bf2-10df-444f-a21f-8ad0537a9bdd/en-US/workshop2/gremlin/model
