Линейная регрессия — один из фундаментальных алгоритмов, существующих в мире машинного обучения. Понимание его внутреннего рабочего процесса помогает понять основные концепции других алгоритмов в науке о данных.

Формулировка
При построении модели линейной регрессии конечной целью является поиск вектора весов w и члена смещения b, которые более точно обеспечат прогнозируемое значение ŷ к реальному целевому значению y для всех входных данных:
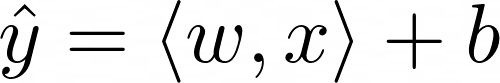
В нашем примере мы будем использовать набор данных с одной функцией x. Следовательно, x и w — одномерные векторы. Для простоты мы избавимся от скалярного произведения и перепишем приведенное выше уравнение следующим образом:

Функция потерь
Чтобы оценить производительность алгоритма на обучающих данных, нам нужно выбрать функцию потерь, которая будет минимизирована. Одним из самых популярных является Mean Squared Error (или просто MSE):
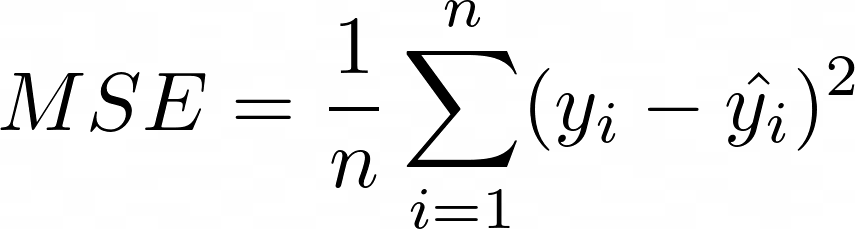
- y — истинное значение.
- ŷ – прогнозируемое значение.
Градиентный спуск
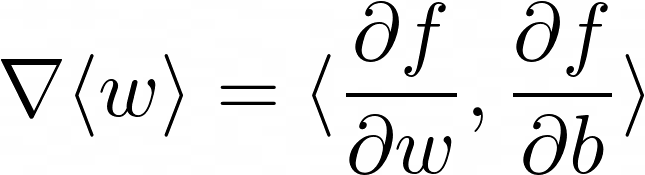
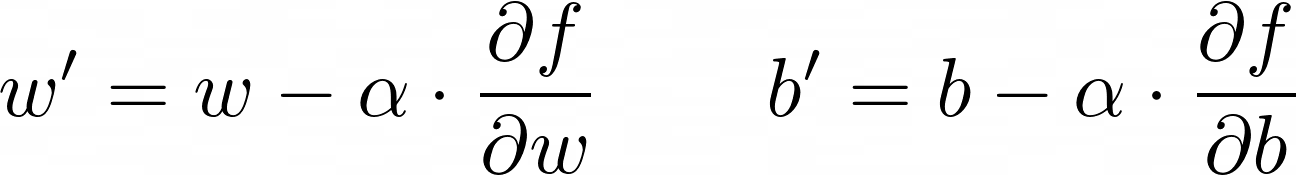
Градиентный спуск — это итерационный алгоритм обновления вектора весов для минимизации заданной функции путем поиска локального минимума/максимума функции (в нашем сценарии мы минимизируем функцию потерь). Градиентный спуск использует следующую формулу на каждой итерации:

- ‹w› — вектор весов на текущей итерации. Вычисленные веса назначаются ‹w›’. Во время первой итерации алгоритма веса обычно инициализируются случайным образом, но существуют и другие стратегии.
- альфа обычно представляет собой небольшое положительное значение, также известное как скорость обучения — гиперпараметр, который влияет на скорость нахождения локального минимума.
- перевернутый треугольник обозначает градиент — вектор частных производных функции потерь. В нашем примере вектор весов состоит из 2-х компонент. Итак, чтобы вычислить градиент ‹w›, нам нужно найти 2 частные производные (f — функция потерь):
Мы можем переписать формулы обновления для каждой компоненты вектора весов более простым способом:
Найдем формулы для обеих частных производных. Предположим, что MSE — это функция потерь и что мы вычисляем ее для одного наблюдения (n = 1 в формуле MSE), тогда f = (y — ŷ)² = (y — wx — b)².
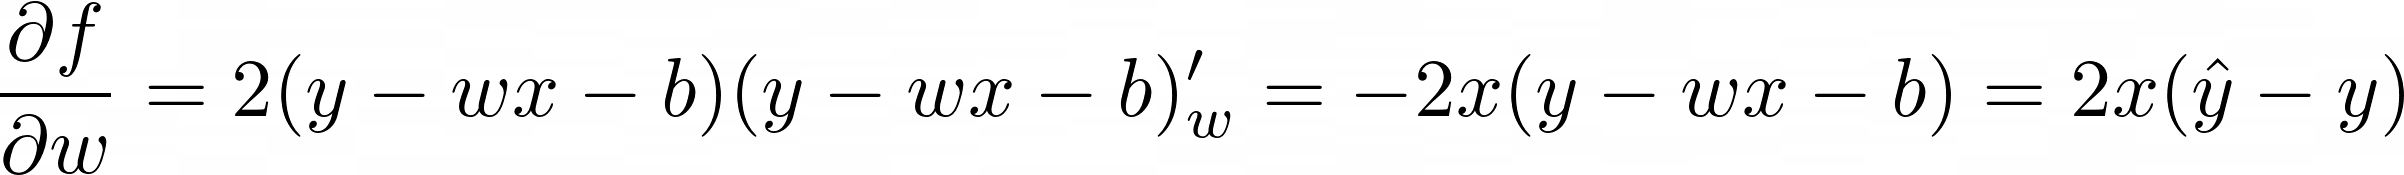
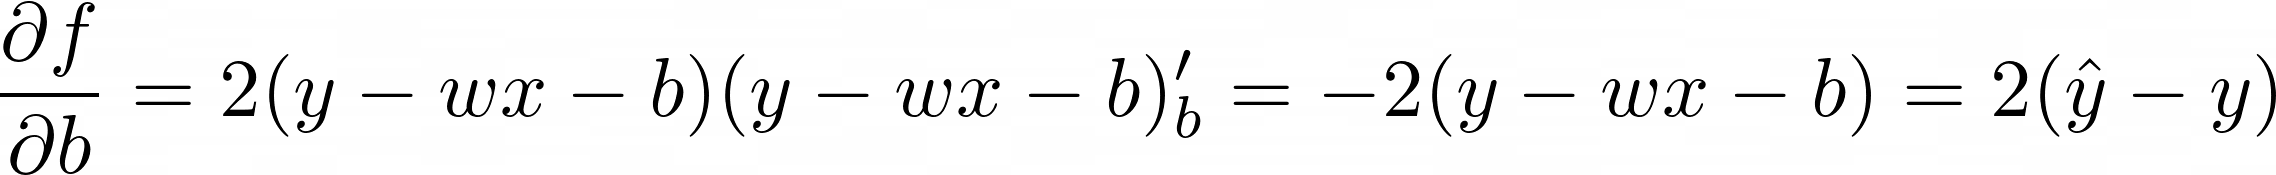
Выполнение обновления на основе одного объекта называется стохастическим градиентным спуском.
Пакетный градиентный спуск
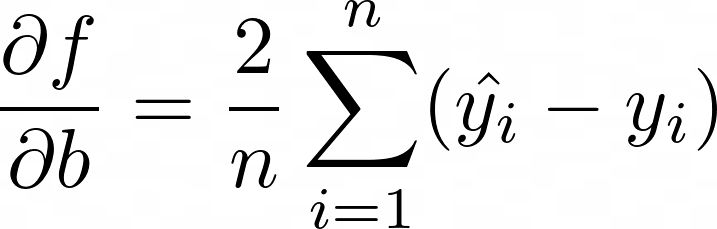
Ранее мы видели, как можно обновить параметры, вычисляющие MSE для одного объекта (n = 1). На самом деле можно выполнить градиентный спуск для нескольких объектов за одну итерацию. Такой способ обновления весов называется пакетным градиентным спуском.
Формулы для обновления весов в таком случае выглядят очень похоже по сравнению со стохастическим градиентным спуском. Единственное отличие состоит в том, что мы вычисляем сумму терминов всех объектов в пакете, а затем делим результат на n — размер пакета.

Выполнение
Вот полная реализация алгоритма на Python с комментариями и графиками в Google Colab. Вы можете проверить это и попробовать разные параметры для запуска регрессии. Цель состоит в том, чтобы найти наиболее подходящую линию регрессии в последней ячейке.

За и против
Плюсы:
- Скорость обучения. Благодаря простоте алгоритма линейная регрессия может быть быстро обучена по сравнению с более сложными алгоритмами машинного обучения. Кроме того, это можно реализовать с помощью метода LSM, который также относительно быстр.
- Интерпретируемость. Уравнение линейной регрессии, построенное для нескольких признаков, можно легко интерпретировать с точки зрения важности признаков. Чем выше абсолютное значение коэффициента признака, тем большее влияние он оказывает на окончательный прогноз.

Минусы:
- Предположения относительно данных. Перед подгонкой модели линейной регрессии важно проверить тип зависимости между выходными и входными функциями. Если он линейный, то должны возникнуть проблемы с его подгонкой. В противном случае модель не сможет хорошо согласовывать данные, поскольку уравнение содержит только линейные члены. На самом деле, можно добавить в уравнение более высокие степени, чтобы, например, превратить алгоритм в полиномиальную регрессию. Однако в действительности часто трудно правильно предугадать тип зависимости. Это одна из причин, по которой линейная регрессия не может адаптироваться ни к каким данным.
- Проблема мультиколлинеарности. Мультиколлинеарность возникает, когда два или более предикторов сильно коррелируют друг с другом. Представьте себе ситуацию, когда изменение одной переменной влияет на другую переменную. Однако обученная модель не имеет информации об этом. Когда эти изменения велики, модели будет трудно быть стабильной на этапе логического вывода на невидимых данных. Следовательно, это вызывает проблему переобучения. Кроме того, из-за этого окончательные коэффициенты регрессии также могут быть нестабильными для интерпретации.
- Нормализация данных. Чтобы использовать линейную регрессию в качестве инструмента важности признаков, данные должны быть нормализованы или стандартизированы. Это позволит убедиться, что все окончательные коэффициенты регрессии находятся в одной шкале и могут быть правильно интерпретированы.
Заключение
Мы рассмотрели линейную регрессию — простой, но очень популярный алгоритм в машинном обучении. Его основные принципы используются в более сложных алгоритмах.
Хотя линейная регрессия редко используется в современных производственных системах, ее простота позволяет часто использовать ее в качестве стандартной базовой линии в задачах регрессии, которую затем сравнивают с более сложными решениями.
Спасибо за чтение! 🚀
Исходный код, использованный в статье, можно найти здесь:
Другие статьи, связанные с машинным обучением:
