Тест Крускала Уоллиса: цель, область применения, предположения, примеры, реализация Python
1. Цель
Крускал-Уоллис — это непараметрический метод оценки того, происходят ли выборки из одного и того же распределения. Он используется при сравнении более чем двух независимых или несвязанных выборок. Однофакторный дисперсионный анализ (ANOVA) представляет собой параметрическую эквивалентность теста Краскела-Уоллиса.
1.1 Что было бы хорошим вариантом использования в бизнесе?
Давайте измерим влияние кампании, развернутой фармацевтической компанией на недавно запущенный препарат, где у нас есть 1550 целей и 500 противников. Мы рассмотрели распределение предписанного поведения и обнаружили, что оно не является нормальным (асимметричным), но имеет одинаковую форму для каждой группы (цели и противники). Мы не можем выполнить ANOVA; следовательно, мы применяем непараметрический критерий Крускала-Уоллиса.
2. Объем
Поскольку тест Крускала Уоллиса является непараметрическим тестом, нет предположения, что данные нормально распределены (в отличие от ANOVA).
- Фактическая нулевая гипотеза состоит в том, что популяции, из которых происходят выборки, имеют одинаковую медиану.
- Критерий Крускала-Уоллиса чаще всего используется, когда есть одна переменная атрибута и одна переменная измерения, и переменная измерения не соответствует предположениям ANOVA (нормальность и гомоскедастичность).
- Как и большинство непараметрических тестов, он выполняется на ранжированных данных, поэтому наблюдения измерений преобразуются в их ранги с использованием общего набора данных: наименьшее или самое низкое значение получает ранг 1, следующее наименьшее значение получает ранг 2, следующий ранг 3, и так далее. В случае ничьей считается средний ранг.
- Потеря информации при замене исходных значений рангами делает этот тест менее мощным, чем ANOVA, поэтому следует использовать ANOVA, если данные соответствуют предположениям.
Иногда утверждается, что нулевая гипотеза теста Крускала-Уоллиса состоит в том, что медианы групп равны. Однако это верно только в том случае, если вы считаете, что характеристики распределения каждой группы одинаковы. Несмотря на то, что медианы одинаковы, тест Крускала-Уоллиса может отклонить нулевую гипотезу, если распределения различаются.
3. Предположения
Группы разного размера можно исследовать с помощью статистики Крускала-Уоллиса. Критерий Крускала-Уоллиса, в отличие от сопоставимого однофакторного дисперсионного анализа, не предполагает нормального распределения, поскольку это непараметрическая процедура. Однако тест предполагает, что распределение каждой группы имеет одинаковую форму и масштаб, за исключением любых различий в медианах.
4. Методология
Крускала Уоллиса можно использовать для анализа различий в результатах теста и контроля. Когда данные искажены (ненормальное распределение), тест покажет, различаются ли две группы, без установления какой-либо причинно-следственной связи. Он не предложит причину разницы в поведении.
4.1 Как работает тест?
Крускал Уоллис работает, ранжируя все наблюдения, начиная с 1 (наиболее незначительные). Ранжирование выполняется для всех точек данных, независимо от группы, к которой они принадлежат. Связанные значения получают средний ранг, который они получили бы, если бы не были связаны.
Когда всем наблюдениям был присвоен ранг со знаком на основе переменной анализа (количество назначенных предписаний), они дифференцируются/разделяются на группы на основе их статуса цели/задержания. После этого вычисляется и сравнивается средний ранг каждой группы.
Ожидается, что цель будет иметь более высокий средний рейтинг, чем несогласные, поскольку инициатива или рекламная кампания развернута для этой группы. При значительном p-значении Target работает лучше, чем несогласные. Проблема здесь в том, что средний рейтинг целевой группы может быть выше при наличии выбросов, т. е. нескольких врачей, которые пишут больше сценариев, чем другие. Следовательно, мы всегда смотрим на арифметическую медиану и результирующее значение p, полученное Крускалом Уоллисом, чтобы подтвердить/опровергнуть нашу гипотезу.
Пусть Ni (i = 1, 2, 3, 4,..., g) представляет размеры выборки для каждой группы g (т. е. выборки или, в данном случае, количество врачей) в данных. ri — сумма рангов для группы i, где ri’ — средний ранг группы i. Затем статистика теста Крускала Уоллиса рассчитывается как:

Нулевая гипотеза о равных медианах населения отклоняется, если статистика теста превышает пороговое значение хи-квадрат. Когда нулевая гипотеза о равных популяциях верна, эта статистика имеет k-1 степень свободы и аппроксимирует распределение хи-квадрат. Аппроксимация должна иметь ni не менее 5 (т. е. не менее пяти наблюдений в группе), чтобы она была точной.

Используя таблицу распределения вероятностей хи-квадрат, мы можем получить критическое значение хи-квадрат при g-1 степенях свободы и желаемом уровне значимости. В качестве альтернативы мы могли бы изучить p-значение, чтобы прокомментировать значимость результатов.
4.2 Запуск H-теста вручную
Предположим, что фармацевтическая компания хочет понять, имеют ли три группы сегментов врачей разное количество пациентов (Стефани Глен, n.d.)Например,
Ключевые лидеры мнений/KOL (количество пациентов в месяц): 23, 42, 55, 66, 78
Специалисты/ТПО (объем пациентов в месяц): 45, 56, 60, 70, 72
Врачи общей практики/ВОП (объем пациентов в месяц): 18, 30, 34, 41, 44
4.2.1 Упорядочить данные в порядке возрастания после их объединения в один набор
18 23 24 30 41 42 44 45 55 56 60 66 70 72 78
4.2.2 Ранжируйте отсортированные точки данных. Используйте среднее значение в случае ничьей
Значения: 18 23 24 30 41 42 44 45 55 56 60 66 70 72 78
Ранг: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
4.2.3 Подсчет суммы рангов для каждой группы

4.2.4 Расчет H-статистики с использованием формулы 1 и чисел с рисунка 1
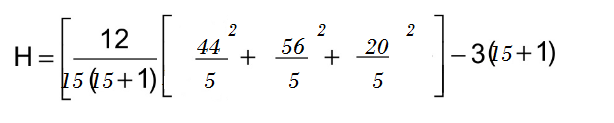
H=6.72
4.2.5 Определите критическое значение хи-квадрат для g-1 степени свободы с
α=0,05, которое для нашей задачи (3–1=2 степени свободы) должно быть равно 5,99. См. таблицу ниже.
4.2.6 Сравните значение H из 4.2.4 с критическим значением из 4.2.5
Нулевая гипотеза, утверждающая, что средний объем пациентов в трех разных группах одинаков, должна быть отклонена, если критическое значение хи-квадрат меньше, чем статистика H. Поскольку 5,99 (критическое значение) ‹ 6,72, мы можем отвергнуть нулевую гипотезу.
Необходимо больше доказательств, чтобы сделать вывод о том, что медианы не равны, если значение хи-квадрат не ниже, чем рассчитанная выше статистика H.
5. Реализация Python
Нулевая гипотеза о том, что медианы населения всех групп равны, проверяется с помощью H-критерия Крускала-Уоллиса. Это непараметрический вариант ANOVA. В тесте используются две или более независимых выборки разного размера. Обратите внимание, что опровержение нулевой гипотезы не показывает, чем отличаются группы. Чтобы определить, какие группы отличаются, необходимы апостериорные сравнения между группами.
from scipy import stats
x = [1, 3, 5, 8, 9, 12, 17]
y = [2, 6, 6, 8, 10, 15, 20, 22]
stats.kruskal(x, y)
KruskalResult(statistic=0.7560483870967752, pvalue=0.3845680059797648)
print(np.median(x))
print(np.median(y))
8.0
9.0
print(np.mean(x))
print(np.mean(y))
7.86
11.12
Вывод, сгенерированный Python, показан выше. Следует отметить, что, хотя в средних значениях двух категорий наблюдается заметная разница, эта разница, если принять во внимание медиану, незначительна, поскольку p-значение намного превышает 5%.
6. Заключение
Тест Крускала-Уоллиса полезен при работе с особенно асимметричными образцами. Его можно широко использовать для контрольной группы тестирования во время развертывания кампании или даже при проведении A/B-тестирования. Это применимо для большинства случаев использования в отрасли, поскольку каждый клиент ведет себя по-разному при работе с клиентами в розничной торговле или врачами в фармацевтической сфере. Когда мы смотрим на размер корзины или количество пациентов, немногие клиенты покупают больше, в то время как немногие врачи имеют больше пациентов. Следовательно, для такого асимметричного распределения жизненно важно провести тест Крускала-Уоллиса, чтобы проверить, похоже ли поведение.
7. Ссылка
Стефани Глен. H-тест Крускала-Уоллиса: определение, примеры, предположения, SPSS из StatisticsHowTo.com: Элементарная статистика для всех нас! https://www.statisticshowto.com/probability-and-statistics/statistics-definitions/kruskal-wallis/
Об авторе: специалист в области продвинутой аналитики и консультант по вопросам управления, помогающий компаниям находить решения различных проблем с помощью сочетания бизнеса, технологий и математических расчетов с организационными данными. Энтузиаст науки о данных, здесь, чтобы делиться, учиться и вносить свой вклад; Вы можете связаться со мной в Linked и Twitter;
