Инструмент, который автоматизирует, где и что регистрировать, чтобы ускорить и повысить эффективность устранения неполадок!
Недавно (5 лет назад!), как специалист по данным, я начал исследовать мир наблюдаемости программного обеспечения с особым интересом к обнаружению аномалий (я даже защитил докторскую диссертацию в этой области). Попутно я узнал, что большинство проблем, которые мы решаем с помощью наблюдательных платформ и инструментов, могут быть решены в самом начале (когда код написан) и более эффективно! В настоящее время я беру на себя инициативу и разрабатываю инструмент для решения некоторых проблем.Текст ниже дает краткий обзор и краткое изложение основных идей.
Если вы сочтете это интересным, в конце у вас будет шанс отметить проект на GitHub.
Спрос на скорость выпуска программного обеспечения → увеличение количества сбоев → разработчики тратят много времени на устранение неполадок
Из-за неизбежных недостатков в программном обеспечении приложения и системы подвержены сбоям, которые потенциально могут нанести им значительный ущерб. Своевременное и точное обнаружение таких угроз необходимо для надежности, стабильной работы и минимизации потерь в сложной системе.
Журналы считаются самым важным источником данных, который отражает взаимодействия между данными, файлами, службами или приложениями, которые обычно используются разработчиками, и методы, основанные на данных, для понимания поведения системы, а также для обнаружения, локализации и решения проблем, которые могут возникнуть.
Сегодня речь идет о полнофункциональных платформах наблюдения, но мало о качестве входных данных
На рынке как с открытым, так и с закрытым исходным кодом существует несколько платформ и инструментов (ELK, Splunk, Coralogix, Datadog и т. д.), которые обеспечивают полную наблюдаемость, быстрый поиск, настройку правил и предупреждений, а также автоматизированное понимание.
Однако одним из основных недостатков этих платформ является то, что они предназначены для сбора, анализа и понимания уже сгенерированных данных программным приложением. Здесь важно указать несколько моментов:
- Платформы наблюдения генерируют информацию из собранных данных → Они не влияют на процесс создания данных (например, ведение журнала, отслеживание)
- Данные плохого качества → плохие идеи и действия. В этом легко убедиться, прикрепив свой игрушечный проект к отправке данных в бесплатной пробной версии одной из платформ и проверив, может ли он предоставить вам полезную информацию.
- Что касается протоколирования программного обеспечения, все остается на разработчиках, и на практике всегда наблюдается несколько сценариев:
- Проблема возникает и корректно регистрируется → разработчик может понять ее за короткое время.
- Возникла проблема и логируется частично → разработчик может понять проблему только по воспроизведению — это требует времени.
— Проблема возникает и вообще не логируется → — это занимает больше всего времени, чтобы понять проблему.
Поэтому наличие платформы для наблюдения помогает, но когда данные правильные. Даже ELK с простыми функциями поиска будет очень полезен, если код хорошо покрыт логами.
Кто генерирует данные и как?
Многие компании внедряют фреймворки ведения журналов и указывают своим разработчикам требования к качеству при написании инструкций по ведению журналов. Требования к качеству определяют различные свойства качества лог-инструкций, такие как:
- Правильное размещение журнала в исходном коде (куда вести журнал?)
- Назначение правильных уровней журнала (например, использование INFO/ERROR, где это уместно).
- Написание статического текста с достаточной информацией (т. е. с достаточными лингвистическими свойствами).
- Соответствующие форматы инструкций журнала. (например, метка времени, уровень, сообщение)
Поскольку многие задачи обслуживания (например, отслеживание ошибочных действий, диагностика сбоев и выполнение анализа первопричин) часто основаны на журналах, они напрямую зависят от качества журналов, т. е. свойств качества инструкций журнала.
Недавние исследования промышленных систем и систем программного обеспечения с открытым исходным кодом показывают, что разработчики делают периодические фиксации, связанные с журналом, во время разработки. Это означает, что написание инструкций по журналу качества в первый раз, даже с заданными рекомендациями по качеству, не является тривиальной задачей. Кроме того, рекомендации могут быть неполными, не охватывать все возможные случаи и различаться в зависимости от службы. Хотя платформы ведения журналов унифицируют ведение журналов, они не реализуют механизмы для отслеживания/реализации качества и охвата журналов. Таким образом, решения об инструкциях журнала чисто ориентированы на человека, что может привести к плохой практике ведения журнала (например, к неправильному назначению уровня журнала или неправильному местоположению журнала).
Автоматическое ведение журнала и охват журнала
Давайте сразу перейдем к практическому объяснению проблемы и возможному решению.
Состояние сегодня
Код на рисунке ниже представляет собой простую функцию, которая отправляет сообщения в тему Kafka. Код логически хорошо защищен, но не использует методы ведения журнала. При развертывании службы, содержащей эту функцию, если в этой функции возникает ошибка, то практически нет возможности отследить ее причину. Разработчику необходимо провести длительный цикл отладки (при условии, что код является частью большой архитектуры на основе микросервисов), который включает улучшение логирования, поиска, проверки установленных вручную правил и т. д.
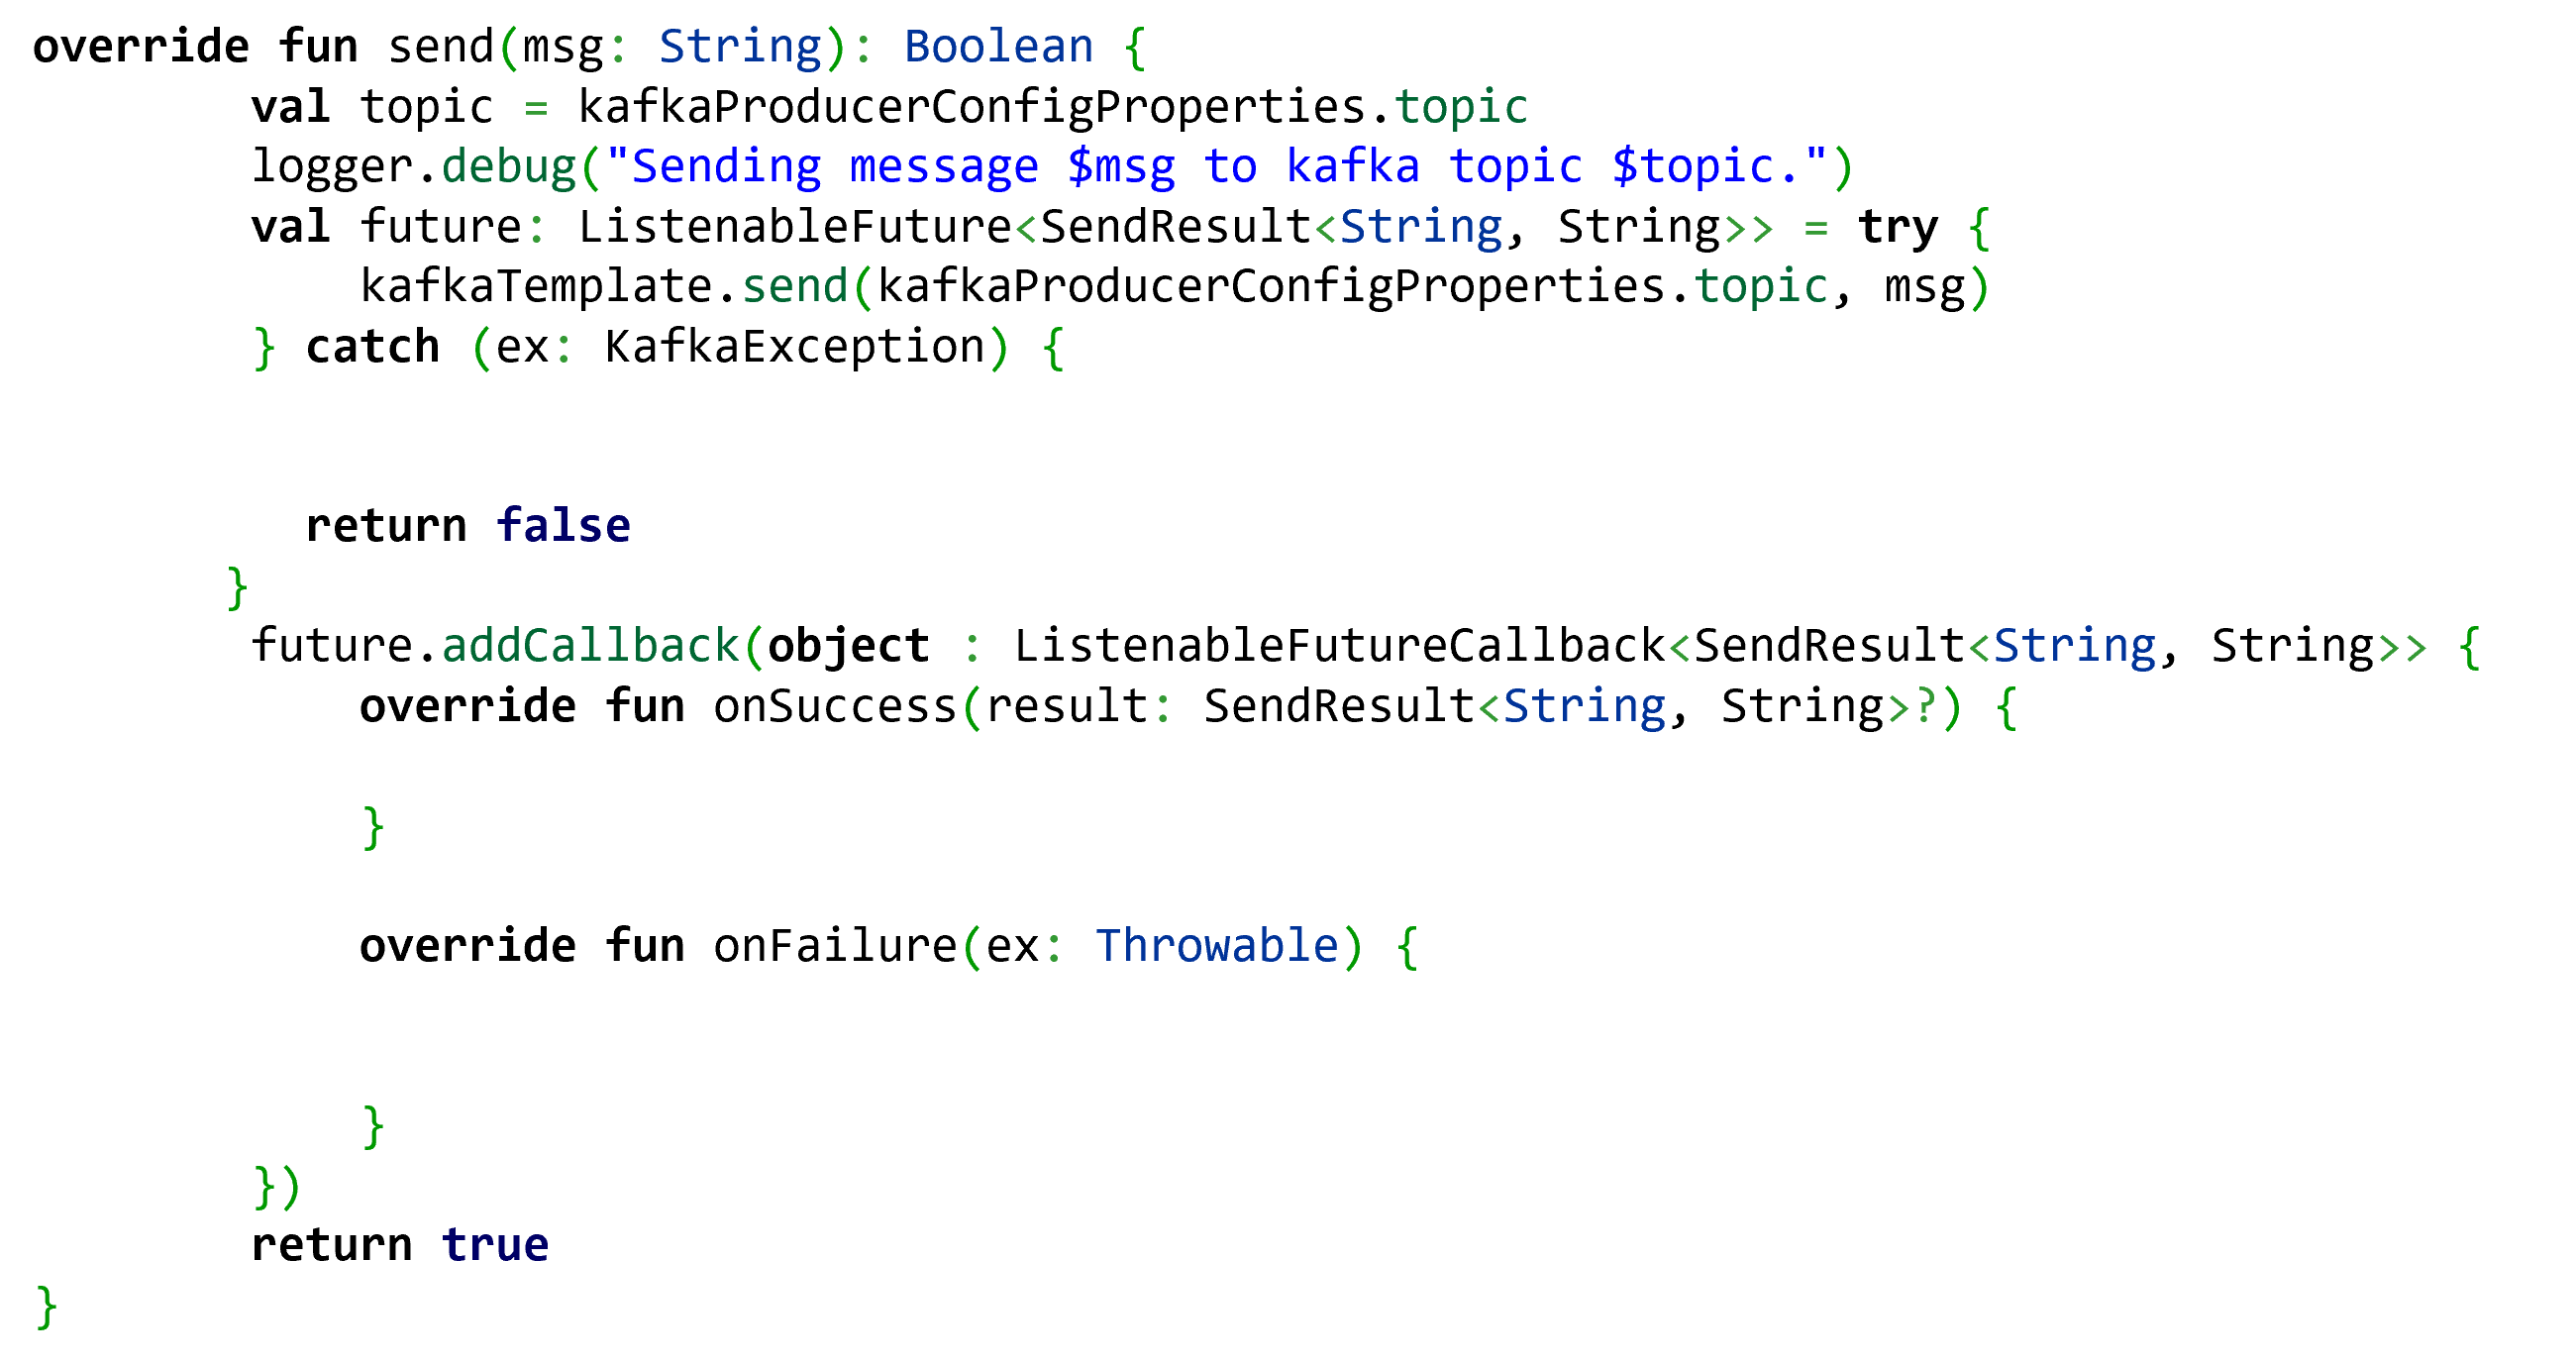
Код написан изначально.
Ваш автоматический регистратор
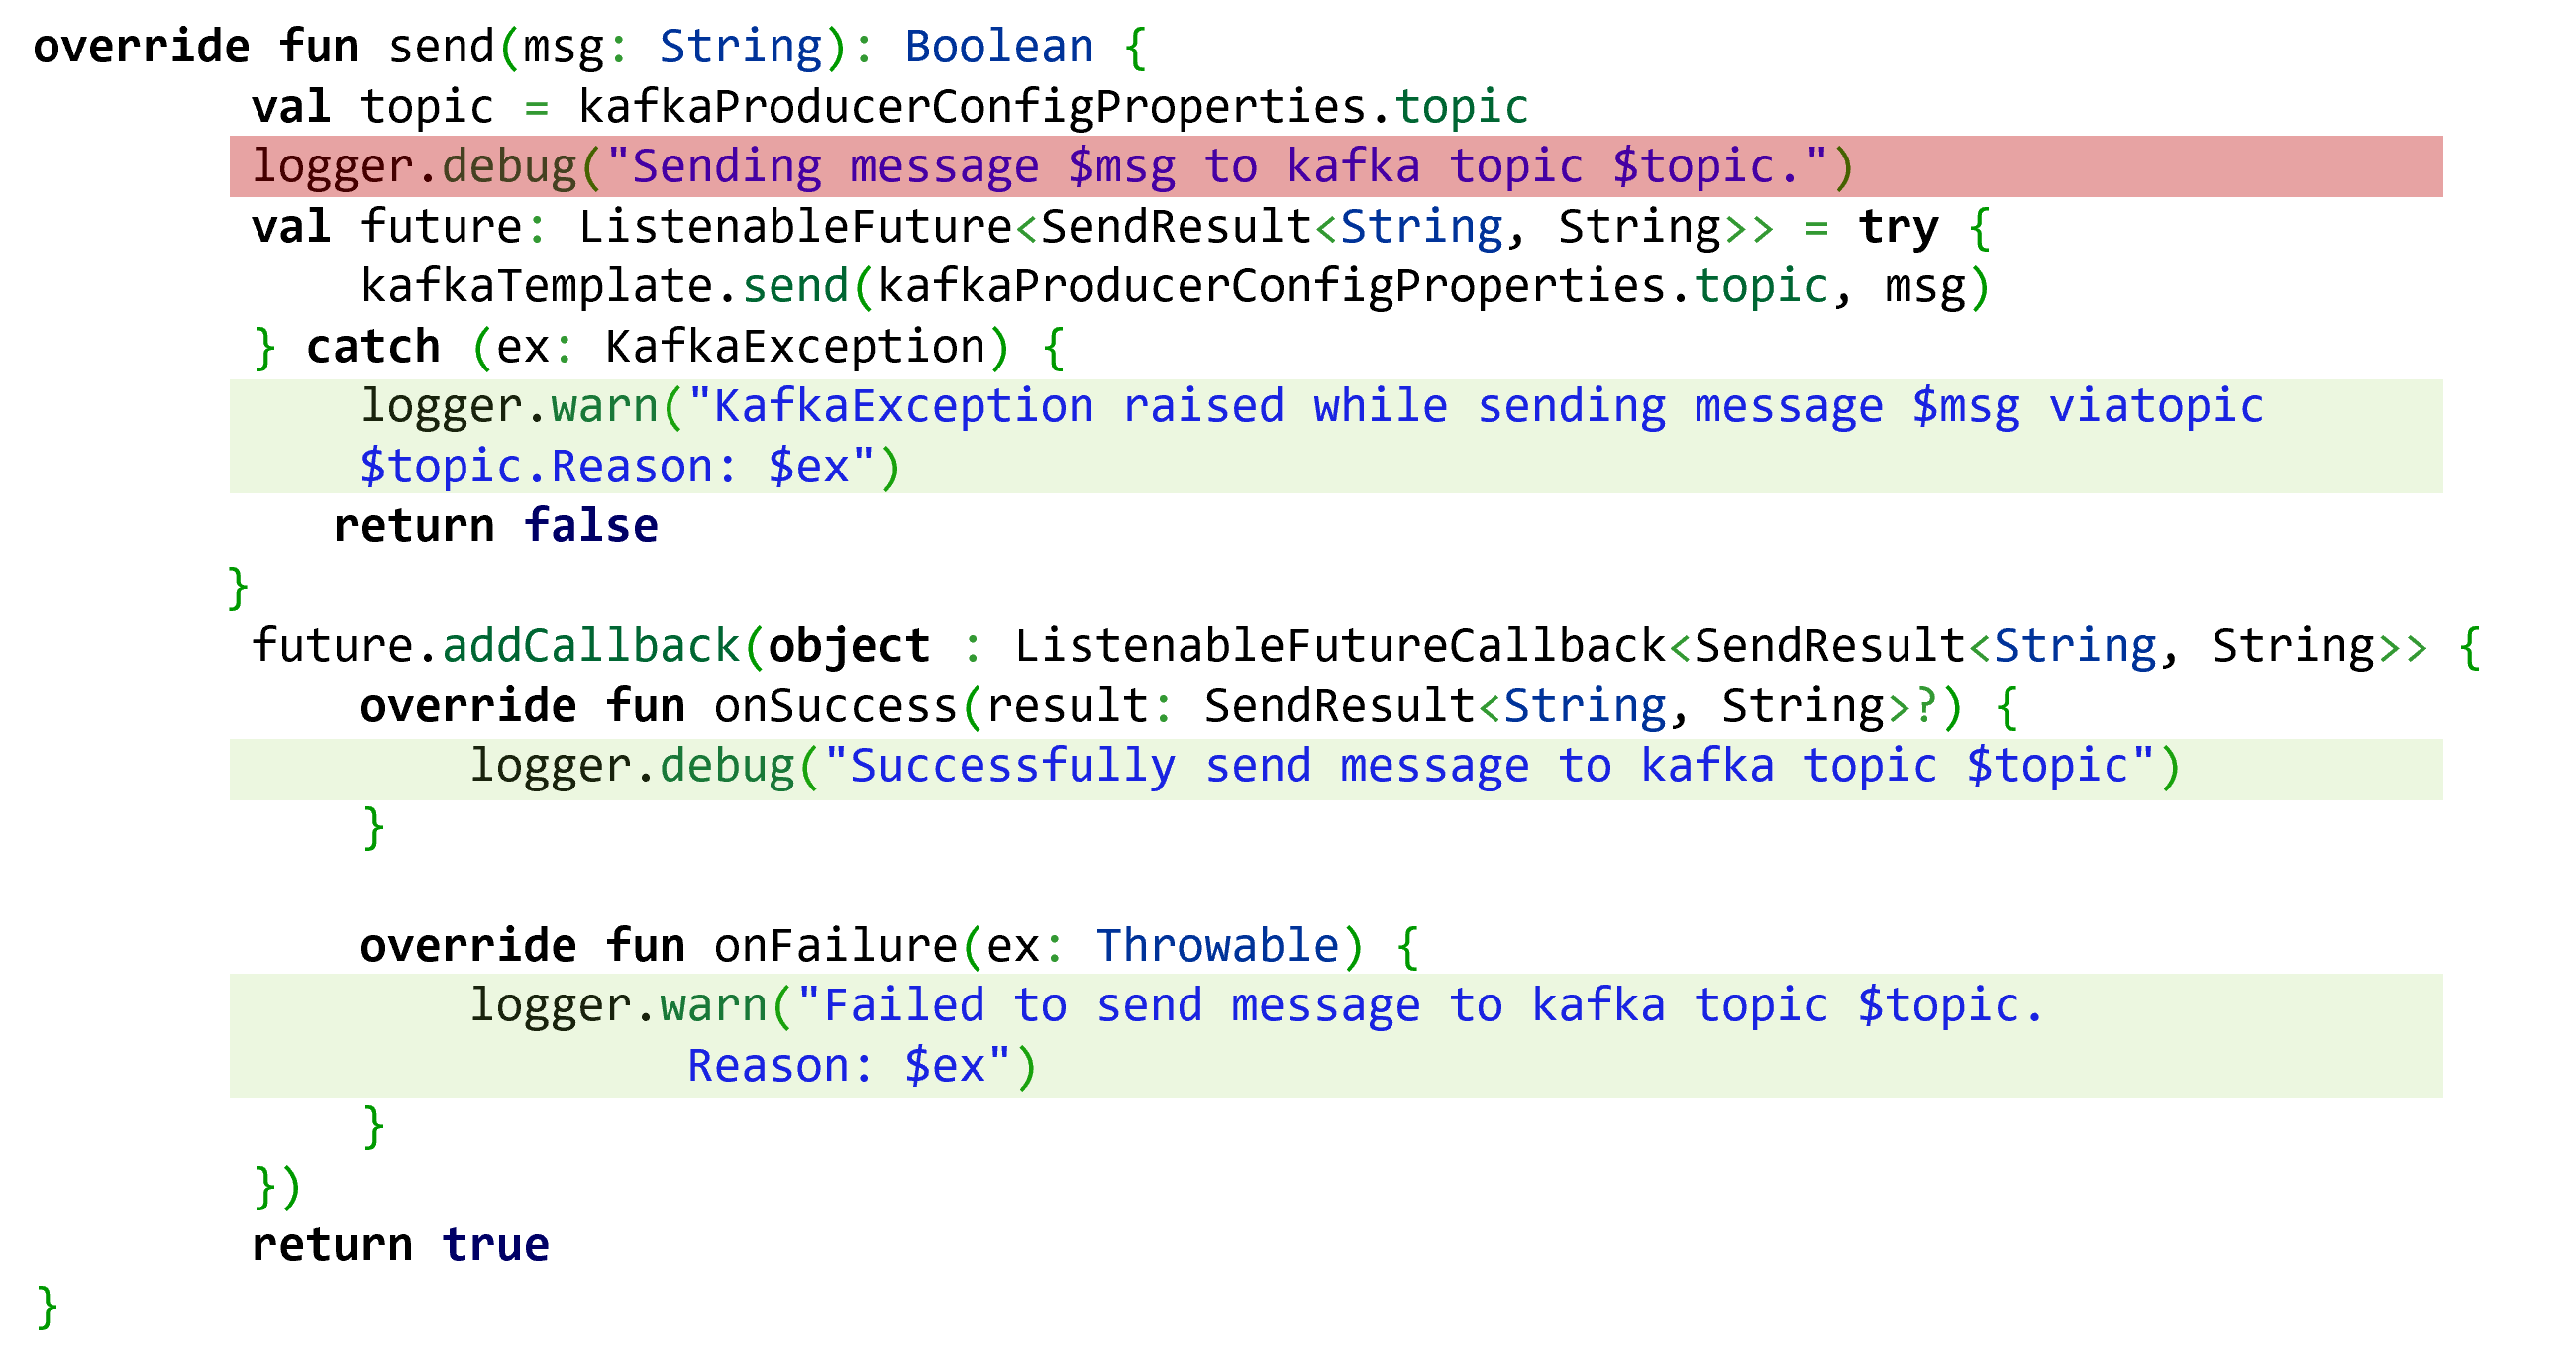
В приведенном ниже коде показано, как инструмент искусственного интеллекта с автоматическим ведением журнала генерирует операторы ведения журнала для разработчика. Разработчику не нужно думать о регистрации, он сосредотачивается только на кодировании, которое создает ценность для бизнеса. В этом примере первая строка журнала (красная) не нужна, а следующие три (зеленые) необходимо добавить для обеспечения надлежащего ведения журнала.
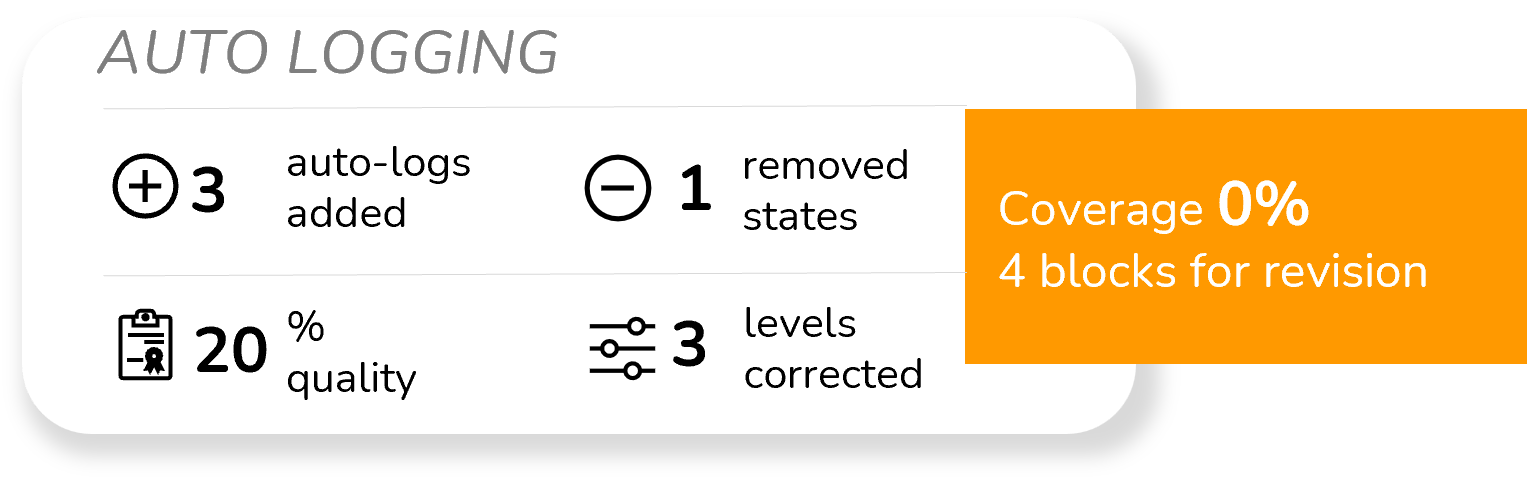
Кроме того, инструмент обобщает идеи/рекомендации/изменения в отчете, который обеспечивает общее покрытие журналов, а также другие полезные ключевые показатели эффективности.
Технология, лежащая в основе, представляет собой смесь абстрактных синтаксических деревьев для анализа кода, разработки функций с помощью глубоких нейронных сетей и оболочек, упрощающих использование. Этот инструмент можно хорошо интегрировать в ваши любимые среды IDE и CI/CD.
Получите уведомление, когда бета-версия будет выпущена!
Если это покажется вам интересным, отметьте проект GitHub или напишите мне свой адрес электронной почты по этой ссылке. Таким образом, вы получите уведомление, когда этот инструмент будет выпущен.
