определение будущих отношений в сети

По мере того, как мы приближаемся к концу этой серии блогов по аналитике графов, мы подбираем наиболее важный вариант использования, который можно использовать с использованием графов, то есть прогнозирование будущих отношений в сети. Это может быть очень полезно для платформ социальных сетей (вспомните функцию предложения друзей в Instagram или FB) или даже для создания рекомендательных систем. поймать вдохновителя, нарисовав какую-то сеть между подозреваемыми и найдя связь между ними)
Есть много базовых идей, которым мы можем следовать, чтобы определить потенциальные связи на графике, используя алгоритмы, которые мы уже обсуждали в прошлых блогах.
Примечание. Посетите несколько предыдущих блогов, чтобы лучше понять
Несколько предварительных условий, которые нам нужно сделать в Neo4j (как мы делали во всех предыдущих блогах)
- Загрузите набор данных из CSV после помещения его в папку импорта.
Запрос
CALL apoc.load.csv("flight_network_spicejet.csv")
YIELD list as item
MERGE(n:city{name:item[0],lat:toInteger(item[3]),long:toInteger(item[4])})
MERGE (m:city{name:item[1]})
MERGE (n)-[:flight{distance:toInteger(item[2])}]->(m)
- Создайте графическую проекцию
CALL gds.graph.project("airline",{city:{properties:["lat","long"]}},{flight:{properties:"distance",orientation:'UNDIRECTED'}})
Если вы столкнулись с какими-либо проблемами и не можете понять приведенные выше запросы, посетите мой предыдущий пост, чтобы узнать, как импортировать данные, с подробным описанием всех шагов.
Сообщество
Идея проста: если две пары узлов принадлежат одному и тому же сообществу, между ними существует потенциальная граница. Как определяется сообщество для узла? Вы можете обратиться к предыдущему сообщению на основе того же сообщества в нашей сети авиакомпаний.
Весь процесс можно разделить на две части
- Определить сообщества
- Формируйте ребра между узлами, которые попадают в одно и то же сообщество, но не имеют ребра на данный момент.
Запрос 1 (определение запроса по алгоритму Лувена)
CALL gds.louvain.write('airline', { writeProperty: 'community' })YIELD communityCount, modularity, modularities
В приведенном выше запросе мы определили сообщество каждого узла с помощью Лувена и создали новое свойство для каждого узла под названием «сообщество».
Далее мы создадим ребро между любыми двумя узлами, которые попадают в одно и то же сообщество, но не имеют ребра.
MATCH (u:city)
MATCH (v:city)
where u<>v and u.community=v.community
Optional MATCH (u)-[r:flight]->(v) where r is null
create (u)-[x:predicted]->(v)
Это требует некоторого объяснения
- Прежде всего, мы пытаемся проверить каждую пару узлов (u, v), такую, что u!=v и они находятся в одном сообществе.
- Необязательное совпадение выполняется, чтобы выяснить, присутствует ли ребро или нет.
- Если нет, создайте «предсказанную» границу между ними.
Выход
Созданные новые ребра (желтые) образуют несколько кластеров. Это совершенно очевидно, поскольку мы создали новые ребра между теми парами узлов, где они попадают в одно и то же сообщество, поэтому при визуализации они отображаются как кластеры.
На основе расстояния
- Кратчайший путь
Как вы, должно быть, предположили, это напрямую связано с кратчайшим расстоянием между двумя узлами в сети. Как рассчитать кратчайший путь между узлами? мы это тоже обсуждали. Мы можем использовать любое из следующих условий для прогнозирования ссылок:
- Установите порог. Если кратчайшее расстояние между любой парой узлов меньше этого порога, мы говорим, что может существовать потенциальный узел.
Or
- Мы можем сортировать пары узлов по кратчайшему расстоянию и выбирать пары с наибольшим количеством узлов, где мы говорим, что у нас есть высокая вероятность наличия связи.
Запрос для первого типа предсказания ссылки (с использованием порога) приведен ниже.
match (u:city)
match (v:city)
where u<>v
Optional MATCH (u)-[r:flight]->(v) where r is null
CALL gds.shortestPath.dijkstra.stream('airline', {
sourceNode: u,
targetNode: v,
relationshipWeightProperty: 'distance'
})
YIELD index, sourceNode, targetNode, totalCost, nodeIds, costs, path
where totalCost<750
create (u)-[x:predicted]->(v)
Это очень похоже на тот, который мы использовали ранее для прогнозов «на основе сообщества», но с некоторыми тонкими изменениями.
- Мы вычисляем кратчайший путь между двумя узлами (u,v), где u!=v и между ними нет ребра
- Кратчайший путь между двумя узлами должен быть меньше 750 (км), чтобы существовало новое ребро.
Выход

2. Индекс Каца
Индекс Каца учитывает все возможные пути, существующие между любой парой узлов, и выполняет суммирование для расчета окончательной метрики, учитывающей связь или нет. Формула выглядит примерно так
Показатель прогнозирования ссылок = ∑ₐβᵃpath(u, v; a)
Давайте расшифруем это
- Здесь путь (u, v; a) относится к общему количеству путей между узлами u и v длины «a».
- βᵃ — это не что иное, как вес, присваиваемый путям каждой длины. Например, путям длины 1 или 2 следует присвоить более высокий вес и, следовательно, более высокий β по сравнению с путями длины 5 или 6.
Итак, если у нас есть 2 пути длины = 1, 3 пути длины = 2 и 2 пути длины = 3, то наш индекс Каца =
β¹ x 2 + β² x 3 + β³x 2
где β¹, β², β ³ — веса, присвоенные каждой длине пути
по соседству
Общие связи
Как следует из названия, чем чаще встречаются соединения между двумя узлами, тем больше шансов на связь между двумя узлами. Таким образом, если у «Раджа» и «Тану» 100 общих друзей по сравнению с «Раджем» и «Рани» с 80 общими друзьями, шансов на дружбу между Раджем и Тану больше, чем у Раджа и Рани (людей, которых вы, возможно, знаете).
Шансы предсказания ссылок = set(connections(Raj))∩set(connections(Tanu))
Ниже приведен запрос для того же, где мы поставили условие, что минимум общих соседей должен быть >8
MATCH (u) MATCH (v)
where u<>v and  gds.alpha.linkprediction.commonNeighbors(u, v)>8
optional match (u)-[r:flight]-(v) where r is null
create (u)-[x:predicted]->(v)
Приведенный выше запрос аналогичен тому, что мы обсуждали для приведенных выше случаев, когда мы находим пары узлов (u, v), такие, что они не совпадают и не имеют ребра. Если да, то мы вычисляем количество общих соседей, и если оно больше заданного порога, прогнозируется новое ребро.
Выход

Адамик-Адар
Расширение общих соединений, вместо того, чтобы находить только общие соединения, оно также предоставляет более высокие веса редким общим соединениям по сравнению с другими общими соединениями. Формула расчета Адамика-Адара
Шансы предсказания ссылок =Σi 1/log(степень(i)),
i ∈ Connections(u) ∩ Connections(v)
Расшифруем это уравнение
- Что такое «я» в первую очередь? это общий узел соединения на пересечении Connections(u) ∩ Connections(v)
- То, что мы делаем, является суммированием обратной степени каждой общей связи
Предположим, нам нужно рассчитать шансы прогнозирования связи между узлами U и V в следующих сценариях.
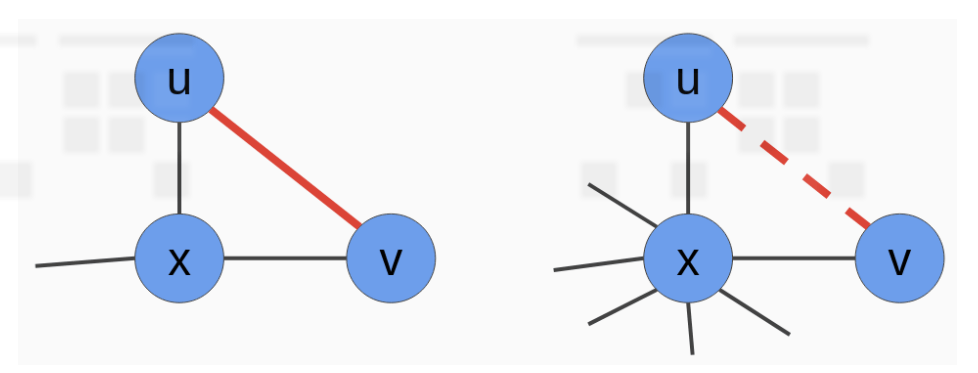
В левом сценарии X имеет степень 3, а в правой части X имеет степень 7. Если X является единственным общим соединением, то окончательный шанс предсказания связи для
- Слева:=1/журнал(3)
- Справа = 1/лог(7)
т. е. связь между U и V на левом графике более возможна, чем на правом графике. Точно так же, если у нас есть более общие узлы соединения, обратная степень каждого из них будет складываться, чтобы получить окончательные возможности Link.
Всего соседей
Идеология здесь популярная, люди обычно знают друг друга. Следовательно, то же самое можно применить и к сетям. Этот показатель можно рассчитать по
Подключения(u)∪ Подключения(v)
На тех же основаниях (по причине популярности) у нас может быть и другая формула, т. е. Степень (u) x Степень (v), которая называется Предпочтительная привязанность. Следовательно, чем больше связей, тем больше шансов на связь между ними.
Давайте запустим пример с предпочтительным вложением, где
градус(u) x градус(v)>1000
MATCH (u)
MATCH (v)
where u<>v and  gds.alpha.linkprediction.preferentialAttachment(u, v)>1000
optional match (u)-[r:flight]-(v) where r is null
create (u)-[x:predicted]->(v)
Выход

На этом серия блогов Graph Analytics подходит к концу!
Вы можете найти больше сообщений ниже
- Аналитика графов (6 частей)
- Алгоритмы НЛП (9 частей)
- Начнем с временных рядов (8 частей)
- Основы обучения с подкреплением (6 частей)
- Создание портфолио с помощью Streamlit
- Генеративное моделирование (7 частей)
- Трансформеры в НЛП(4 части)
- Уменьшение размеров (3 части)
- Обнаружение объектов с помощью YOLO (3 части)
- Tensorflow для начинающих (концепции + примеры) (4 части)
- Статистика для начинающих (4 части)
