Я генеральный директор многомиллиардной компании (в моем самом смелом воображении;), которая собирается отпраздновать платиновый юбилей разнообразными мероприятиями в нескольких городах. В рамках мероприятий моя компания будет раздавать сладости, прохладительные напитки, а также футболки для сотрудников, которые будут одеты и придут по этому случаю. В моей компании 2 лакха сотрудников, и ожидается, что приедет около 1 лакха (исходя из предыдущих данных о праздновании Золотого юбилея)
Теперь возникает большой вопрос, сколько футболок каждого размера мне нужно заказать? я. e Сколько размеров XL и L мне нужно заказать? Сколько M- и S-размеров?
Единственное, что я знаю, это то, что есть некоторая корреляция между размером футболки и их ростом. У меня рост 168 см и L мне подойдет (знаю). У моего двоюродного брата рост 160 см, и М ему идет (я знал, потому что в прошлую пятницу я подарил ему футболку, и она была для него огромной. Кстати, он был не очень доволен). Итак, исходя из своих расчетов, я предполагаю следующее:

Но увы! У меня нет данных о весе и росте всех моих сотрудников! Кроме того, сотрудники могли похудеть или прибавить в весе (благодаря работе из дома ;) Как мне получить цифры для разных размеров футболок? Но если мы приблизительно знаем процент сотрудников, попадающих в каждую категорию, это помогает! Итак, следующий вопрос: как нам получить эти проценты?
О дорогая Центральная Предельная Теорема — приди ко мне на помощь!
На следующий день я говорю своему охраннику на входе в офис собрать данные о росте 50 сотрудников. Поэтому он поставил прибор для измерения роста возле входа и начал измерять рост случайных сотрудников. Я воспроизвел это упражнение в офисах моей компании в 30 разных местах по всей стране. В конце дня у меня есть 30 выборок размером 50 каждая, то есть 50 x 30 = 1500 данных о высоте. Это будут данные, которые будут репрезентативными для моих 1 000 000 сотрудников.
Затем я взял каждую выборку одну за другой и рассчитал их средние значения. Итак, я получил 30 средних значений. Я открыл MS Excel и начертил средние значения. Сюжет, который я получил, выглядел следующим образом:
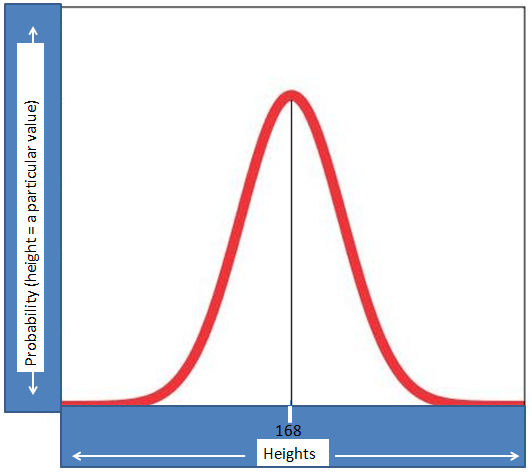
О, это похоже на нормальное распределение! Да, это нормальное распределение. В нормальном распределении самый высокий пик соответствует среднему значению данных. Здесь пик находится на уровне 168 см. Это означает, что средний рост 1500 сотрудников составляет 168 см.
Вы спросите — Ну и что? Я так и не получил ответа на свой первоначальный вопрос — сколько футболок размеров L, M или S мне заказать?
Для этого нам нужно вычислить еще один параметр — стандартное отклонение.
Стандартное отклонение (σ)рассчитывается следующим образом:

Здесь μ = среднее значение выборки, т. е. 168, N — размер выборки, т. е. 50. Каждое среднее_высота соответствует среднему значению каждой выборки из 30 выборок.
Допустим, мы получили σ как 6. Таким образом, объединив информацию о среднем значении и стандартном отклонении, мы получим график ниже.
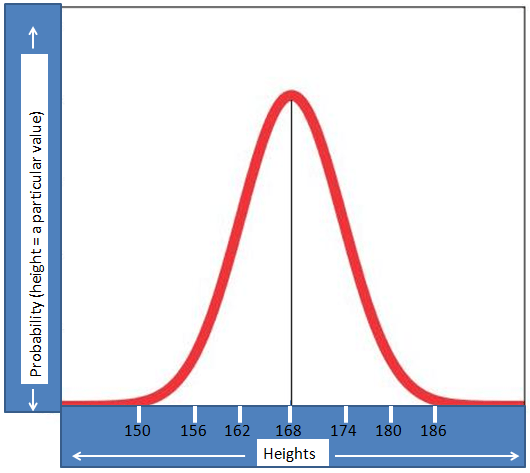
Мы можем получить дополнительные сведения из этого графика с помощью правила 68–95–99,7. Это правило гласит, что если случайная величина нормально распределена (здесь случайной величиной является высота), то
около 68,2 % всех значений лежат между средним значением ± 1σ,
около 95,4 % всех значений лежат между средним значением ± 2σ,
около 99,7 % лежит между средним значением ± 3σ

Теперь мы можем построить CDF (кумулятивную функцию распределения), как показано ниже. CDF сообщит нам, какой процент высот меньше определенного значения. Если быть точным, это даст
CDF (высота) = вероятность (высота ‹ конкретное значение)
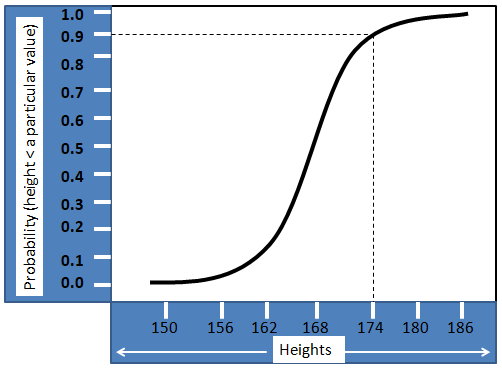
Из приведенного выше графика CDF можно сказать, что «Вероятность роста ‹ 174 см равна 0,9. Другими словами, вероятность высот › 174 = 1-0,9, т.е. 0,1.
Теперь, если рост › 173 см, нам нужно выбрать футболку размера XL. Таким образом, вероятность футболок размера XL = 0,1 или 1% от общего количества футболок!
Точно так же я могу рассчитать вероятность каждой размерной скобки и соответствующим образом заказать !!
Следует отметить, что только если размер выборки N является большим числом, стандартное отклонение выборочных средних имеет тенденцию равняться стандартному отклонению роста населения. Когда N невелико, то стандартное отклонение совокупности = стандартное отклонение выборочных средних * √N. В приведенном выше примере для простоты я предположил, что оба стандартных отклонения примерно одинаковы.
Математики определили, что для того, чтобы CLT сохранялся (чтобы получить хорошую кривую, похожую на нормальное распределение), любое число ≥ 30 является хорошим числом для размера выборки (своего рода эмпирическое правило).
– – – – – – –
Если вам понравилась моя статья, подписывайтесь! Поскольку это означало бы огромное поощрение для меня.
– – – – – – –
Оставайтесь с нами, чтобы не пропустить другие статьи, связанные с наукой о данных и машиностроением.
Использованная литература :
1. Курс прикладного ИИ (теперь часть Scaler)
2. Википедия
