Рекомендация подозрительных учетных записей с центральностью и сходством узлов
В частях 1 и 2 этой серии мы изучили график и определили сообщества с высоким риском мошенничества. На этом этапе мы можем захотеть выйти за рамки нашей бизнес-логики, чтобы автоматически идентифицировать других пользователей, которые подозрительно похожи на уже выявленные риски мошенничества. Neo4j и GDS упрощают сортировку и рекомендацию таких подозрительных пользователей за считанные секунды. Для этого мы можем использовать как алгоритмы центральности, так и алгоритмы подобия.
Технические ресурсы для воспроизведения этого анализа и анализа во всех других частях этой серии содержатся в этом репозитории GitHub, который включает записную книжку iPython и ссылку на набор данных.
Использование взвешенной степени центральности для рекомендации потенциальных счетов с высоким риском
Мы можем быстро и легко создать ранжированный список подозрительных учетных записей пользователей со взвешенной степенью центральности. В частности, мы можем рассчитать степень центральности пользователей по отношению к их идентификаторам (устройствам, картам и IP-адресам), взвешенным по значениям fraudRiskRatio, которые мы сделали в части 2. В этом случае достаточно простого запроса Cypher.
result = run(driver,'''
 MATCH(f:FraudRiskUser)-[:HAS_CC|HAS_IP|USED]->(n)
 WITH DISTINCT n
 MATCH(u:User)-[:HAS_CC|HAS_IP|USED]->(n)
 WHERE NOT u:FraudRiskUser
 WITH left(u.guid,8) as uid,
  sum(n.fraudRiskRatio) AS totalIdFraudRisk,
  count(n) AS numberFraudRiskIds
 WITH uid,
  totalIdFraudRisk,
  numberFraudRiskIds,
  totalIdFraudRisk/toFloat(numberFraudRiskIds) AS avgFraudIdRisk
 WHERE avgFraudIdRisk >= 0.25
 RETURN uid,
  totalIdFraudRisk,
  numberFraudRiskIds,
  averageFraudIdRisk
 ORDER BY totalIdFraudRisk DESC LIMIT 10
''')
pd.DataFrame([dict(record) for record in result])
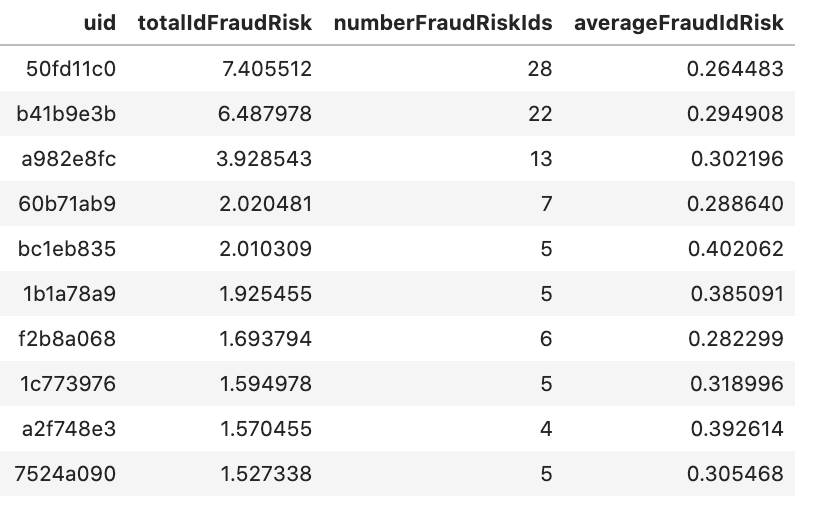
Пользователи в приведенном выше списке результатов отсортированы по объему идентифицирующей информации, которой они делятся с ранее отмеченными рисками мошенничества, причем те, у которых больше всего, находятся вверху. С технической точки зрения, эти пользователи ранжируются по общему риску мошенничества с идентификаторами, который равен сумме fraudRiskRatios от идентификаторов, к которым они подключены.
В запросе я также применяю ограничение на средний риск мошенничества, чтобы избежать пользователей, которые просто имеют много идентификаторов высокой степени (вероятно, IP-адреса прокси-сервера используются лишь небольшой долей пользователей, подверженных риску мошенничества). Этот тип фильтрации можно настроить в зависимости от варианта использования, чтобы получить правильный баланс между общим риском и средним риском.
В реальном случае обнаружения мошенничества эти результаты могут быть проверены аналитиками, чтобы пометить больше мошеннических учетных записей и расширить сообщества помеченных мошенников.
Использование схожести узлов для расширения мошеннических сообществ
Простые вычисления, такие как взвешенная степень центральности, хорошо работают для выявления подозрительных пользователей по всему графу, но что, если нас интересует, как пользователи связаны с определенным сообществом риска мошенничества или набором сообществ? Возможно, мы предполагаем, что сообщества пользователей риска мошенничества на самом деле больше, чем представлено в настоящее время, но у нас нет точных бизнес-правил для применения. Мы можем использовать алгоритмы подобия, чтобы помочь нам оценить и рекомендовать пользователей для этого.
GDS предлагает несколько алгоритмов подобия. В этом анализе я сосредоточусь на удачно названном алгоритме сходства узлов — подробнее о нем можно прочитать здесь. Сходство узлов хорошо распараллеливается и объяснимо. Он идентифицирует пары похожих узлов на основе простого вычисления сходства Жаккара. Таким образом, в то время как другие подходы к сходству на основе машинного обучения, такие как FastRP + KNN, описанные в этой статье, хорошо масштабируются в глобальном масштабе на очень больших графиках, сходство узлов — хороший выбор, когда важна объяснимость, и вы можете сузить вселенную сравнений до подмножества ваших данные.
Примеры сужения включают сосредоточение внимания только на отдельных сообществах, недавно добавленных пользователях или узлах в определенной близости от подмножества пользователей. В этом анализе мы выберем третий подход, определяя сходство между учетными записями пользователей, используя только узлы карты, устройства и IP-адреса, которые подключаются по крайней мере к одной учетной записи риска мошенничества из части 2.
Ниже я применяю три запроса для вычисления сходства узлов. Первый запрос включает фильтрацию идентификатора путем установки новой метки на узлах карты, устройства и IP-адреса, которые подключаются к учетным записям риска мошенничества. Первый запрос также взвешивает отношения по степени, обратной степени центральности, существенно преуменьшая важность идентификаторов, пропорциональную количеству других пользователей, к которым они подключаются.
Это важно, поскольку некоторые идентификаторы, в частности IP-адреса, могут подключаться к сотням или тысячам пользователей, и в этом случае идентификатор может быть очень общим (например, IP-адрес прокси-сервера) и не иметь отношения к подлинной личности пользователя. Второй и третий запросы проецируют граф и записывают отношения обратно в базу данных с оценкой, представляющей силу сходства между парами пользовательских узлов. Вы заметите, что я использую порог сходства 0,01 в третьем запросе, который предназначен для исключения слабых ассоциаций и сохранения релевантности сходства.
run(driver,'''
    MATCH(f:FraudRiskUser)-[:HAS_CC|HAS_IP|USED]->(n)
    WITH DISTINCT n
    MATCH(n)<-[r:HAS_CC|HAS_IP|USED]-(u)
    SET n:FraudSharedId
    SET r.inverseDegreeWeight = 1.0/(n.degree-1.0)
    RETURN count(DISTINCT n)
''')
[<Record count(DISTINCT n)=18182>]
run(driver, '''
    CALL gds.graph.create('similarity-projection',
        ['User', 'FraudSharedId'],
        ['HAS_CC', 'USED', 'HAS_IP'],
        {relationshipProperties: ['inverseDegreeWeight']}
    ) YIELD nodeCount, relationshipCount, createMillis
''')
[<Record nodeCount=51914 relationshipCount=692806 createMillis=425>]
run(driver, '''
    CALL gds.nodeSimilarity.write('similarity-projection',{
        writeRelationshipType: 'SIMILAR_IDS',
        writeProperty: 'score',
        similarityCutoff: 0.01,
        relationshipWeightProperty: 'inverseDegreeWeight'
    }) YIELD computeMillis, writeMillis, relationshipsWritten, similarityDistribution
''')
[<Record computeMillis=76164 writeMillis=8618 relationshipsWritten=314488 similarityDistribution={'p1': 0.023890316486358643, 'max': 1.0000075697898865, 'p5': 0.06617635488510132, 'p90': 0.5132293105125427, 'p50': 0.18832391500473022, 'p95': 0.8225058913230896, 'p10': 0.08744043111801147, 'p75': 0.31004709005355835, 'p99': 1.0000075697898865, 'p25': 0.12365764379501343, 'p100': 1.0000075697898865, 'min': 0.010002970695495605, 'mean': 0.25994297649439113, 'stdDev': 0.21765678101688074}>]
Оттуда мы можем запустить запрос Cypher, чтобы ранжировать пользователей по тому, насколько они похожи на известные сообщества риска мошенничества.
result = run(driver, '''
    MATCH (f:FraudRiskUser)
    WITH f.wccId AS componentId,
        count(*) AS numberOfUsers,
        collect(f) AS users
    UNWIND users AS f
    MATCH (f)-[s:SIMILAR_IDS]->(u:User)
    WHERE NOT u:FraudRiskUser AND numberOfUsers > 2
    RETURN u.guid AS userId,
        sum(s.score) AS totalScore,
        collect(DISTINCT componentId) AS closeToCommunityIds
    ORDER BY totalScore DESC
''')
pd.DataFrame([dict(record) for record in result])
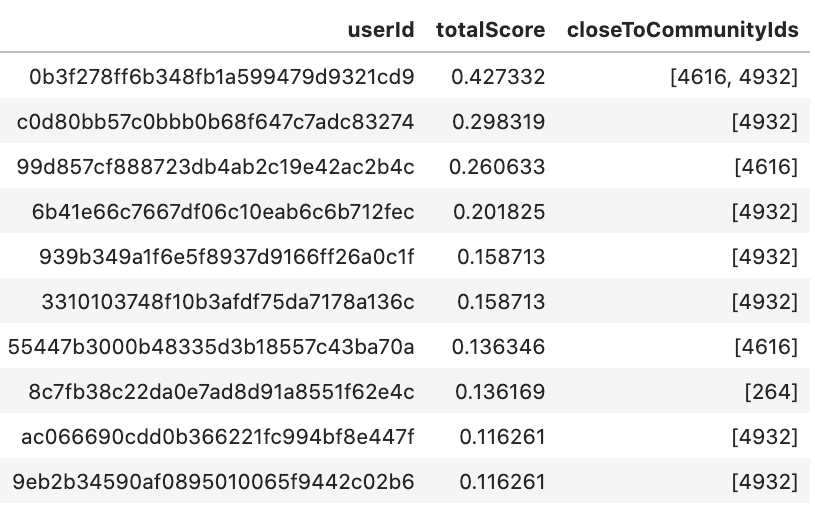
Давайте посмотрим на первого пользователя в списке, пользователя 0b3f278f..., в Neo4j Bloom. Эта учетная запись пользователя кажется интересной в том смысле, что она подключается к двум разным сообществам.

Вы можете увидеть, как этот пользователь подключается к двум сообществам риска мошенничества и как отношения сходства были основаны на общих IP-адресах. Этот пользователь, кажется, действует как своего рода мост между двумя сообществами, предполагая не только то, что пользователь, вероятно, является частью сообщества мошенников, но также и то, что эти два сообщества могут на самом деле отражать одно и то же.
Выводы
В целом, подобные метрики центральности и подобия быстро и легко реализуются с помощью Neo4j и GDS. Они могут помочь улучшить ваш подход к науке о данных, внедрив автоматизированные и частично контролируемые процессы, чтобы помочь в целенаправленной сортировке и выявлении подозрительных учетных записей пользователей на основе ранее помеченных данных. В следующей части мы покажем вам, как еще больше улучшить обнаружение мошенничества с помощью машинного обучения.
