Все для производства

ML — это не только обучение классификатора K-средних на данных Iris в блокноте Jupyter. Возможно, вы захотите обучить огромное количество данных с помощью сложной модели ML. при наличии высокотехнологичной инфраструктуры. Теперь это невозможно сделать с помощью одного инструмента. Нам нужна их коллекция!
В связи с всплеском интереса к созданию готовых к производству сквозных конвейеров машинного обучения постоянно растет спрос на правильный набор инструментов, который может масштабироваться быстрее, и активно разрабатывается.
В этой статье я расскажу о 5 инструментах с открытым исходным кодом, с которыми я столкнулся и использовал, которые могут помочь вам на нескольких этапах построения конвейеров машинного обучения.
Флайт
Гитхаб. Документы. "Сообщество"
Текущие развертывания: Spotify, Lyft, Freenome, GoJek и т. д.
Чтобы развернуть производственное машинное обучение с высокой скоростью разработки и без проблем с инфраструктурой, нам нужна платформа, которая могла бы помочь с аспектом Ops ML. А именно, нам нужна платформа, которая облегчает сотрудничество между командами, обрабатывает повторяющиеся запуски кода, не истощая ресурсы, поддерживает специалистов по данным, которые не любят вмешиваться в аспекты инфраструктуры, является масштабируемой и заслуживающей доверия, и этот список можно продолжить.
Flyte — это платформа автоматизации рабочих процессов, которая помогает автоматизировать критически важные конвейеры машинного обучения и данных. Он упрощает распределенное обучение, не имеет единой точки отказа, обеспечивает передачу данных и упрощает запуск инфраструктуры. Вам больше не нужно беспокоиться об управлении Ops ML с помощью Flyte.

Начать работу с Flyte довольно просто; установите Docker, Python, Git, запустите пару команд, и все готово!
Как развернуть? Все руководства по развертыванию и рекомендации собраны в разделе документации по развертыванию. Для некоторых развертываний может потребоваться опыт работы с Kubernetes и связанными с ним инструментами.
"Большие Надежды"
Гитхаб. Документы. "Сообщество"
Текущие развертывания: GitHub, Calm, Agero, Civis и т. д.
Данные не всегда такие, какими мы их ожидаем. Проверка данных всегда имеет решающее значение, чтобы гарантировать, что данные выглядят так, как мы хотим. Приложение «Большие надежды» помогает добиться того же самого — обеспечить качество данных до начала фактического процесса, будь то моделирование или анализ.
Большие надежды делают это с помощью ожиданий, которые являются утверждениями для данных. Это наборы, в которых мы должны описать, что мы ожидаем от данных. Кроме того, ожидания можно создать с помощью профилировщика данных. Я не тестировал эту функцию полностью, но она выглядит многообещающе!
После определения необходимой конфигурации и ожиданий Great Expectations выполняет проверку данных и выдает результаты. Чтобы улучшить результаты проверки данных, Great Expectations предлагает «документы данных» — удобный пользовательский интерфейс для просмотра того, что пошло не так.
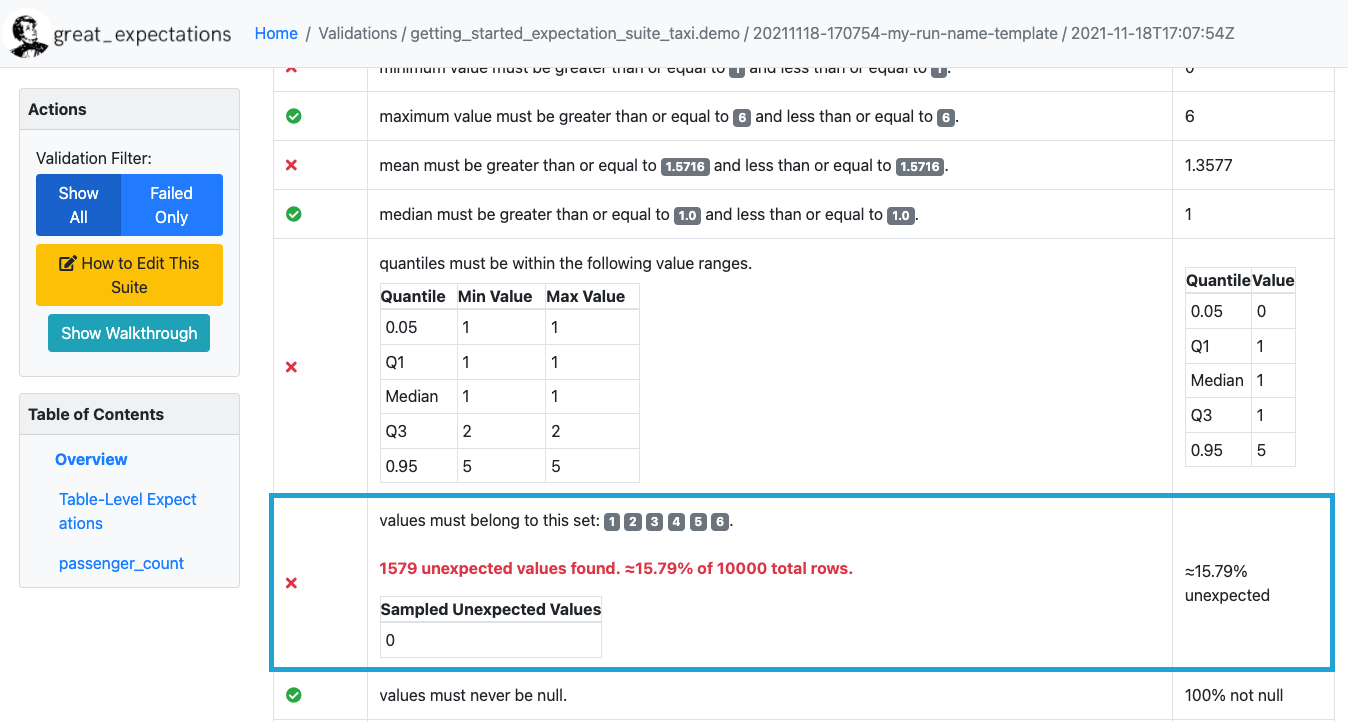
Как развернуть? Руководства по развертыванию включены в документацию. У него есть некоторые интеграции; однако автономное развертывание не должно быть слишком сложным.
"Праздник"
Гитхаб. Документы. "Сообщество"
Текущие развертывания: GoJek, Shopify, Salesforce, IBM и т. д.
Праздник — это функция, хранилище. В ML может быть много функций, если набор данных огромен. Хранилище функций полезно для управления и производства функций, достижения согласованности между обучением и обслуживанием данных, а также для отслеживания версий функций и происхождения. Feast опубликовал обширную статью под названием Что такое Feature Store? если вы хотите углубиться в концепцию хранилища функций.
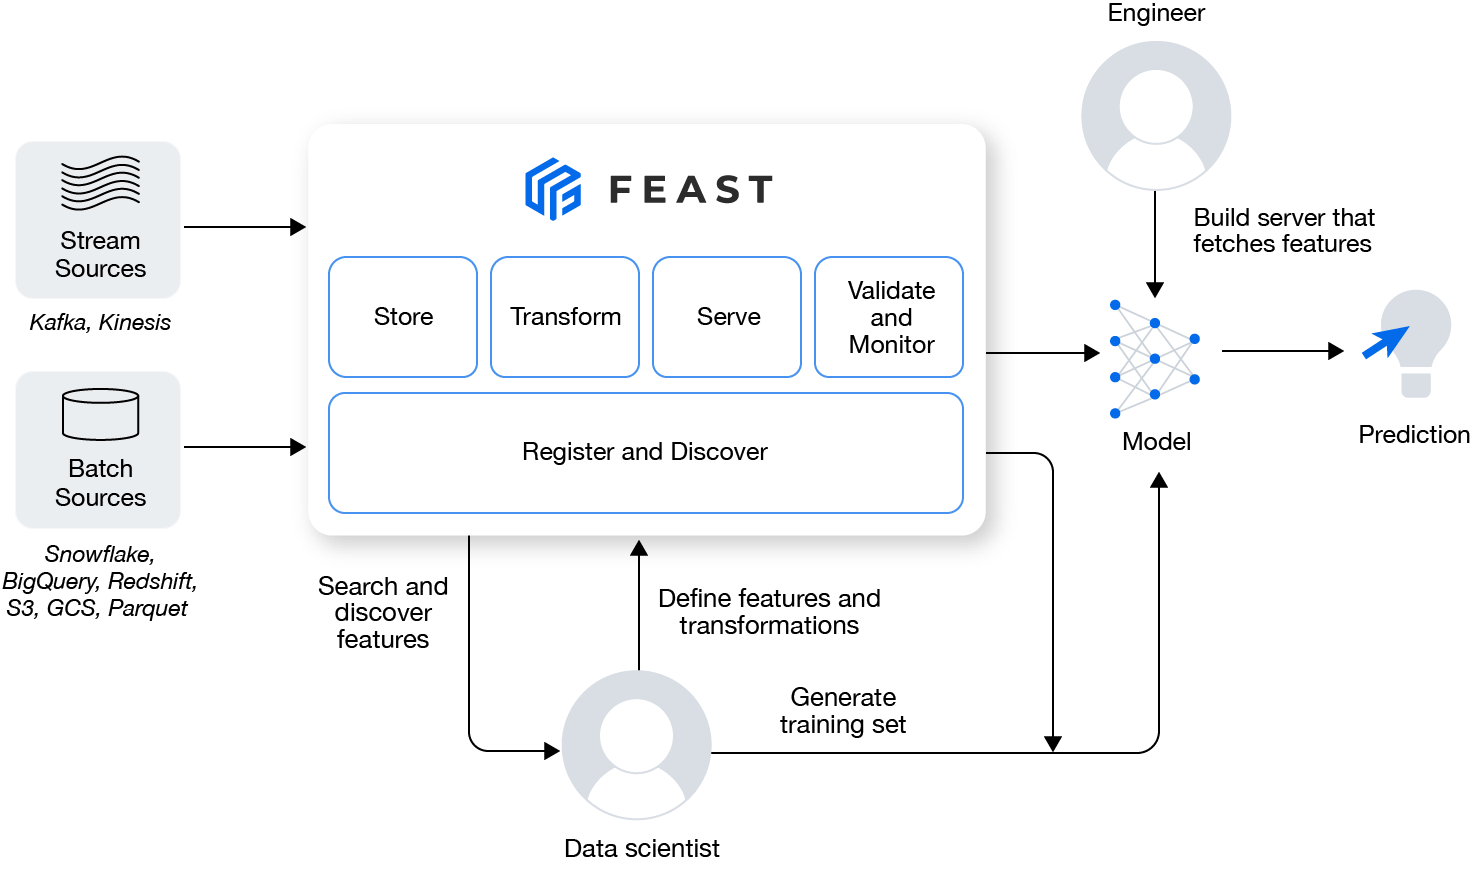
Один взаимодействует с хранилищем признаков в основном во время обучения и логического вывода. Во-первых, определения функций должны быть определены и зарегистрированы, обучающие данные могут быть сгенерированы с использованием хранилища функций, функции должны быть материализованы из автономного режима в онлайн-магазин, и, наконец, последние функции из интернет-магазина могут использоваться для логического вывода. .
Как развернуть? Естьподробное руководство по развертыванию Feast в рабочей среде. Развертывание требует автоматизации для упрощения использования в дальнейшем.
Хоровод
Если модели глубокого обучения (DL) плохо работают во время обучения с одним графическим процессором, нам может понадобиться много из них для распределения рабочей нагрузки, чтобы ускорить процесс. Хоровод — это распределенная обучающая среда для TensorFlow, Keras, PyTorch и Apache MXNet. Это упрощает масштабирование до тысяч графических процессоров, даже если код совместим с одним графическим процессором (конечно, код должен использовать API-интерфейсы Horovod).
Основное преимущество Horovod заключается в том, что он работает с несколькими библиотеками DL — выберите инфраструктуру DL, вызовите правильные API и вуаля! результаты должны быть получены за гораздо меньшее время.
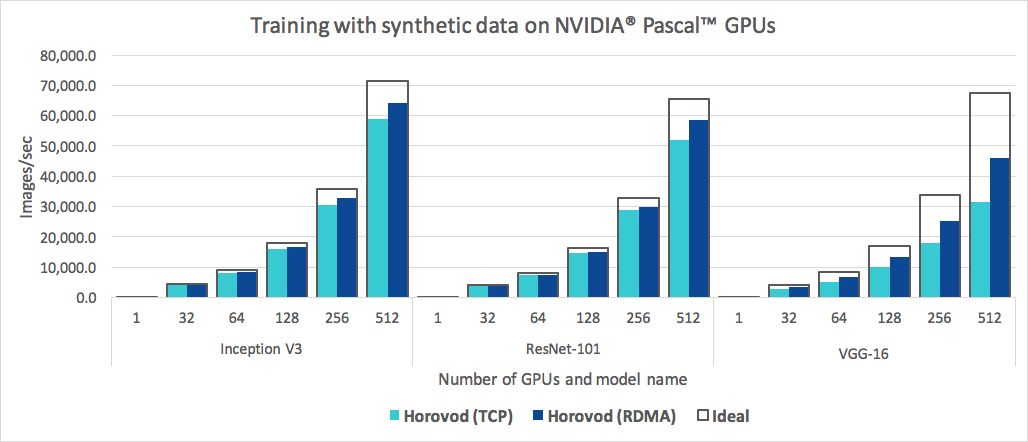
Как развернуть? Руководство по установке должно помочь с настройкой среды. Если есть Dockerfile, внимательно вставьте все инструкции по установке, будь то MPI, NCCL или соответствующие переменные среды.
Сервер инференса Тритон
Логические выводы — важный аспект машинного обучения. Поскольку это будет со стороны пользователя, мы не можем учитывать скорость — она должна быть быстрой и точной. Когда вы открываете Netflix, вы получаете рекомендации фильмов на лету. Представьте себе скорость, с которой должны генерироваться прогнозы, и количество пользователей, которые могут одновременно получать доступ к Netflix! Это может быть довольно большое число, не так ли?
Сервер логического вывода NVIDIA Triton может упростить развертывание широкого спектра моделей, принадлежащих различным платформам, и легко масштабироваться. Он может работать одновременно на нескольких графических процессорах и предлагает множество функций.

Чтобы запустить Triton, извлеките уже существующий образ Docker и запустите контейнер, который, в свою очередь, раскрутит сервер.
Как развернуть? Для развертывания Triton с помощью Kubernetes и Helm существуют руководства GCP, AWS и NVIDIA FleetCommand. Проект с открытым исходным кодом под названием transformer-deploy предоставляет готовый сервер логических выводов CPU/GPU на базе моделей преобразователей NVIDIA Triton для Hugging Face, чтобы упростить процесс развертывания.
Спасибо за прочтение! Сообщите мне, какие инструменты вы используете для создания конвейеров машинного обучения.
