
Реализация стохастической глубины/пути падения в PyTorch
DropPath доступен в моей библиотеке компьютерного зрения очки.
Код находится здесь, интерактивную версию этой статьи можно скачать здесь.
Введение
Сегодня мы собираемся реализовать Stochastic Depth, также известную как Drop Path, в PyTorch! Стохастическая глубина, представленная Гао Хуангом и др., — это метод деактивации некоторых слоев во время обучения. Мы будем придерживаться DropPath.
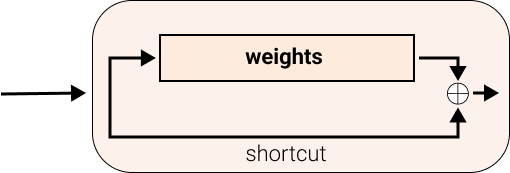
Давайте взглянем на обычный блок ResNet, который использует остаточные соединения (как сейчас почти все модели). Если вы не знакомы с ResNet, у меня есть статья, показывающая, как это реализовать.
По сути, выход блока добавляется к его входу: output = block(input) + input. Это называется остаточным подключением.
Здесь мы видим четыре ResnNet-подобных блока, один за другим.

Stochastic Depth/Drop Path деактивирует часть веса блока

Выполнение
Давайте начнем с импорта нашего лучшего друга, torch
import torch
from torch import nn
from torch import Tensor
Мы можем определить тензор 4D (batch x channels x height x width), в нашем случае давайте просто отправим 4 изображения с одним пикселем каждое, чтобы было легче увидеть, что происходит :)
x = torch.ones((4, 1, 1, 1))
Нам нужен тензор формы batch x 1 x 1 x 1, который будет использоваться для обнуления некоторых элементов в пакете с помощью заданной задачи. Бернулли на помощь!
keep_prob: float = .5
mask: Tensor = x.new_empty(x.shape[0], 1, 1, 1).bernoulli_(keep_prob)
# mask =
tensor([[[[1.]]],

        [[[1.]]],

        [[[0.]]],

        [[[0.]]]])
Кстати, это эквивалентно
mask: Tensor = (torch.rand(x.shape[0], 1, 1, 1) > keep_prob).float()
Мы хотим установить некоторые из элементов x равными нулю, поскольку наши маски состоят из 0s и 1s, мы можем умножить их на x. Прежде чем мы это сделаем, нам нужно разделить x на keep_prob, чтобы уменьшить активацию входа во время обучения, см. cs231n. Так
x_scaled : Tensor = x / keep_prob
Окончательно
output: Tensor = x_scaled * mask
# output =
tensor([[[[2.]]],

        [[[0.]]],

        [[[2.]]],

        [[[2.]]]])
Посмотрите, как некоторые элементы в пакете были установлены на ноль. Мы можем объединить это в функцию
def drop_path(x: Tensor, keep_prob: float = 1.0) -> Tensor:
    mask: Tensor = x.new_empty(x.shape[0], 1, 1, 1).bernoulli_(keep_prob)
    x_scaled: Tensor = x / keep_prob
    return x_scaled * mask

drop_path(x, keep_prob=0.5)
Мы также можем выполнять операции на месте
def drop_path(x: Tensor, keep_prob: float = 1.0) -> Tensor:
    mask: Tensor = x.new_empty(x.shape[0], 1, 1, 1).bernoulli_(keep_prob)
    x.div_(keep_prob)
    x.mul_(mask)
    return x


drop_path(x, keep_prob=0.5)
Однако мы можем захотеть использовать x в другом месте, и деление x или mask на keep_prob будет таким же. Приступаем к окончательной реализации
def drop_path(x: Tensor, keep_prob: float = 1.0, inplace: bool = False) -> Tensor:
    mask: Tensor = x.new_empty(x.shape[0], 1, 1, 1).bernoulli_(keep_prob)
    mask.div_(keep_prob)
    if inplace:
        x.mul_(mask)
    else:
        x = x * mask
    return x

x = torch.ones((4, 1, 1, 1))
drop_path(x, keep_prob=0.5)
drop_path работает только для 2D-данных, нам нужно автоматически вычислить количество измерений из входного размера, чтобы он работал для любого времени данных.
def drop_path(x: Tensor, keep_prob: float = 1.0, inplace: bool = False) -> Tensor:
    mask_shape: Tuple[int] = (x.shape[0],) + (1,) * (x.ndim - 1)
    # remember tuples have the * operator -> (1,) * 3 = (1,1,1)
    mask: Tensor = x.new_empty(mask_shape).bernoulli_(keep_prob)
    mask.div_(keep_prob)
    if inplace:
        x.mul_(mask)
    else:
        x = x * mask
    return x
Давайте создадим красивый DropPath nn.Module
class DropPath(nn.Module):
    def __init__(self, p: float = 0.5, inplace: bool = False):
        super().__init__()
        self.p = p
        self.inplace = inplace

    def forward(self, x: Tensor) -> Tensor:
        if self.training and self.p > 0:
            x = drop_path(x, self.p, self.inplace)
        return x

    def __repr__(self):
        return f"{self.__class__.__name__}(p={self.p})"
Использование с остаточными соединениями
У нас есть свои DropPath, круто! Как мы это используем? Нам нужен остаточный блок, мы можем использовать классический блок ResNet: старый добрый друг BottleNeckBlock
from torch import nn


class ConvBnAct(nn.Sequential):
    def __init__(self, in_features: int, out_features: int, kernel_size=1):
        super().__init__(
            nn.Conv2d(in_features, out_features, kernel_size=kernel_size, padding=kernel_size // 2),
            nn.BatchNorm2d(out_features),
            nn.ReLU()
        )


class BottleNeck(nn.Module):
    def __init__(self, in_features: int, out_features: int, reduction: int = 4):
        super().__init__()
        self.block = nn.Sequential(
            # wide -> narrow
            ConvBnAct(in_features, out_features // reduction, kernel_size=1),
            # narrow -> narrow
            ConvBnAct( out_features // reduction, out_features // reduction, kernel_size=3),
            # wide -> narrow
            ConvBnAct( out_features // reduction, out_features, kernel_size=1),
        )
        # I am lazy, no shortcut etc

    def forward(self, x: Tensor) -> Tensor:
        res = x
        x = self.block(x)
        return x + res


BottleNeck(64, 64)(torch.ones((1,64, 28, 28)))
Чтобы деактивировать блок, операция x + res должна быть равна res, поэтому наше DropPath должно быть применено после блока.
class BottleNeck(nn.Module):
    def __init__(self, in_features: int, out_features: int, reduction: int = 4):
        super().__init__()
        self.block = nn.Sequential(
            # wide -> narrow
            ConvBnAct(in_features, out_features // reduction, kernel_size=1),
            # narrow -> narrow
            ConvBnAct( out_features // reduction, out_features // reduction, kernel_size=3),
            # wide -> narrow
            ConvBnAct( out_features // reduction, out_features, kernel_size=1),
        )
        # I am lazy, no shortcut etc
        self.drop_path = DropPath()

    def forward(self, x: Tensor) -> Tensor:
        res = x
        x = self.block(x)
        x = self.drop_path(x)
        return x + res

BottleNeck(64, 64)(torch.ones((1,64, 28, 28)))
Тада! Теперь случайным образом наш .block будет полностью пропущен!
Заключение
В этой статье мы увидели, как реализовать DropPath и использовать его внутри остаточного блока. Надеюсь, когда вы прочтете/увидите траекторию падения/стохастическую глубину, вы поймете, как это делается.
Заботиться :)
Франческо
