В большинстве случаев нам не нужно думать о стоимости новых ресурсов. В большинстве случаев мы можем взять новый и доверить сборщику мусора, который заберет его за нами. Но когда выделение ресурсов становится нашим узким местом, осторожное применение соответствующего пула ресурсов может иметь большое значение.
Мне нужно объединить ресурсы?
No.
Или, по крайней мере, пока. Методы, используемые для пула ресурсов, вносят сложность, которая часто может сделать наш код менее читабельным, менее удобным в обслуживании и более подверженным ошибкам. Может быть полезно задать наши обычные вопросы об узких местах, прежде чем решить, действительно ли нам нужно объединять ресурсы.
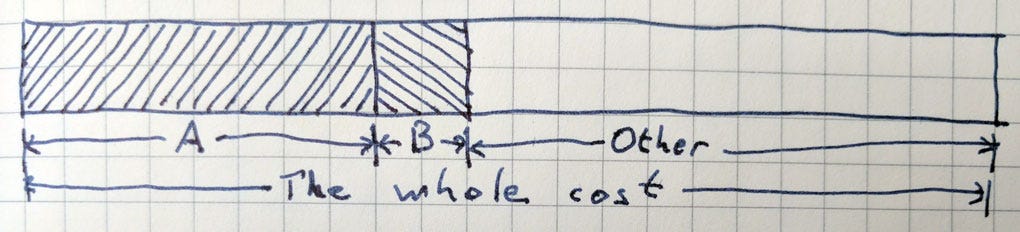
Является ли стоимость этой части системы значительной частью всей системы?
Например, запись в пакет журналов, который сжимает и разрезает структурированные журналы для отправки по UDP может занять лишь небольшую часть запроса к нашей службе, если мы регистрируем только ошибки, но большую часть, если мы также регистрация нескольких событий на запрос и ничего больше не делает.
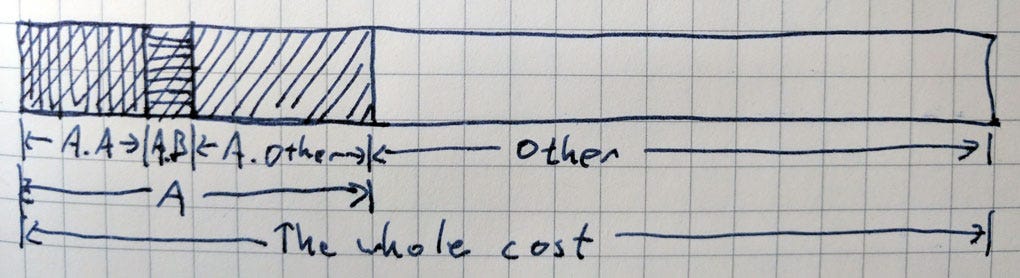
Является ли стоимость создания новых ресурсов значительной частью этой части системы?
В нашем примере снова, затраты на выделение новых буферов для хранения наших заархивированных сообщений могут составлять большую часть операции, которая немного больше, чем zip, slice, send.
Если мы ответим утвердительно на эти вопросы, нам, вероятно, следует подумать об объединении ресурсов.
Как выбрать стратегию?
Какие у нас ограничения? Мы уже знаем, что накладные расходы на выделение ресурсов в нашей операции велики. Одного этого недостаточно, чтобы направлять нас. У нас могут быть большие накладные расходы, потому что у нас есть небольшая процедура, которая вызывается достаточно часто, чтобы выделять узкие места обычно незначительно. У нас может быть процедура, которая использует относительно дорогой ресурс, такой как сетевое соединение или временный файл, который вызывается скачками через нерегулярные промежутки времени. Эти случаи представляют собой крайности того, с чем мы, вероятно, столкнемся, и они требуют различных подходов к объединению ресурсов.
Мы можем разбить эти стратегии по двум осям: количество времени простоя между использованиями ресурса и количество колебаний в размере пула. Может ли ресурс простаивать дольше времени между сборками мусора? Что лучше: дождаться появления нового ресурса или выделить новый, когда в пуле не осталось ресурсов? Давайте взглянем на четыре решения, которые охватывают эту область.
Быстрое повторное использование в статическом пуле
Если наша операция интенсивно используется, а стоимость нового ресурса слишком высока, чтобы оправдать выделение нового ресурса, когда пул пуст, одна из стратегий, которые мы можем использовать, - это пул рабочих. Следующий пул рабочих управляет доступом к bufio.Writer. Хотя этот пример совершенно бесполезен в его нынешнем виде, запись в bufio.Writer является полезной заменой для множества операций (кодирование, архивирование и т. Д.). Мы постараемся использовать эту основную идею для всех наших примеров.
Этот подход позволяет нам выделять буфер на время жизни каждого рабочего, а не только на время жизни Write вызова. Все расходы по распределению (в данном случае байтовый фрагмент в bufio.Writer) происходят до того, как рабочий начинает принимать работу. Мы также повторно используем ту же writeResults переменную. Когда мы исследуем некоторые другие подходы к объединению ресурсов, мы увидим тот же базовый паттерн, что и у воркера: подготовить новый ресурс, получить ресурс для использования, использовать ресурс, подготовить ресурс для повторного использования.
// Prepare a new resource & get a resource for use
buf := bufio.NewWriter(uw)
var res writeResults
for arg := range ch {
  // Use the resource
  res.n, res.err = buf.Write(arg.p)
  buf.Flush()
  arg.resCh <- res
  // Prepare the resource for reuse
  buf.Reset(uw)
  res.n, res.err = 0, nil
}
Здесь следует отметить одну важную вещь: когда это реализовано, общее использование ресурсов не является статическим. Когда все рабочие будут заняты, начнут накапливаться новые Write вызовы, все заблокированные в ожидании доступного рабочего. Поэкспериментируйте с некоторыми идеями для решения этой проблемы. Какие еще проблемы возникают в результате?
Возможное повторное использование в статическом пуле
Если в нашей операции наблюдается более спорадическое использование, когда время простоя ресурса, вероятно, будет продолжительным, рабочие пулы могут быть менее привлекательными. Вместо этого мы можем держать наши заранее выделенные ресурсы под рукой в свободном списке.
Эта реализация и реализация рабочего пула, вероятно, могут быть взаимозаменяемыми в большинстве случаев. Рабочие пулы более полезны при использовании в параллельных конвейерах, в то время как свободные списки более полезны для управления дорогостоящими ресурсами, используемыми время от времени. Как бы вы решили проблему емкости из примера пула рабочих?
Возможное повторное использование в динамическом пуле
До сих пор мы имели дело исключительно со статическими пулами ресурсов. Статические пулы ресурсов делают важное предположение: стоимость выделения нового ресурса выше, чем стоимость ожидания, когда он станет доступным. В результате мы должны уделять особое внимание тому, что происходит, когда мы достигаем предельной мощности. Если мы опровергаем это предположение и утверждаем, что стоимость ожидания доступности ресурса (или удержания достаточного количества ресурсов для обработки пиковой мощности) выше, чем стоимость выделения нового ресурса, мы придем к динамическому пулу. Давайте превратим этот бесплатный список фиксированного размера в динамический.
Это не сильно отличается от бесплатного списка фиксированного размера. Он может быть даже загружен в конструктор вместо выделения при первом использовании. С помощью этого решения у нас может быть гораздо меньший пул. Вместо того, чтобы иметь емкость пула, превышающую ожидаемое пиковое использование, нам нужна только емкость пула, превышающая ожидаемый скачок использования: эффективный размер пула - это количество используемых ресурсов и емкость, а не просто емкость. Это решает проблему блокировки при достижении емкости, но при этом теряется предсказуемое использование ресурсов, которое мы имели при использовании списка свободных мест фиксированного размера.
Этот подход особенно полезен, если для уничтожения ресурса, который мы используем, требуется нечто большее, чем просто сборка мусора. Пул открытых сетевых подключений может потребоваться закрыть, когда они будут уничтожены. Пул временных файлов может потребоваться закрыть, а затем удалить при уничтожении. Этот вид бесплатного списка присутствует во многих пакетах и описан в Эффективном использовании. Поиграйте с этой реализацией.
Быстрое повторное использование в динамическом пуле
В небольшом количестве случаев нам нужен действительно динамический пул ресурсов, которые, вероятно, будут повторно использованы, прежде чем они будут собраны как мусор. Эти ресурсы всегда временны, но их можно использовать повторно несколько раз, прежде чем они будут уничтожены. Это то, для чего был создан sync.Pool.
Это не сильно отличается от динамического списка свободных мест. Основные отличия заключаются в том, что динамический список свободных ресурсов может обрабатывать ресурсы, отличные от распределения памяти (файлы, сетевые соединения и т. Д.), А sync.Pool ограничивает избыточный ресурс по времени, а не по счетчику. Когда приходит сборщик мусора, избыточные ресурсы могут быть сведены к нулю, но до тех пор, пока это не произойдет, может существовать огромное количество ресурсов, ожидающих повторного использования или уничтожения. Поиграйтесь и с этим.
Возможные ловушки
Методы, используемые для пула ресурсов, вносят сложность, которая часто может сделать наш код менее читабельным, менее удобным в обслуживании и более подверженным ошибкам.
Мы отмечали это ранее, и хотя эти примеры не кажутся намного более сложными, чем решение без пулов, есть пара общих проблем, которые будут возникать.
Не совсем чистый
Этот укусил меня несколько раз. Прежде чем возвращать ресурс в пул (или завершать работу с пулом рабочих), вы должны быть уверены, что ресурс готов к использованию точно как новый.
// reslice a byte slice to zero length (the capacity will remain)
b = b[:0]
// reset the bytes buffer (the capacity will remain)
buf.Reset()
// clear the contents of a file and go back to the start
err := f.Truncate(0)
...
pos, err := f.Seek(0,0)
Я однажды забыл Seek для временных файлов в пуле - файлы, которые были повторно использованы, были загружены в S3 с таким количеством нулей, сколько байтов было при предыдущем использовании.
Не совсем сделано
Чаще всего эти пулы используются для повторного использования байтовых срезов прямо или косвенно через bytes.Buffer или другой подобный тип, поддерживаемый байтовым срезом. Если мы не сделаем copy нашего байтового среза, мы не сможем вернуть его в пул, пока не узнаем, что каждое использование этого среза и массива, который его поддерживает, завершено. . В противном случае мы, вероятно, начнем перезаписывать содержимое резервного массива. Здесь лучше избегать добавления каких-либо дополнительных уровней параллелизма в работу.
Не совсем там больше
Еще одна ловушка, на которую следует обратить внимание, скорее всего, произойдет при объединении сетевых подключений или других ресурсов, которые могут быть потеряны. Такое событие может серьезно повлиять на список свободных фиксированного размера или рабочий пул. Нам нужно будет убедиться, что ресурс по-прежнему жизнеспособен, прежде чем использовать его, а если это не так, нам, возможно, придется его заменить.
Выводы
Есть несколько способов повторно использовать ресурсы. У всех есть разные компромиссы. Все они имеют один общий компромисс: добавление производительности добавляет сложности. У нас возникнет соблазн бросить лужи на наши проблемы, но нам следует избегать этого. Вместо этого, ознакомившись с основными концепциями, лежащими в основе этих пулов ресурсов, мы можем создавать наши простые решения с немного большей предусмотрительностью. Дорогие ресурсы почти всегда разделяют один и тот же базовый жизненный цикл с объединением или без объединения: подготовка, использование, очистка. Помня об этом жизненном цикле при создании нашего простого решения, мы можем избежать распространенных ошибок и значительно упростить реализацию пула ресурсов и сделать ее менее подверженной ошибкам.
Еще несколько вариантов пулов ресурсов:
- Https://blog.cloudflare.com/recycling-memory-buffers-in-go/
- Https://dominik.honnef.co/go-tip/2014-01-10/#syncpool - краткое изложение
sync.Poolв стандартном пакете - Https://elithrar.github.io/article/using-buffer-pools-with-go/
