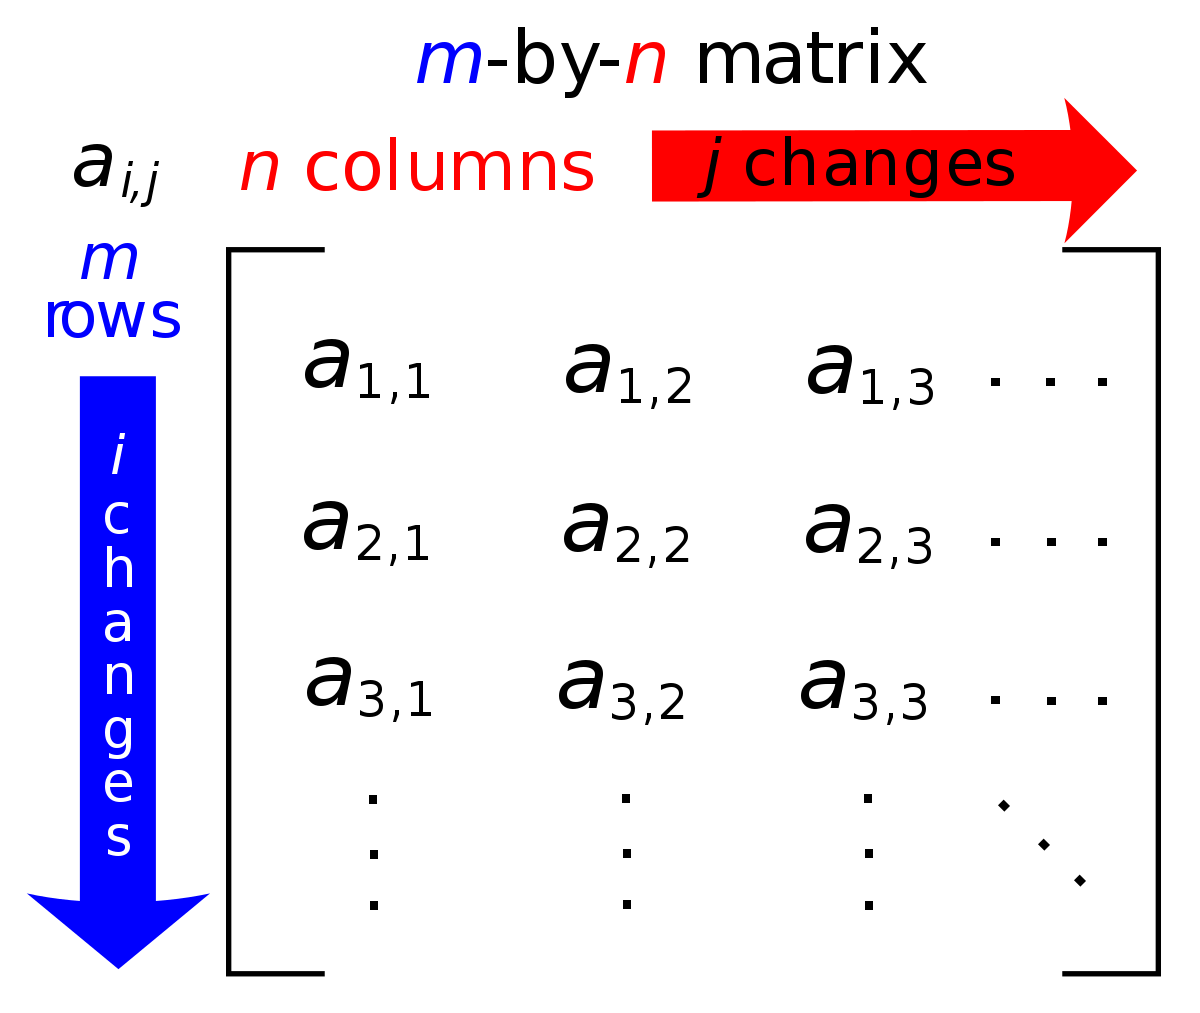
Умножение матрицы - одна из утомительных вещей, которыми мы занимались в школах. По мере увеличения размеров матрицы время, необходимое для завершения расчета, также увеличивается. Даже для компьютеров проблема есть.
В этой статье мы рассмотрим методы, которые могут оптимизировать матричное умножение несколькими способами. В конце мы собираемся проанализировать производительность традиционного умножения матриц, умножения матриц с использованием параллельных циклов For и оптимизированного умножения матриц с использованием параллельных циклов For. Мы собираемся запустить эту программу умножения матриц для квадратов матриц размером от 200 до 2ooo с шагом 200.
Для продолжения вам могут потребоваться следующие требования.
- Язык программирования C
- OpenMP
Давайте сначала посмотрим на основную математику умножения матриц.
Умножение матриц
Рассмотрим произвольные матрицы A и B. Поскольку матрицы квадратные, n = m = p.

Итак, итоговая матрица AB может быть получена следующим образом:

Создать случайную квадратную матрицу
Давайте приступим к реализации, создав случайные матрицы для умножения. Здесь мы используем функцию malloc для динамического распределения памяти в куче. Потому что при тестировании приходится иметь дело с матрицами разных размеров.
typedef double TYPE;
#define MAX_VAL 1000
#define MIN_VAL 1
TYPE** randomSquareMatrix(int dimension){
	/*
		Generate 2 dimensional random TYPE matrix.
	*/

	TYPE** matrix = malloc(dimension * sizeof(TYPE*));

	for(int i=0; i<dimension; i++){
		matrix[i] = malloc(dimension * sizeof(TYPE));
	}

	//Random seed
	srandom(time(0)+clock()+random());

	#pragma omp parallel for
	for(int i=0; i<dimension; i++){
		for(int j=0; j<dimension; j++){
			matrix[i][j] = rand() % MAX_VAL + MIN_VAL;
		}
	}

	return matrix;
}
Здесь мы определили тип данных как double, который может быть изменен в зависимости от варианта использования. Оператор #pragma omp parallel for выполняет распараллеливание цикла, что позволяет более эффективно инициализировать матрицу.
Нам также понадобится квадратная матрица с нулевыми значениями для хранения ответа. Это может быть реализовано таким же образом, как и раньше, путем инициализации нулем, а не случайным значением.
Традиционное матричное умножение
Не вдаваясь в подробности о производительности, ниже приводится прямая реализация умножения матриц. Операции будут выполняться последовательно для каждого элемента в результирующей матрице. Здесь matrixA и matrixB - это входные матрицы, где matrixC - результирующая матрица. Итак, мы должны передать результирующую матрицу в функцию в качестве ссылки.
double sequentialMultiply(TYPE** matrixA, TYPE** matrixB, TYPE** matrixC, int dimension){

	struct timeval t0, t1;
	gettimeofday(&t0, 0);

	for(int i=0; i<dimension; i++){
		for(int j=0; j<dimension; j++){
			for(int k=0; k<dimension; k++){
				matrixC[i][j] += matrixA[i][k] * matrixB[k][j];
			}
		}
	}

	gettimeofday(&t1, 0);
	double elapsed = (t1.tv_sec-t0.tv_sec) * 1.0f + (t1.tv_usec - t0.tv_usec) / 1000000.0f;

	return elapsed;
}
В этой функции он вернет время, затраченное на завершение процесса. Далее мы рассмотрим, как мы используем для этого параллельные циклы for.
Умножение матриц с использованием параллелизма для циклов
Когда вы собираетесь реализовать распараллеливание циклов в своем алгоритме, вы можете использовать библиотеку, такую как OpenMP, чтобы упростить сложную работу, или вы можете использовать свою собственную реализацию с потоками, где вам нужно обрабатывать балансировку нагрузки, условия гонки и т. Д. Для этого урока я собираюсь придерживаться библиотеки OpenMP. Нам просто нужно добавить несколько линий, чтобы сделать эту штуку параллельной.
double parallelMultiply(TYPE** matrixA, TYPE** matrixB, TYPE** matrixC, int dimension){

	struct timeval t0, t1;
	gettimeofday(&t0, 0);

	#pragma omp parallel for
	for(int i=0; i<dimension; i++){
		for(int j=0; j<dimension; j++){
			for(int k=0; k<dimension; k++){
				matrixC[i][j] += matrixA[i][k] * matrixB[k][j];
			}
		}
	}

	gettimeofday(&t1, 0);
	double elapsed = (t1.tv_sec-t0.tv_sec) * 1.0f + (t1.tv_usec - t0.tv_usec) / 1000000.0f;

	return elapsed;
}
Здесь мы использовали #pragma omp parallel для распараллеливания самого внешнего цикла for. Используя этот оператор, он делегирует части цикла for разным потокам. Это эффективная реализация? Да, но мы не можем очистить руки, просто используя это утверждение, потому что есть факты, которые мы не учли для дальнейшей оптимизации.
Далее мы посмотрим, как можно улучшить наше решение.
Оптимизированное умножение матриц с использованием параллельного цикла
Каковы основные проблемы в приведенной выше реализации? Мы не производили здесь оптимизацию памяти. Без оптимизации доступа к памяти процессор не мог сразу выполнять инструкции для данных.
Поскольку наши матрицы хранятся в куче, получить к ним доступ непросто, поскольку они хранятся в куче. Эти данные лучше перенести из кучи в стек до начала процесса умножения. Итак, нам нужно изначально установить контейнеры для этих данных.
TYPE flatA[MAX_DIM];
TYPE flatB[MAX_DIM];
Какова цель использования одномерных массивов для хранения в 2D-матрицах? Потому что, хотя мы воспринимаем квадратную матрицу как двумерную вещь, компьютерная память гораздо более последовательна. Лучше при последовательном доступе. Когда дело доходит до кеширования, он предпочитает связанные данные вместе. В некоторых алгоритмах кэширования предполагается, что данные, необходимые для следующей операции, будут доступны в следующей области памяти. Затем он может легко загрузить эти данные в кеш до того, как ЦП запросит эти данные.
Шаги реализации оптимизированного умножения матриц приведены ниже.
- Объедините общие вычисления в одном месте
В большинстве случаев мы не рассматриваем небольшие вычисления, которые избыточны для программы, где производительность не требуется, но требуется ясность.
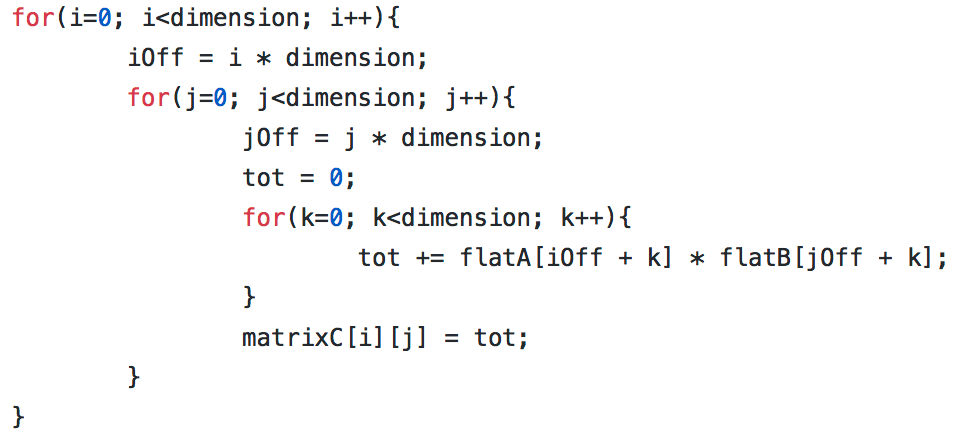
Вычисления iOff и jOff являются избыточными вычислениями для итерации k. Итак, мы произвели эти расчеты на месте и получили доступ там, где это требовалось.
2. Реализация алгоритма, удобного для кеширования
Все мы знаем, что память имеет линейное устройство. Итак, каждый N-мерный массив последовательно упорядочивается внутри памяти. В этом примере мы можем преобразовать двумерные входные матрицы в одномерные матрицы строк и столбцов. Почему нам нужно использовать и мажор строки, и мажор столбца. Просто чтобы свести к минимуму переходы между ячейками памяти, в которых все связанные элементы находятся вместе в памяти. Это также уменьшит количество промахов в кеше.
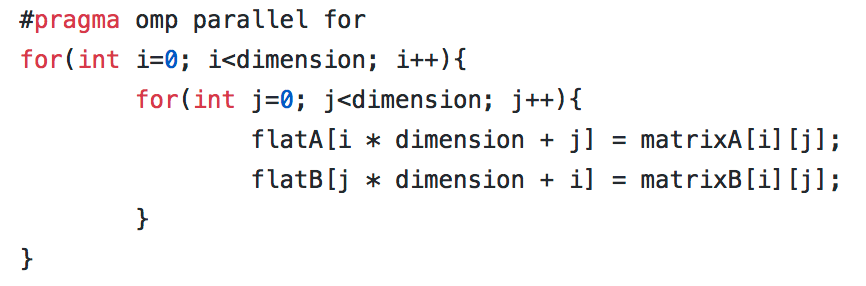
Например: matrixA * matrixB
Мы можем преобразовать matirxA в основную строку и матрицуB в основную структуру столбца. Операция также распараллелилась с использованием параллельных циклов for.
3. Эффективное использование стека или кучи памяти
Это стек быстрого доступа, а не куча памяти. Но у стека ограниченная память. Мы сохранили большие объемы входной памяти в динамической памяти. Для эффективных промежуточных вычислений мы использовали стек с предопределенным распределением памяти.
double optimizedParallelMultiply(TYPE** matrixA, TYPE** matrixB, TYPE** matrixC, int dimension){

	int i, j, k, iOff, jOff;
	TYPE tot;

	struct timeval t0, t1;
	gettimeofday(&t0, 0);
	convert(matrixA, matrixB, dimension);
	#pragma omp parallel shared(matrixC) private(i, j, k, iOff, jOff, tot) num_threads(40)
	{
		#pragma omp for schedule(static)
		for(i=0; i<dimension; i++){
			iOff = i * dimension;
			for(j=0; j<dimension; j++){
				jOff = j * dimension;
				tot = 0;
				for(k=0; k<dimension; k++){
					tot += flatA[iOff + k] * flatB[jOff + k];
				}
				matrixC[i][j] = tot;
			}
		}
	}

	gettimeofday(&t1, 0);
	double elapsed = (t1.tv_sec-t0.tv_sec) * 1.0f + (t1.tv_usec - t0.tv_usec) / 1000000.0f;

	return elapsed;
}
Здесь мы запустили 40 потоков для выполнения процесса умножения. Внутри мы разделили рабочую нагрузку статическим образом, предполагая, что каждая инструкция умножения займет одинаковое количество времени. Поскольку мы имеем дело с размерами 200, 400, 600, 800, 1000, 1200, 1400, 1600, 1800 и 2000, рабочая нагрузка может быть разделена поровну между потоками.
В omp мы явно заявили, что matrixC является общим ресурсом, чтобы избежать состояния гонки.
Анализируйте производительность
В следующей таблице указано время, затраченное для каждого измерения при каждом подходе.

Следующий график даст вам лучшее представление о приращении ускорения в каждой точке.

Полный код с тестовыми примерами
Полная реализация данного сценария доступна в следующем репозитории Github.
Https://github.com/roshanmadhushanka/Parallel-Matrix-Multiply/blob/master/pmp.c
