Это моя вторая часть обзора обучения Deep Q. Вы можете найти первую запись здесь. Пожалуйста, проверьте его, он всеобъемлющий. Далее следует обзор методов на основе политик и расчетов градиентов политик. Все уравнения написаны в Latex и Word.
Методы критики актеров — это что-то вроде новой интересной темы, а также новый подход к решению очень сложных проблем, таких как Alpha-go, с использованием Actor, смоделированного как Политика, которая диктует действия и критикасмоделирована как Q-функция, который оценивает решения агента и, следовательно, улучшает политику с помощью итераций.
- Взято с замечательной ссылки, где с помощью RL играют в игру Старкрафт-2.
- На меня сильно повлияло на то, чтобы написать и изучить больше глубокого обучения и RL, от этого аспиранта Калифорнийского университета в Беркли, у которого есть несколько замечательных руководств, Ссылка
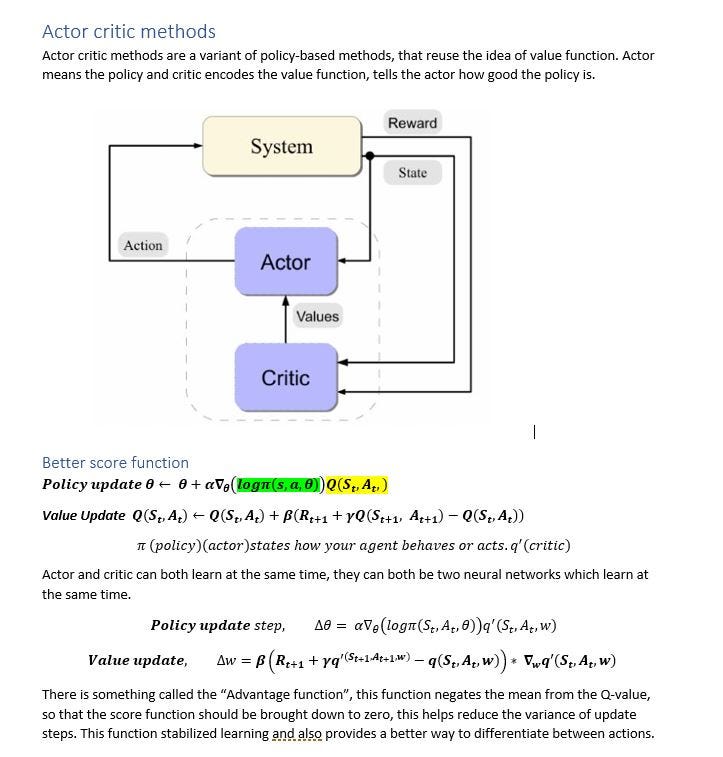
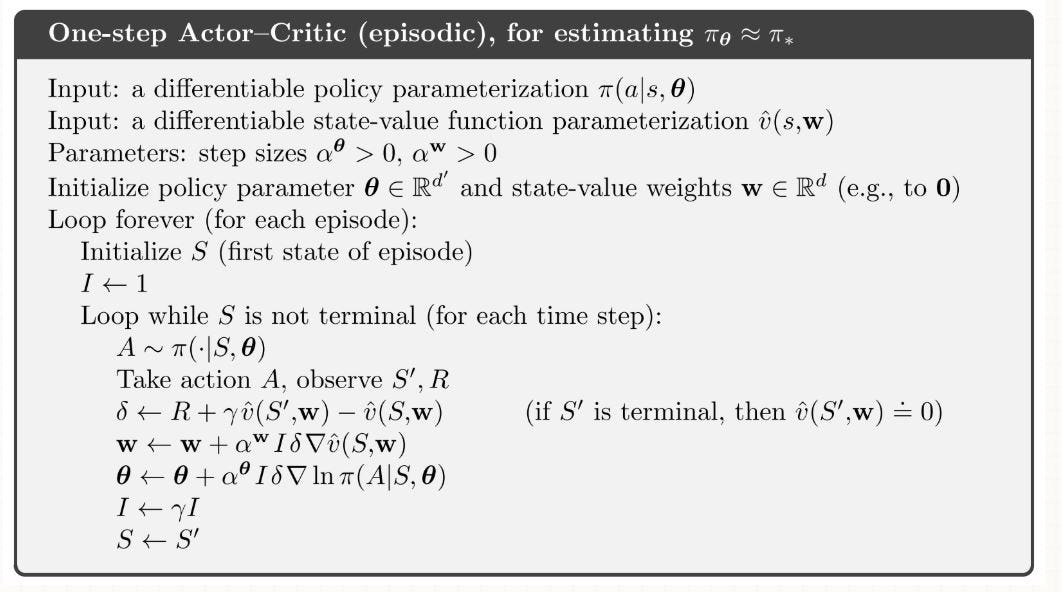
Почему мы используем методы, основанные на политике, если методы, основанные на ценностях, работают так хорошо?
- Ну, одна из основных причин, основанная на политике, лучше контролируется и может использоваться двумя разными способами, как показано ниже.
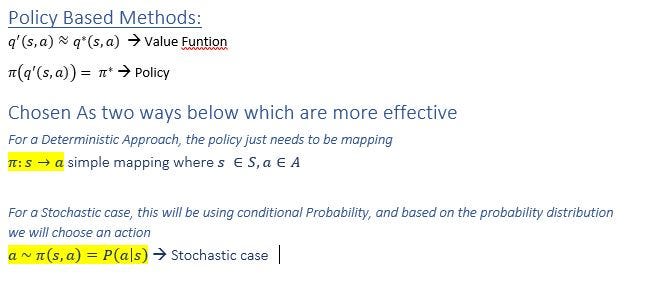
- Они могут изучить настоящую стохастическую политику, которая похожа на выбор из набора чисел, где вероятность получения каждого числа основана на некоторых переменных состояния, которые можно изменить.
- Стохастическая политика помогает, когда у нас есть псевдонимы состояний, два или более состояния, которые воспринимаются как идентичные, но на самом деле разные, с использованием стохастической политики легче выбрать правильное действие. Но при использовании функции значения в этом случае может быть сложно выбрать действие, так как они оба имеют одинаковое значение или сопоставлены с одним и тем же состоянием. Иногда из-за этого случая, если мы используем функцию значения вместо метода, основанного на политике, агент может просто колебаться и не сможет выйти из состояния, чтобы перейти к правильному действию. Для этого конкретного случая иногда агент может использовать эпсилон-жадный случай, когда агент может выйти из колебаний, но это неэффективно и с высоким значением эпсилон займет довольно много времени.
- Подход, основанный на ценности, имеет тенденцию изучать детерминированную или почти детерминированную политику, тогда как подход, основанный на политике, может изучать желаемую стохастическую политику.
- Методы, основанные на политике, хорошо подходят для «пространств непрерывного действия», так как мы можем легко найти глобальный максимум для функцию непрерывного значения для конкретного действия и выберите это действие.
- Для многомерных пространств действия было бы неплохо, если бы мы могли напрямую сопоставлять данное состояние с действием, даже если результирующая политика немного сложна, это было бы эффективно, и агент будет действовать быстрее, и это то, что Методы, основанные на политике, хороши.
Приближение функции политики
- Ниже я описываю процесс аппроксимации функции политики для дискретных и непрерывных пространств действий.
- Для дискретного мы можем использовать функцию Softmax для аппроксимации функции действия, где, как и для непрерывного пространства действия, мы используем гауссово/нормальное распределение, цель состоит в том, чтобы иметь возможность выбирать действие стохастически.
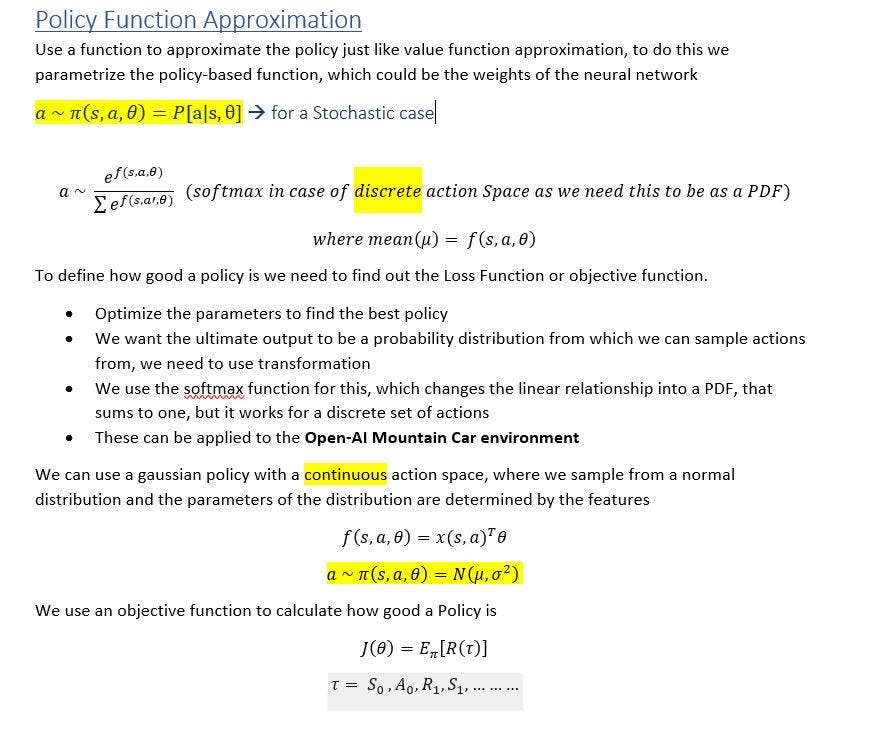
- Наконец, после выбора функции, мы вычисляем функцию цели или убытка, чтобы определить, насколько хороша политика.
- Ожидаемое значение можно рассчитать по нескольким траекториям для эпизодических и непрерывных сред, некоторые примеры:
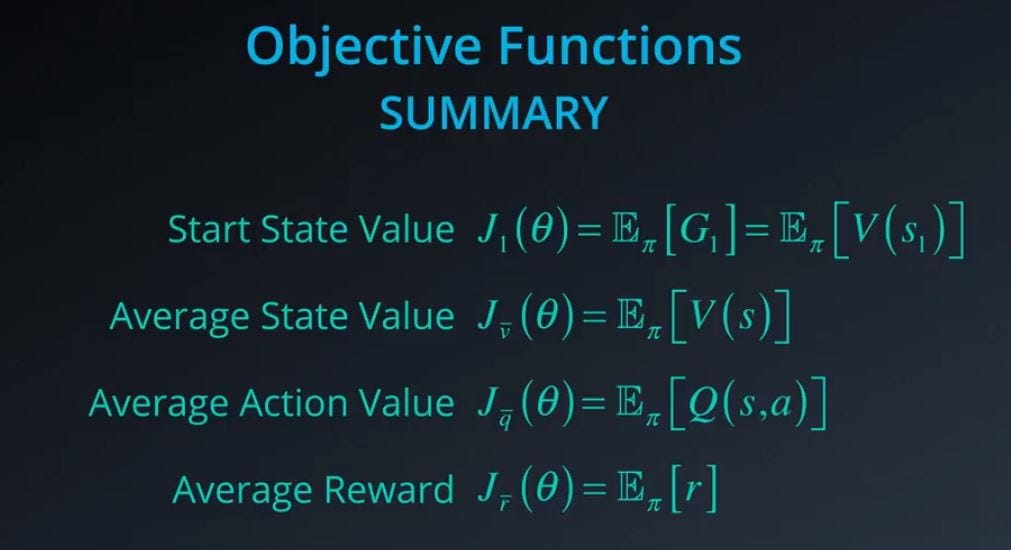
Поиск стохастической политики
- После выбора целевой функции выше нам нужно будет максимизировать ее.
- Используйте итеративный подход, чтобы найти лучшую политику, что-то похожее на градиентный спуск, помните, что объектная функция является очень сложной функцией и потребует много усилий, чтобы получить значение, которое максимизирует целевую функцию.
- Для градиентного спуска или восхождения на холм нам понадобится политика, которая дает значение целевой функции, чтобы быть вершиной холма, чтобы достичь этого, нам понадобится политика-кандидат и итерация от этого
- «Самое крутое восхождение на гору — выберите следующий лучший шаг из всех шагов и двигайтесь в этом направлении, это жадно, но лучше, чем наивное восхождение на холм»
- Simulated Annealing — еще один процесс поиска оптимальной политики, мы используем большой параметр Noise, а затем постепенно уменьшаем шум по мере приближения к оптимальному решению, аналогично попаданию в расплавленное железо, чтобы затвердеть. Это хороший алгоритм оптимизации
- Адаптивное масштабирование шума — Уменьшите радиус поиска для оптимальной политики, как только мы найдем политику, которая улучшит целевую функцию.
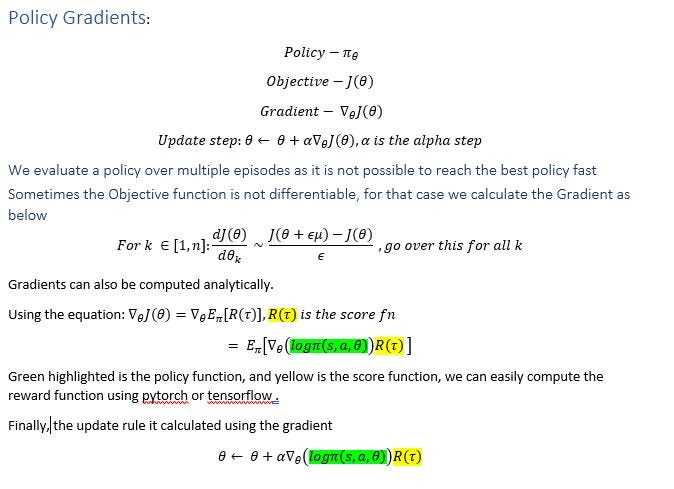
Расчет градиента политики
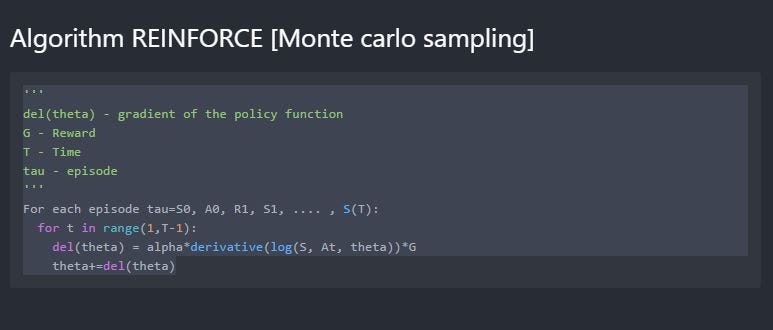
Алгоритм градиентов политики Монте-Карло
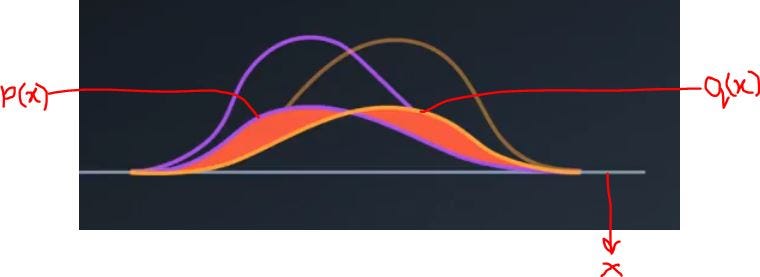
Поиск различий между двумя распределениями политик, в случае двух сравниваемых политик, помогает предотвратить слишком сильное изменение целевой функции с помощью новой политики.
Использование расхождения KL
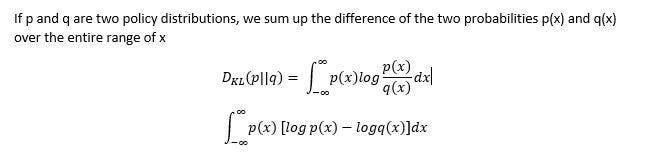
Выводы
- Политика — это распределение вероятностей по ряду действий, и трудно определить оптимальную политику в непрерывном пространстве действий.
- Внесено много улучшений в расчет градиента политики и усовершенствование алгоритма расчета целевой функции.
- Лучшим подходом будет взять документ и попытаться реализовать его.
Ссылки и дальнейшее изучение
- ПАРАМЕТР КОСМИЧЕСКОГО ШУМА ДЛЯ ИССЛЕДОВАНИЯ
- Курс глубокого обучения Udacity
- Градиенты ограниченной политики
- DDPG: https://arxiv.org/abs/1509.02971
- https://blog.openai.com/better-exploration-with-parameter-noise/
- Удивительные видео и работа здесь: https://github.com/telecombcn-dl
