В этом руководстве с нуля создается искусственная нейронная сеть на Python с использованием NumPy для создания приложения классификации изображений для набора данных Fruits360. Все (то есть изображения и исходные коды), использованные в этом руководстве, а не цветные изображения Fruits360, являются исключительными правами на мою книгу под названием Ахмед Фаузи Гад« Практические приложения компьютерного зрения, использующие глубокое обучение с CNN . Декабрь 2018, Апресс, 978–1–4842–4167–7 ». Книга доступна в Springer по этой ссылке: https://springer.com/us/book/9781484241660.

Исходный код, используемый в этом руководстве, доступен на моей странице GitHub здесь: https://github.com/ahmedfgad/NumPyANN
В книге используется пример классификации набора данных изображений Fruits360 с использованием искусственной нейронной сети (ИНС). В примере не предполагается, что читатель не извлек функции и не реализовал ИНС, поскольку в нем обсуждается, какой набор функций подходит для использования, а также как реализовать ИНС в NumPy с нуля. Набор данных Fruits360 содержит 60 классов фруктов, таких как яблоко, гуава, авокадо, банан, вишня, финики, киви, персик и другие. Чтобы упростить задачу, он работает только с 4 выбранными классами: яблоко Брэберн, лимон Мейер, манго и малина. В каждом классе есть около 491 изображения для обучения и еще 162 изображения для тестирования. Размер изображения 100х100 пикселей.
Извлечение функций
Книга начинается с выбора подходящего набора характеристик для достижения максимальной точности классификации. Судя по образцам изображений из 4 выбранных классов, показанных ниже, кажется, что их цвет отличается. Вот почему особенности цвета подходят для использования в этой задаче.
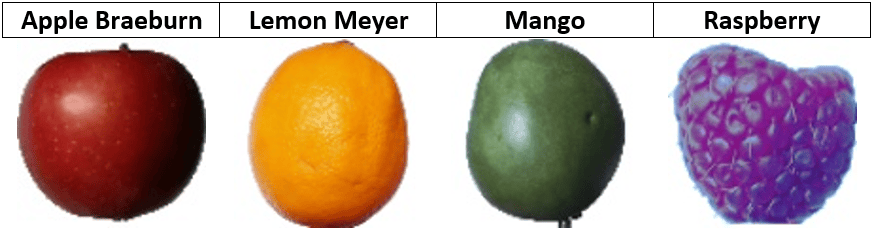
Цветовое пространство RGB не изолирует информацию о цвете от других типов информации, таких как освещение. Таким образом, если для представления изображений используется RGB, в расчетах будут задействованы 3 канала. По этой причине лучше использовать цветовое пространство, которое изолирует информацию о цвете в один канал, такой как HSV. Цветовой канал в данном случае - это канал оттенка (H). На следующем рисунке показан канал оттенка четырех представленных ранее образцов. Мы можем заметить, как значение оттенка для каждого изображения отличается от других изображений.

Размер канала оттенка по-прежнему составляет 100x100. Если весь канал применяется к ИНС, то входной слой будет иметь 10 000 нейронов. Сеть по-прежнему огромна. Чтобы уменьшить объем используемых данных, мы можем использовать гистограмму для представления канала оттенка. Гистограмма будет иметь 360 ячеек, отражающих количество возможных значений для значения оттенка. Вот гистограммы для 4 образцов изображений. Используя гистограмму с 360 ячейками для канала оттенка, кажется, что каждый фрукт голосует за определенные ячейки гистограммы. Между различными классами меньше совпадений по сравнению с использованием любого канала из цветового пространства RGB. Например, ячейки на гистограмме яблока находятся в диапазоне от 0 до 10 по сравнению с ячейками манго с диапазоном ячеек от 90 до 110. Разница между каждым из классов упрощает уменьшение неоднозначности в классификации и, таким образом, повышает точность прогноза.

Вот код, который вычисляет гистограмму канала оттенка из 4 изображений.
import numpy
 import skimage.io, skimage.color
 import matplotlib.pyplot

 raspberry = skimage.io.imread(fname="raspberry.jpg", as_grey=False)
 apple = skimage.io.imread(fname="apple.jpg", as_grey=False)
 mango = skimage.io.imread(fname="mango.jpg", as_grey=False)
 lemon = skimage.io.imread(fname="lemon.jpg", as_grey=False)

 apple_hsv = skimage.color.rgb2hsv(rgb=apple)
 mango_hsv = skimage.color.rgb2hsv(rgb=mango)
 raspberry_hsv = skimage.color.rgb2hsv(rgb=raspberry)
 lemon_hsv = skimage.color.rgb2hsv(rgb=lemon)

 fruits = ["apple", "raspberry", "mango", "lemon"]
 hsv_fruits_data = [apple_hsv, raspberry_hsv, mango_hsv, lemon_hsv]
 idx = 0
 for hsv_fruit_data in hsv_fruits_data:
     fruit = fruits[idx]
     hist = numpy.histogram(a=hsv_fruit_data[:, :, 0], bins=360)
     matplotlib.pyplot.bar(left=numpy.arange(360), height=hist[0])
     matplotlib.pyplot.savefig(fruit+"-hue-histogram.jpg", bbox_inches="tight")
     matplotlib.pyplot.close("all")
     idx = idx + 1
Перебирая все изображения в 4 используемых классах изображений, мы можем извлечь функции из всех изображений. Следующий код делает это. В соответствии с количеством изображений в 4 классах (1962) и длиной вектора признаков, извлеченной из каждого изображения (360), создается массив нулей NumPy, который сохраняется в переменной dataset_features. Чтобы сохранить метку класса для каждого изображения, создается другой массив NumPy с именем output. Метка класса для яблока - 0, лимона - 1, манго - 2 и малины - 3. Код предполагает, что он работает в корневом каталоге, в котором есть 4 папки, названные в соответствии с названиями фруктов, перечисленными в списке с именем фрукты. Он просматривает все изображения во всех папках, извлекает гистограмму оттенков из каждой из них, назначает каждому изображению метку класса и, наконец, сохраняет извлеченные функции и метки классов с помощью библиотеки pickle. Вы также можете использовать NumPy для сохранения результирующих массивов NumPy, а не pickle.
import numpy
import skimage.io, skimage.color, skimage.feature
import os
import pickle

fruits = ["apple", "raspberry", "mango", "lemon"] #492+490+490+490=1,962
dataset_features = numpy.zeros(shape=(1962, 360))
outputs = numpy.zeros(shape=(1962))
idx = 0
class_label = 0

for fruit_dir in fruits:
    curr_dir = os.path.join(os.path.sep, fruit_dir)
    all_imgs = os.listdir(os.getcwd()+curr_dir)
    for img_file in all_imgs:
        fruit_data = skimage.io.imread(fname=os.getcwd()+curr_dir+img_file, as_grey=False)
        fruit_data_hsv = skimage.color.rgb2hsv(rgb=fruit_data)
        hist = numpy.histogram(a=fruit_data_hsv[:, :, 0], bins=360)
        dataset_features[idx, :] = hist[0]
        outputs[idx] = class_label
        idx = idx + 1
    class_label = class_label + 1

with open("dataset_features.pkl", "wb") as f:
    pickle.dump("dataset_features.pkl", f)

with open("outputs.pkl", "wb") as f:
    pickle.dump(outputs, f)
В настоящее время каждое изображение представлено с помощью вектора признаков из 360 элементов. Такие элементы фильтруются, чтобы оставить только самые релевантные элементы для различения 4 классов. Уменьшенная длина вектора признаков составляет 102, а не 360. Использование меньшего количества элементов помогает ускорить обучение, чем раньше. Форма переменной dataset_features будет 1962x102. Вы можете прочитать в книге больше об уменьшении длины вектора признаков.
К этому моменту данные обучения (функции и метки классов) готовы. Далее реализуем ИНС с помощью NumPy.
Реализация ANN
На следующем рисунке показана структура целевой ИНС. Существует входной слой со 102 входами, 2 скрытых слоя с 150 и 60 нейронами и выходной слой с 4 выходами (по одному для каждого класса фруктов).

Входной вектор на любом слое умножается (матричное умножение) на матрицу весов, соединяющую его со следующим слоем, чтобы получить выходной вектор. Такой выходной вектор снова умножается на матрицу весов, соединяющую его слой со следующим слоем. Процесс продолжается до достижения выходного слоя. Сводка умножений матриц представлена на следующем рисунке.

Входной вектор размером 1x10² должен быть умножен на матрицу весов первого скрытого слоя размером 102x150. Помните, что это умножение матриц. Таким образом, выходной массив имеет форму 1x150. Такой вывод затем используется как ввод для второго скрытого слоя, где он умножается на матрицу весов размером 150x60. Размер результата - 1x60. Наконец, такой результат умножается на веса между вторым скрытым слоем и выходным слоем размером 60x4. Результат наконец имеет размер 1х4. Каждый элемент в таком результирующем векторе относится к выходному классу. Входной образец помечается в соответствии с классом с наивысшим баллом.
Код Python для реализации таких умножений приведен ниже.
import numpy
import pickle

def sigmoid(inpt):
    return 1.0 / (1 + numpy.exp(-1 * inpt))

f = open("dataset_features.pkl", "rb")
data_inputs2 = pickle.load(f)
f.close()

features_STDs = numpy.std(a=data_inputs2, axis=0)
data_inputs = data_inputs2[:, features_STDs > 50]

f = open("outputs.pkl", "rb")
data_outputs = pickle.load(f)
f.close()

HL1_neurons = 150
input_HL1_weights = numpy.random.uniform(low=-0.1, high=0.1, size=(data_inputs.shape[1], HL1_neurons))
HL2_neurons = 60
HL1_HL2_weights = numpy.random.uniform(low=-0.1, high=0.1, size=(HL1_neurons, HL2_neurons))
output_neurons = 4
HL2_output_weights = numpy.random.uniform(low=-0.1, high=0.1, size=(HL2_neurons, output_neurons))
H1_outputs = numpy.matmul(a=data_inputs[0, :], b=input_HL1_weights)
H1_outputs = sigmoid(H1_outputs)
H2_outputs = numpy.matmul(a=H1_outputs, b=HL1_HL2_weights)
H2_outputs = sigmoid(H2_outputs)
out_otuputs = numpy.matmul(a=H2_outputs, b=HL2_output_weights)

predicted_label = numpy.where(out_otuputs == numpy.max(out_otuputs))[0][0]
print("Predicted class : ", predicted_label)
После чтения ранее сохраненных объектов и их выходных меток и фильтрации объектов определяются матрицы весов слоев. Им случайным образом присваиваются значения от -0,1 до 0,1. Например, переменная «input_HL1_weights» содержит матрицу весов между входным слоем и первым скрытым слоем. Размер такой матрицы определяется количеством элементов признака и количеством нейронов в скрытом слое.
После создания матриц весов следует применить умножение матриц. Например, переменная «H1_outputs» содержит результат умножения вектора признаков данной выборки на матрицу весов между входным слоем и первым скрытым слоем.
Обычно функция активации применяется к выходам каждого скрытого слоя, чтобы создать нелинейную связь между входами и выходами. Например, выходные данные умножения матриц применяются к функции активации сигмоида.
После генерации выходных данных выходного слоя происходит прогнозирование. Метка прогнозируемого класса сохраняется в переменной «predicted_label». Такие шаги повторяются для каждой входной выборки. Полный код, который работает во всех примерах, приведен ниже.
import numpy
import pickle

def sigmoid(inpt):
    return 1.0 / (1 + numpy.exp(-1 * inpt))

def relu(inpt):
    result = inpt
    result[inpt < 0] = 0
    return result

def update_weights(weights, learning_rate):
    new_weights = weights - learning_rate * weights
    return new_weights

def train_network(num_iterations, weights, data_inputs, data_outputs, learning_rate, activation="relu"):

    for iteration in range(num_iterations):
        print("Itreation ", iteration)
        for sample_idx in range(data_inputs.shape[0]):
            r1 = data_inputs[sample_idx, :]
            for idx in range(len(weights) - 1):
                curr_weights = weights[idx]
                r1 = numpy.matmul(a=r1, b=curr_weights)
                if activation == "relu":
                    r1 = relu(r1)
                elif activation == "sigmoid":
                    r1 = sigmoid(r1)
            curr_weights = weights[-1]
            r1 = numpy.matmul(a=r1, b=curr_weights)
            predicted_label = numpy.where(r1 == numpy.max(r1))[0][0]
            desired_label = data_outputs[sample_idx]
            if predicted_label != desired_label:
                weights = update_weights(weights, learning_rate=0.001)
    return weights

def predict_outputs(weights, data_inputs, activation="relu"):
    predictions = numpy.zeros(shape=(data_inputs.shape[0]))
    for sample_idx in range(data_inputs.shape[0]):
        r1 = data_inputs[sample_idx, :]
        for curr_weights in weights:
            r1 = numpy.matmul(a=r1, b=curr_weights)
            if activation == "relu":
                r1 = relu(r1)
            elif activation == "sigmoid":
                r1 = sigmoid(r1)
        predicted_label = numpy.where(r1 == numpy.max(r1))[0][0]
        predictions[sample_idx] = predicted_label
    return predictions

f = open("dataset_features.pkl", "rb")
data_inputs2 = pickle.load(f)
f.close()
features_STDs = numpy.std(a=data_inputs2, axis=0)
data_inputs = data_inputs2[:, features_STDs > 50]

f = open("outputs.pkl", "rb")
data_outputs = pickle.load(f)
f.close()
HL1_neurons = 150
input_HL1_weights = numpy.random.uniform(low=-0.1, high=0.1,size=(data_inputs.shape[1], HL1_neurons))
HL2_neurons = 60
HL1_HL2_weights = numpy.random.uniform(low=-0.1, high=0.1,size=(HL1_neurons,HL2_neurons))
output_neurons = 4
HL2_output_weights = numpy.random.uniform(low=-0.1, high=0.1,size=(HL2_neurons,output_neurons))

weights = numpy.array([input_HL1_weights,
                       HL1_HL2_weights,
                       HL2_output_weights])

weights = train_network(num_iterations=10,
                        weights=weights,
                        data_inputs=data_inputs,
                        data_outputs=data_outputs,
                        learning_rate=0.01,
                        activation="relu")

predictions = predict_outputs(weights, data_inputs)
num_flase = numpy.where(predictions != data_outputs)[0]
print("num_flase ", num_flase.size)
Переменные «веса» содержат все веса во всей сети. В зависимости от размера каждой матрицы весов структура сети определяется динамически. Например, если размер переменной «input_HL1_weights» составляет 102x80, то мы можем сделать вывод, что первый скрытый слой имеет 80 нейронов.
train_network - это основная функция, поскольку она обучает сеть путем циклического перебора всех выборок. Для каждого образца применяются шаги, описанные в листинге 3–6. Он принимает количество итераций обучения, функцию, метки вывода, веса, скорость обучения и функцию активации. Есть два варианта функций активации: ReLU или сигмоид. ReLU - это пороговая функция, которая возвращает один и тот же ввод, если он больше нуля. В противном случае возвращается ноль.
Если сеть сделала неверный прогноз для данной выборки, веса обновляются с помощью функции «update_weights». Для обновления весов не используется алгоритм оптимизации. Веса просто обновляются в соответствии со скоростью обучения. Точность не превышает 45%. Для достижения большей точности используется алгоритм оптимизации для обновления весов. Например, вы можете найти технику градиентного спуска в реализации ANN библиотеки scikit-learn.
В моей книге вы можете найти руководство по оптимизации весов ИНС с использованием метода оптимизации генетического алгоритма (ГА), который увеличивает точность классификации. Вы можете узнать больше об GA из следующих ресурсов, которые я подготовил:
Введение в оптимизацию с помощью генетического алгоритма
Https://www.linkedin.com/pulse/introduction-optimization-genetic-algorithm-ahmed-gad/
Https://www.kdnuggets.com/2018/03/introduction-optimization-with-genetic-algorithm.html
Https://towardsdatascience.com/introduction-to-optimization-with-genetic-algorithm-2f5001d9964b
Https://www.springer.com/us/book/9781484241660
Оптимизация генетического алгоритма (GA) - пошаговый пример
Https://www.slideshare.net/AhmedGadFCIT/genetic-algorithm-ga-optimization-stepbystep-example
Реализация генетического алгоритма в Python
Https://www.linkedin.com/pulse/genetic-algorithm-implementation-python-ahmed-gad/
Https://www.kdnuggets.com/2018/07/genetic-algorithm-implementation-python.html
Https://towardsdatascience.com/genetic-algorithm-implementation-in-python-5ab67bb124a6
Для связи с автором
Электронная почта: [email protected]
LinkedIn: https://linkedin.com/in/ahmedfgad/
KDnuggets: https://kdnuggets.com/author/ahmed-gad
YouTube: https://youtube.com/AhmedGadFCIT
TowardsDataScience: https://towardsdatascience.com/@ahmedfgad
