Это расследование стоило мне первых седых волос.
Короче
Мы все привыкли работать с системами управления реляционными базами данных, и это большой опыт. Все эти базы данных, такие как Oracle, PostgreSQL, обеспечивают такую универсальность в использовании, что разработчики могут найти любую запись по любым критериям практически без усилий. Одним из наиболее важных аспектов РСУБД являются высокие показатели производительности, и для этого требуется лишь базовая настройка.
Ситуация меняется, когда мы пытаемся организовать высокую масштабируемость и доступность ваших сервисов, внедряя распределенную архитектуру или микросервисы. Очевидно, что вы выбираете Apache Hadoop и HBase в качестве файловой системы и хранилища данных, что само по себе является отличным решением и технологическим стандартом. Однако HBase не предоставляет такого продвинутого API для работы с объектами базы данных, как РСУБД. Производительность сканирования и обхода по случайному значению поля все еще намного ниже из-за распределенной файловой системы и структуры, ориентированной на столбцы. В погоне за постоянным совершенствованием мы вводим еще один инструмент в наш технологический зоопарк - Apache Phoenix в качестве оболочки SQL, а точнее OLTP для HBase.
Именно здесь возникают настоящие проблемы.
Настраивать
Для обзора базовой производительности и объяснения плана мы будем использовать 3 таблицы:
USER_DATA_150K(150 000 записей)USER_DATA_15M(15 000 000 записей)USER_DATA_30M(30 000 000 записей)
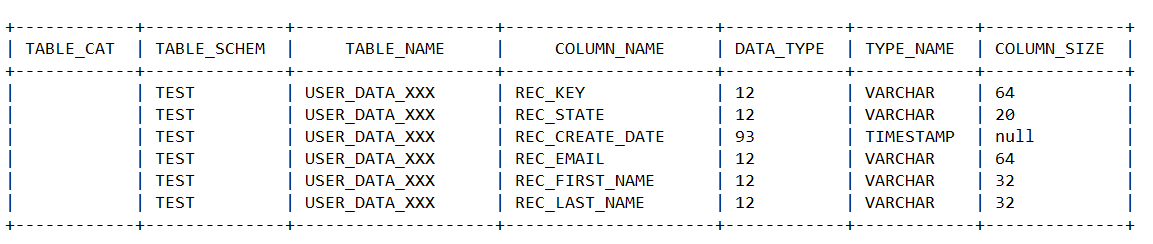
Эти таблицы имеют полностью идентичную структуру:
Обзор производительности
Выбрать по первичному ключу (REC_KEY)
SELECT REC_KEY, REC_STATE, REC_CREATE_DATE, REC_EMAIL, REC_ FIRST_NAME, REC_LAST_NAME FROM TEST.USER_DATA_XXX WHERE REC_KEY = 'xxx'

Мы уже можем заметить, что показатели эффективности для этих трех случаев в пределах допустимого. Самым впечатляющим фактом для меня являются хорошие показатели производительности операций чтения из коробки, которые показывает Apache Phoenix, хотя это больше касается HBase.
Фильтрация и сортировка по полям таблицы (REC_LAST_NAME и REC_CREATE_DATE)
Пришло время проверить нашу производительность, создав операторы выбора для полей наших таблиц. Это будет сложной задачей для HBase и Apache Phoenix из-за их внутренней структуры данных.
SELECT REC_KEY, REC_STATE, REC_CREATE_DATE, REC_EMAIL, REC_ FIRST_NAME, REC_LAST_NAME FROM TEST.USER_DATA_XXX WHERE REC_LAST_NAME = 'xxx' ORDER BY REC_MODIFY_DATE

Показанные здесь показатели пугают как для одного из самых популярных решений на рынке. Давайте разберемся, что именно произошло и что пошло не так во время наших тестов:
- Мы добавили к утверждению 2 критерия.
- Эти критерии не являются частью первичного ключа, а являются обычными значениями полей таблицы.
- Apache Phoenix не знает, где могут храниться определенные записи, соответствующие этому критерию, поэтому он начинает сканирование всей таблицы вместо сканирования области.
Глобальные индексы Phoenix’s
Пришло время ввести в наши таблицы Вторичные индексы, которые могут помочь повысить показатели эффективности фильтрации и сортировки запросов. Есть 3 способа сделать глобальные индексы Phoenix эффективными:
- Включить все поля в индекс. Плюсы: гарантия того, что поиск будет выполняться по таблице индекса. Минусы: Существенное снижение производительности для
UPSERTиDELETEопераций, размер таблицы индекса увеличивается и по умолчанию это неправильное архитектурное решение, если вы не выполните поиск по всем полям таблицы. - Подсказка индекса. Плюсы: легкий подход, не замечено проблем с рассинхронизацией таблицы (критическая ошибка в версии 5.0.0 и ниже: PHOENIX-4455) . Минусы: не гарантирует обход таблицы индекса.
- Покрытый индекс. Плюсы: гарантия того, что поиск будет выполняться по индексной таблице. Минусы: размер таблицы индекса увеличивается.
Теперь мы можем применить эти 3 стратегии глобального индекса отдельно к нашей таблице to USER_DATA_15M и сравнить результаты.
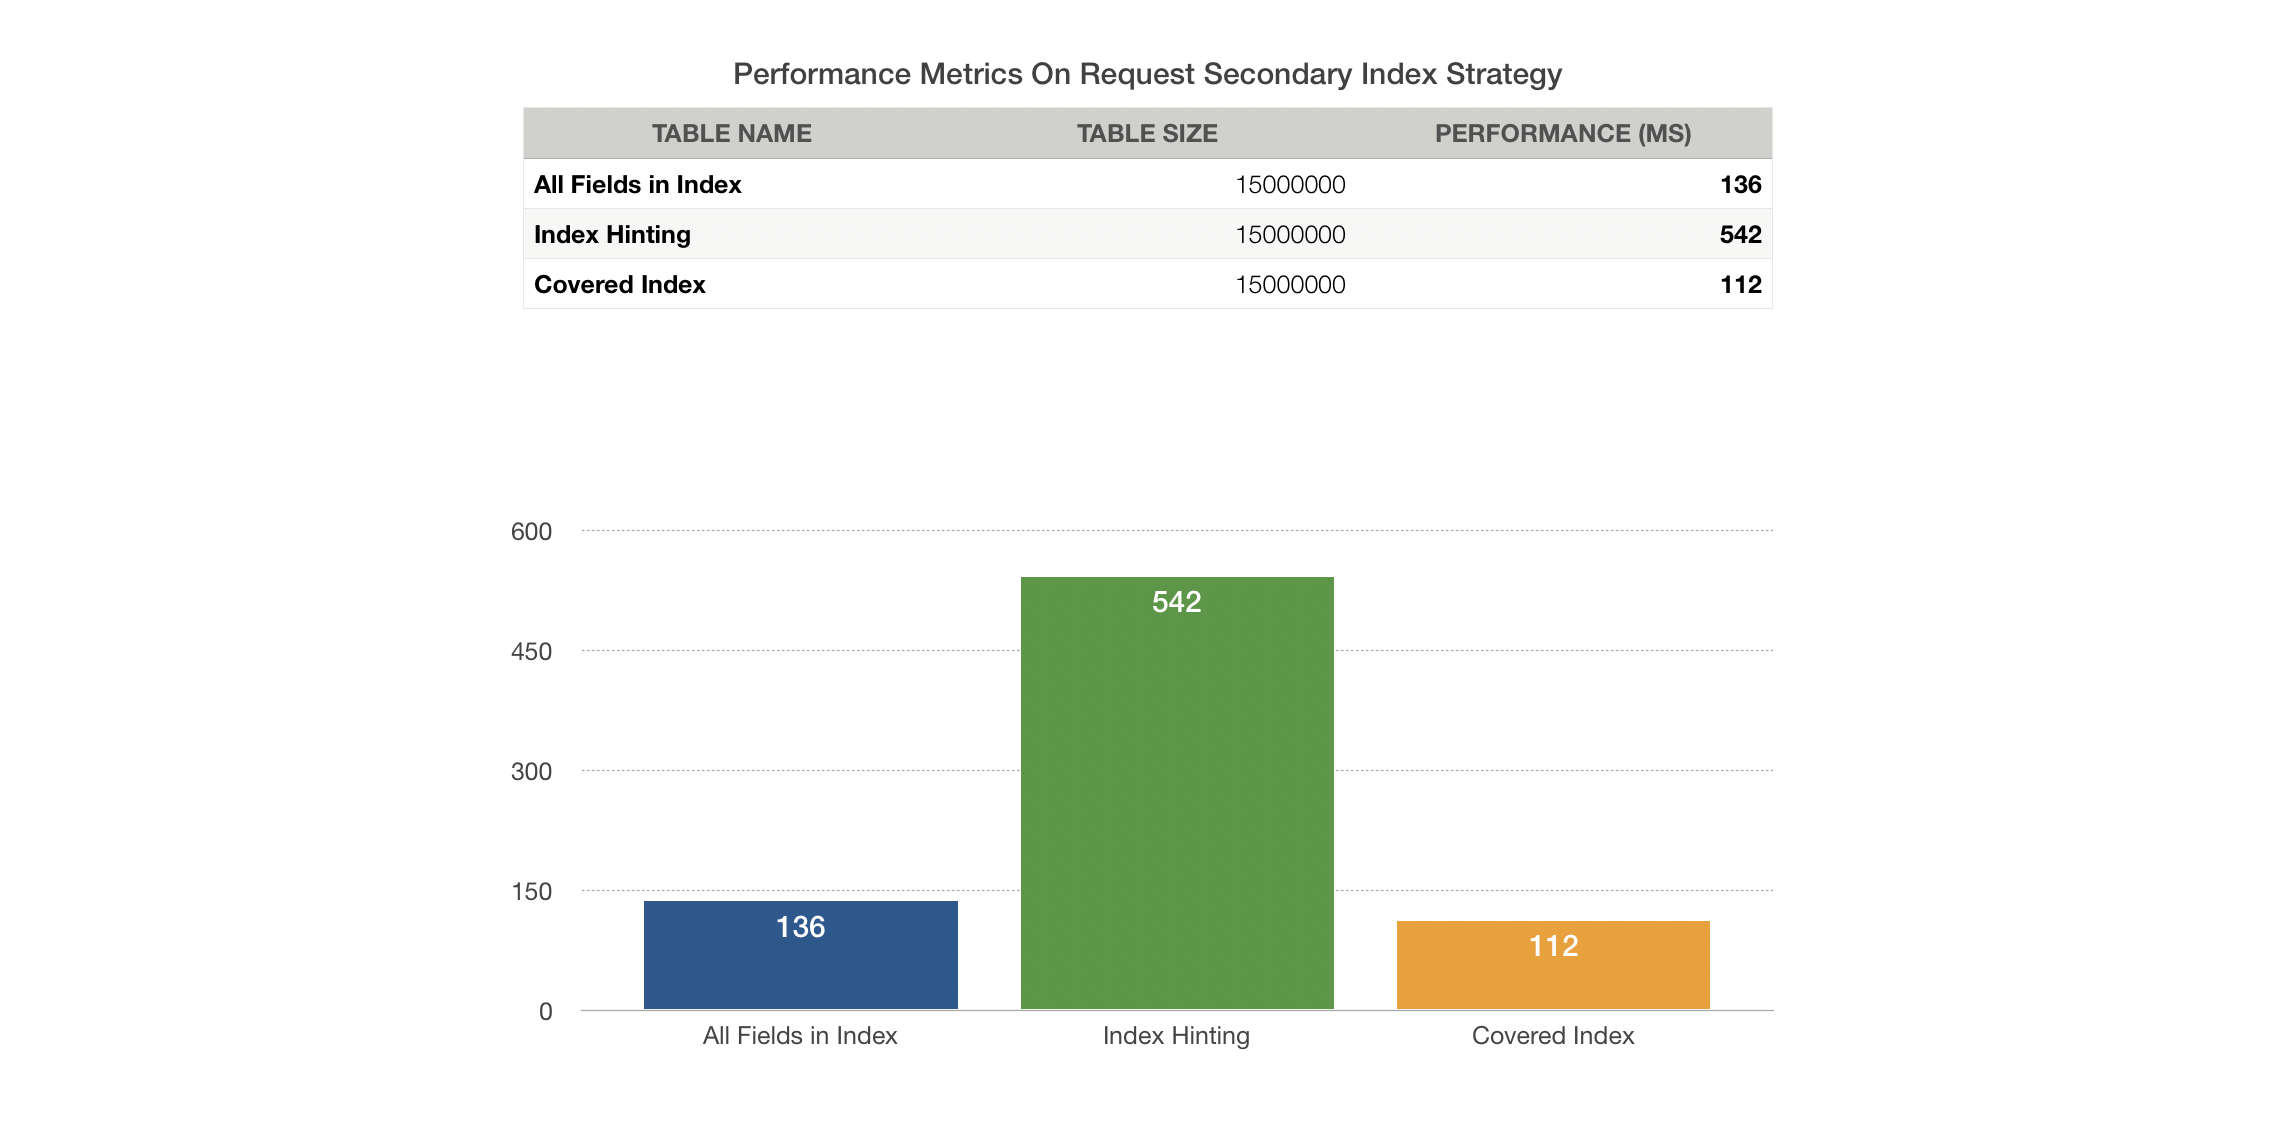
Все эти манипуляции положительно повлияли на таблицу 15M и сократили время поиска в 20 (!!!) раз.
Глобальные индексы. Обзор проблем
На данный момент Apache Phoenix версии 5.0.0 имеет несколько чрезвычайно уязвимых проблем (PHOENIX-4455 и PHOENIX-3845). Из-за этих и других подобных ошибок мы не можем использовать глобальные индексы в полном объеме. Эти проблемы намного опаснее, чем может показаться, я наблюдал за ними сам и доверяю мне, такая рутина, как отладка базы данных и наблюдение, что по какой-то причине / в какой-то момент индекс и таблица не синхронизированы, ужасны. Я могу только представить, что в чьей-то производственной среде могут быть эти ошибки.
Плохие вещи.
С другой стороны, я здесь, чтобы помочь вам. Итак, есть несколько многообещающих способов решения этой проблемы.
Транзакции. Пожалуй, это самое спорное решение.
- Это не способ делать большие данные, используя транзакции, вы начинаете терять производительность записи и нарушаете принцип больших данных WORM - Пишите одни, читайте много.
- Вы должны включить Apache Tephra в качестве транзакционного сервиса в и без того интересную экосистему, что само по себе неплохая идея, но есть одно но: это проект инкубатора Apache, и с 2017 года никаких серьезных работ не проводилось, так что забудьте о любой вид поддержки.
Локальные индексы. Phoenix изменил структуру локальных индексов в версии 4.8 и выше, они не будут иметь несоответствий в таблице и индексе, однако локальные индексы не идеальны. Подумайте дважды, прежде чем использовать их повсюду из-за низкой интенсивности чтения.
Важные заметки
Вот несколько важных замечаний, которыми я хотел бы поделиться с вами, которые сделают ваш опыт работы с Apache Phoenix более продуктивным:
- Глобальный индекс не будет использоваться Phoenix, если все столбцы, указанные в запросе, не содержатся в индексе. Локальный индекс может быть альтернативой глобальному индексу.
- После включения всех полей во вторичный индекс и введения покрытых индексов размер таблицы индекса увеличился в 2 раза по сравнению со стратегией Index Hinting. Во многом это зависит от количества и типа полей ваших таблиц. Чтобы проверить размер таблицы индекса, выполните следующую команду в Namenode Hadoop:
$ hadoop fs -du -h hdfs://{PATH_TO_HBASE}/data/data/{SCHEMA}/{INDEX}
- Порядковый номер полей индекса следует выбирать таким образом, чтобы он соответствовал общим шаблонам запросов - выберите наиболее часто запрашиваемый столбец или столбец, который всегда будет стоять перед каждым критерием фильтра в качестве первого и т. Д.
Заключение
Apache Phoenix - отличный инструмент, он обеспечивает такую универсальность Apache HBase. Тем не менее, необходимо приложить усилия, чтобы правильно настроить его для вашего проекта / бизнеса, особенно при наличии проблем с открытыми блокировщиками даже с последней версией Phoenix 5.0.0.
Не принимайте близко к сердцу!
