Библиотека Python FuzzyWuzzy используется для измерения сходства между двумя строками. Вот как вы тоже можете начать его использовать.
Иногда нам нужно посмотреть, совпадают ли две строки. При сравнении хэша введенного пароля с хешем, хранящимся в вашей базе данных входа в систему, «сходство» не поможет.
В других случаях, однако, все может стать немного… нечетким.
Если моего клиента зовут Альберт Томпсон, но он платит кредитной картой на имя Альберт Г. Томпсон, должен ли я звонить в полицию, чтобы сообщить о мошенничестве? Следует ли рассматривать «Властелин колец 2: Две башни» и «Властелин колец 2: 2 башни» как две совершенно разные книги на веб-сайте? Действительно ли Австрия и Австралия - две разные страны?
Хорошо, возможно, я увлекся этим последним, но вы поняли.
Строковые меры расстояния
Нам нужна некоторая функция, которая измеряет, насколько похожи две строки, но устойчива к небольшим изменениям. Эта проблема столь же распространена, как кажется: ученые уже давно придумывают решения.
Дистанция Жаккара: первый подход
Один из самых интуитивно понятных - это расстояние Жаккара. Его можно обобщить до меры расстояния для любых двух наборов. Он измеряется по следующей формуле:

То есть количество элементов в любом наборе, но не общих для обоих, деленное на общее количество отдельных элементов.
Например, для строк «Альберт» и «Альберто» будет указано сходство 85,7%, поскольку они имеют 6 общих букв из 7.
Однако это не мера, специально предназначенная для струнных.
Во многих случаях он будет терпеть неудачу, поскольку на самом деле не учитывает порядок. Например, две анаграммы, такие как «железнодорожная безопасность» и «сказки», всегда будут иметь 100% совпадение, даже если эти строки сильно различаются.
Левенштейн Расстояние
Эта мера, изобретенная российским ученым Владимиром Левенштейном в 60-х годах, немного более интуитивна: она подсчитывает, сколько замен необходимо для данной строки u, чтобы преобразовать ее в v .
Для этого метода подстановка определяется как:
- Стирание персонажа.
- Добавление одного.
- Замена персонажа другим.
Минимальное количество этих операций, которые необходимо выполнить для u, чтобы превратить его в v, соответствует расстоянию Левенштейна между этими двумя строками.
Его можно получить рекурсивно с помощью этой формулы:
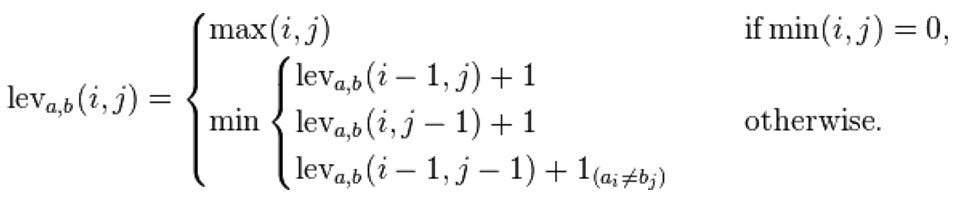
Где i и j - это индексы последнего символа подстроки, которую мы будем сравнивать. Второй член в последнем выражении равен 1, если эти символы разные, и 0, если они одинаковые.
Это мера, которую использует библиотека Python FuzzyWuzzy.
Использование FuzzyWuzzy в Python
Чтобы получить коэффициент подобия между двумя строками, все, что нам нужно сделать, это следующее:
from fuzzywuzzy import fuzz
similarity = fuzz.ratio("hello","world")
Вы, наверное, заметили, что я сказал соотношение. Метод ratio всегда будет возвращать число от 0 до 100 (да, я бы предпочел, чтобы оно было от 0 до 1 или называлось процентное соотношение, но каждому свое).
Можно показать, что расстояние Левенштейна не превышает длины самой длинной строки: замените все символы в более короткой строке первой частью более длинной, а затем добавьте оставшиеся.
Вот как мы можем нормализовать расстояние, чтобы получить соотношение, чтобы число не сильно колебалось при вводе данных с разными размерами.
Это решает некоторые из ранее упомянутых проблем:
fuzz.ratio("Albert Thompson", "Albert G. Thompson") #91%
fuzz.ratio("The Lord of the Rings II: The Two Towers",
           "The Lord of the Rings 2: the 2 Towers") #88%
Даже если он может принести несколько новых:
#88% for two different countries
fuzz.ratio("Austria","Australia")
#57% but it's the same country
fuzz.ratio("Czechia","Czech Republic")
Другие методы FuzzyWuzzy
Библиотека Python FuzzyWuzzy предоставляет нам не только ванильное расстояние Левенштейна, но и несколько других методов, которые мы можем использовать.
partial_ratio
Метод partial_ratio вычисляет коэффициент нечеткости-Wuzzy для всех подстрок более длинной строки с длиной более короткой, а затем возвращает наивысшее совпадение.
Например,
fuzz.partial_ratio("abc","a") ==
      min([fuzz.ratio( char, "a") for char in "abc"])
Это дает несколько интересных эффектов:
fuzz.partial_ratio("Thomas and His Friends", "Thomas") #100%
fuzz.partial_ratio("Batman vs Superman", "Batman") #100%
Фактически, метод partial_ratio может быть нечеткой заменой строковому методу contains, так же как обычное соотношение может заменить метод equals.
Однако он не будет работать для похожих строк, но слова которых расположены в другом порядке. Даже небольшое изменение порядка его сломает.
#72% with basically the same idea
fuzz.partial_ratio("Peanut Butter and Jelly",
                   "Jelly and Peanut Butter")

#86% with a random (carefully selected) string
fuzz.partial_ratio("Peanut Butter and Jelly", "Otter and Hell")
token_sort_ratio
Коэффициент сортировки токенов делит обе строки на слова, затем снова объединяет их в буквенно-цифровом порядке, прежде чем вызывать для них обычное соотношение.
Это означает:
fuzz.partial_ratio("Batman vs Superman", "Superman vs Batman") #100%
fuzz.partial_ratio("a b c", "c b a") #100%
token_set_ratio
Коэффициент набора токенов разделяет каждую строку на слова, превращает оба списка в наборы (отбрасывая повторяющиеся слова), а затем сортирует их перед выполнением соотношения.
Таким образом, мы не только исключаем общие слова, но и учитываем их повторы.
fuzz.token_set_ratio("fun","fun fun fun") #100%
fuzz.token_set_ratio("Lord the Rings of", "Lord of the Rings") #100%
Выводы
Библиотека Python FuzzyWuzzy может оказаться очень полезным инструментом. Как для сопоставления имен клиентов, так и для встраивания слов бедняков, он может избавить вас от множества проблем или помочь с проектированием функций вашей модели машинного обучения.
Однако, поскольку он требует предварительной обработки (например, перевод обеих строк в нижний регистр) и не принимает во внимание синонимы, он может быть не лучшим решением для случаев, когда могут потребоваться фактические NLP или методы кластеризации.
Я надеюсь, что вы нашли эту статью полезной, и дайте мне знать, если вы найдете другое применение FuzzyWuzzy в своей работе!
Подпишитесь на меня в Twitter или Medium, чтобы быть в курсе других руководств, советов и приемов Python.
Если вы нашли эту статью полезной, подумайте о поддержке моего сайта, помогая мне оплатить его хостинг. Ваше пожертвование очень поможет.
Первоначально опубликовано на сайте www.datastuff.tech 15 апреля 2019 г.
