Цены на жилье являются важным отражением экономики, а диапазоны цен на жилье представляют большой интерес как для покупателей, так и для продавцов. В этом проекте цены на жилье будут прогнозироваться с учетом объясняющих переменных, которые охватывают многие аспекты жилых домов. Цель этого проекта - создать регрессионную модель, которая сможет точно оценить стоимость дома с учетом характеристик.
Получение данных:
Это Конкурс по прогнозированию цен на недвижимость Kaggle. Цель проекта - применить методы визуализации данных для понимания сути данных. Машинное обучение часто требуется для понимания данных и их анализа. Этот проект направлен на применение различных инструментов Python для визуального понимания данных и их очистки, чтобы подготовить их к применению к ним моделей машинного обучения и глубокого обучения.
Чтобы скачать набор данных, перейдите по этой ссылке: Ссылка
Постановка задачи :

Цены на жилье являются важным отражением экономики, а диапазоны цен на жилье представляют большой интерес как для покупателей, так и для продавцов. Попросите покупателя описать дом своей мечты, и он, вероятно, не начнет с высоты потолка подвала или близости к железной дороге с востока на запад. Но набор данных этого конкурса на игровых площадках доказывает, что на переговоры о цене влияет гораздо больше, чем количество спален или белый забор.
В этом конкурсе, где 79 объясняющие переменные описывают (почти) все аспекты жилых домов в Эймсе, штат Айова, вам предстоит спрогнозировать окончательную цену каждого дома.
Цели и ограничения реального мира / бизнеса:
Цели:
1. Спрогнозируйте продажную цену для каждого дома.
2. Свести к минимуму разницу между прогнозируемым и фактическим рейтингом (RMSE / MSE)
Ограничения:
- Некоторая форма интерпретируемости.
Обзор данных:
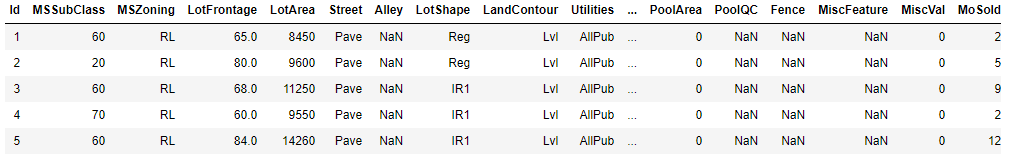
О данных:
1. Количество точек данных в данных поезда: 1460
2. Количество функций в данных поезда: 81.
3. Количество точек в тестовых данных: 1459.
4. Количество функций в тестовых данных: 80
Сопоставление проблемы реального мира с проблемой машинного обучения:
Эта проблема включает в себя прогнозирование цен на дома, которые представляют собой непрерывную и реальную стоимость продукции. Таким образом, это проблема регрессии.
Показатель производительности:
· Использование среднеквадратичной ошибки (RMSE) в качестве показателя производительности. Чтобы узнать больше об этом, нажмите « Среднеквадратичная ошибка .
Цель и ограничения машинного обучения:
1. Сверните RMSE.
2. Постарайтесь обеспечить некоторую интерпретируемость.
Исследовательский анализ данных:
Исследовательский анализ данных относится к критически важному процессу выполнения начальных исследований данных с целью выявления закономерностей, выявления аномалий, проверки гипотез и проверки предположений с помощью сводной статистики и графических представлений. некоторый двувариантный анализ данных, чтобы получить лучший обзор данных и найти выбросы в нашем наборе данных. Выбросы могут возникать из-за каких-либо ошибок при сборе данных, и их необходимо удалить, чтобы это не повлияло на производительность нашей модели.
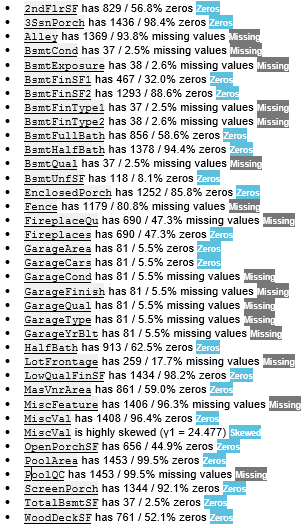
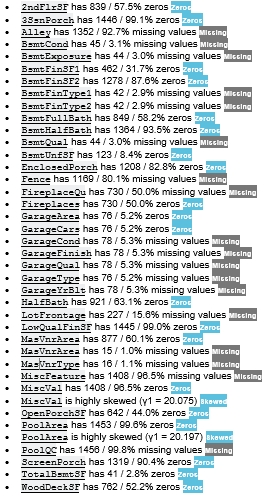
Процент нулей и NaN или нулевых значений в обучающих и тестовых данных:
В целом
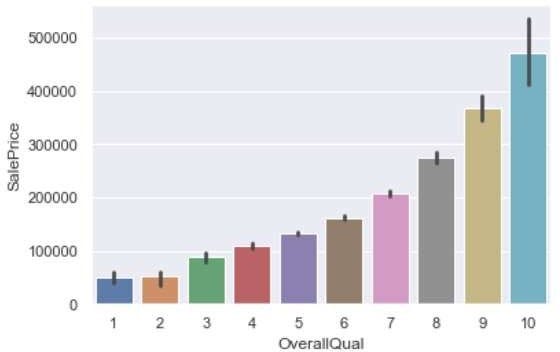
При анализе данных мы замечаем, что функция Общее качество играет огромную роль в определении цены дома.
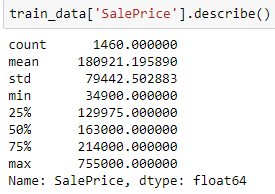
Немного статистики выходной переменной:
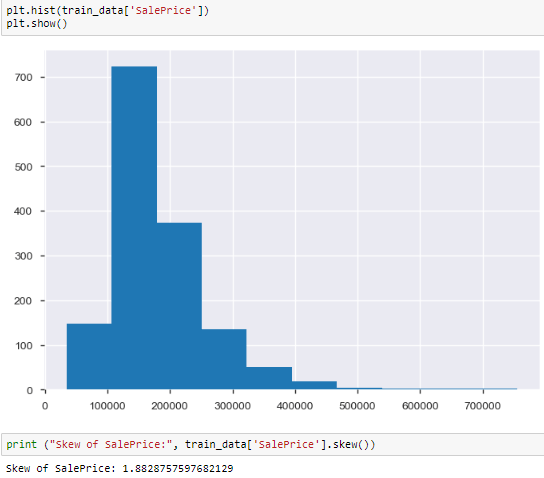
- Затем была визуализирована целевая переменная SalePrice, чтобы найти ее распределение:
Давайте попробуем построить график QQ:
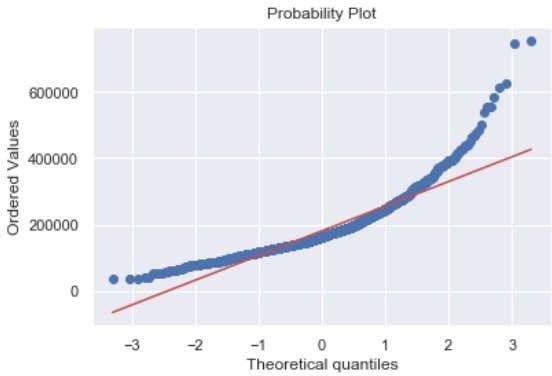
Наблюдение:
- Он выглядит смещенным вправо с отклонением 1,8828757597682129
Решение асимметрии:
Преобразование журнала можно использовать для уменьшения перекоса сильно искаженных распределений. Сравнение средних значений логарифмически преобразованных данных на самом деле является сравнением средних геометрических. Это происходит потому, что, как показано ниже, антилогарифм среднего арифметического логарифмически преобразованных значений является средним геометрическим.
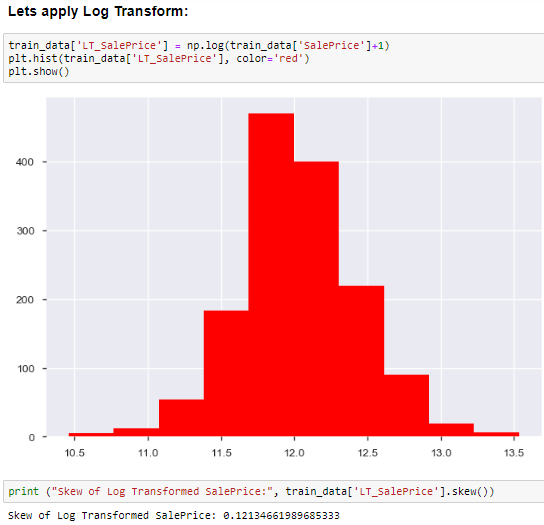
Наблюдение:
- Это выглядит почти нормальным распределением с перекосом 0,1213466198968533
Проверка корреляции с выходными характеристиками:
После этого мы нашли наиболее важные характеристики относительно цели, построив корреляционную матрицу. Матрица корреляции - это таблица, в которой показаны коэффициенты корреляции между переменными. Каждая ячейка в таблице показывает корреляцию между двумя переменными. Коэффициент корреляции имеет значения от -1 до 1.
Корреляции очень полезны во многих приложениях, особенно при проведении регрессионного анализа. Однако его не следует смешивать с причинно-следственной связью и каким-либо образом неправильно истолковывать. Вы также должны всегда проверять корреляцию между различными переменными в вашем наборе данных и собирать некоторые идеи в рамках вашего исследования и анализа.
Мультиколлинеарность:
Если ваш набор данных имеет совершенно положительные или отрицательные атрибуты, то высока вероятность того, что на производительность модели повлияет проблема, называемая - «Многоколлинеарность». Мультиколлинеарность возникает, когда одну переменную-предиктор в модели множественной регрессии можно линейно предсказать на основе других с высокой степенью точности. Это может привести к искаженным или вводящим в заблуждение результатам.

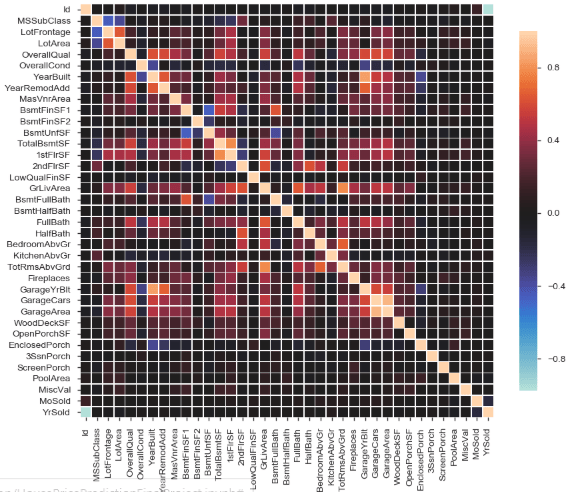
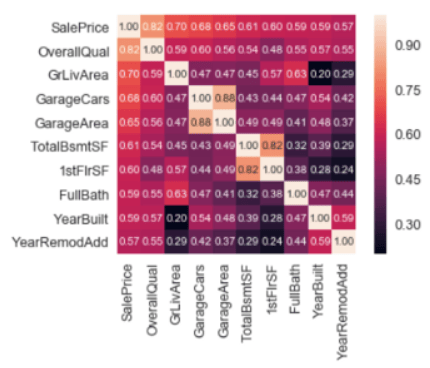
- Исходя из этого, я мог только сказать, что TotalQual, TotalBsmtSF, GarageCars, GarageArea имеют высокую положительную корреляцию с SalePrice. К сожалению, цвета не очень четкие. Ниже приведено лучшее представление со значениями.
Наблюдение:
- Мы видим, что между входными функциями нет особой корреляции. Таким образом, между функциями нет мультиколлинеарности. Это хорошо.
- Некоторые объекты имеют корреляцию Пирсона более 0,5 с функцией вывода.
- Значение, близкое к 0, означает более слабую корреляцию (точное значение 0 означает отсутствие корреляции)
- Значение, близкое к 1, означает более сильную положительную корреляцию.
- Значение, близкое к -1, означает более сильную отрицательную корреляцию.
Предварительная обработка данных:
Многие реальные наборы данных могут содержать пропущенные значения по разным причинам. Они часто кодируются как NaN, пробелы или любые другие заполнители. Обучение модели с набором данных, в котором много пропущенных значений, может существенно повлиять на качество модели машинного обучения. Некоторые алгоритмы, такие как оценщики scikit-learn, предполагают, что все значения являются числовыми и имеют и удерживают значимое значение. Один из способов решения этой проблемы - избавиться от наблюдений, в которых отсутствуют данные. Однако вы рискуете потерять точки данных с ценной информацией. Лучшей стратегией было бы вменять недостающие значения.
Это столбец с нулями:

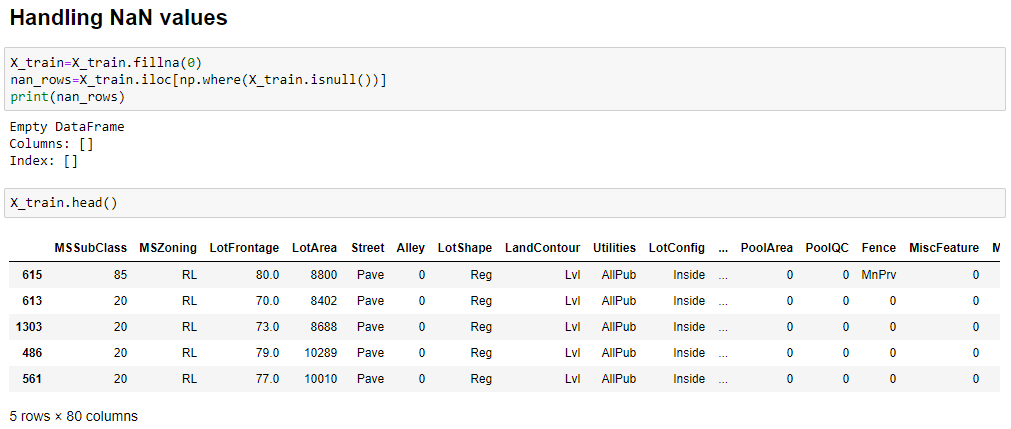
Обработка нулевых значений:
Чтобы попытаться понять, какие значения отсутствуют, я просмотрел документацию по данным . Это помогло мне преобразовать другие функции, чтобы отразить сделанные мной предположения, например, GarageArea или Alley равно нулю. , указывает на то, что у нас нет гаража, и автомобили также должны быть преобразованы в 0.
Модели машинного обучения:
После очистки данных мы перейдем к созданию нашей модели машинного обучения. Поскольку наша целевая переменная является непрерывной, мы подгоним регрессионную модель к набору данных. Цена SalePrice указана в долларах, и мы попытаемся ее предсказать, используя трех- и пятиуровневую нейронные сети и несколько классических алгоритмов машинного обучения.
АЛГОРИТМ 1: «Модель регрессора XGBoost»:
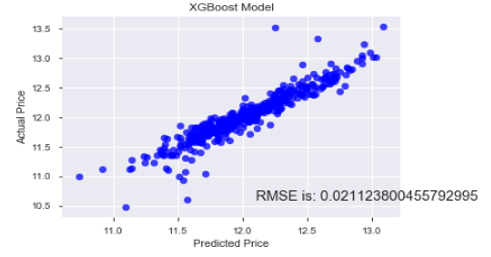
Результат: XGBoost RMSE = 0,0211
АЛГОРИТМ 2: «Модель RidgeRegressor»:
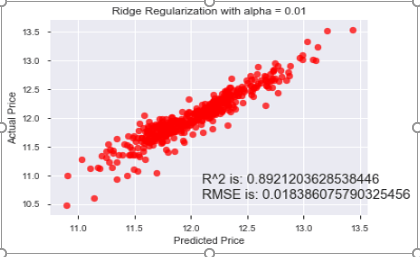
Результат: среднеквадратичное значение Ridge Regressor RMSE = 0,0183
АЛГОРИТМ 3: «Модель линейной регрессии»:

Результат: RMSE линейной регрессии = 0,01721
АЛГОРИТМ 4: «ИНС (2 скрытых слоя, без выпадений, без слоев пакетной нормализации)»:

Результат: ИНС 1: сводка :: полученная потеря валидации = 0,01871
АЛГОРИТМ 5: « ИНС (3 скрытых слоя, DropOuts (0,2), со слоями пакетной нормализации)»:

Результат: ИНС 2: сводка :: полученная потеря валидации = 0,01893
АЛГОРИТМ 6: «ИНС (5 скрытых слоев, DropOuts (0,2), со слоями пакетной нормализации)»:

Результат: ИНС 3: Сводка :: Полученная потеря валидации = 0,01110
СРАВНЕНИЯ с использованием PRETTY TABLE:
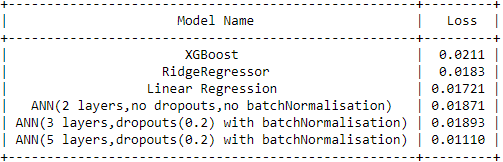
Вывод:
После подачи заявки на конкурс Kaggle здесь находятся таблица лидеров и код. Определенно можно сделать больше.
Спасибо за прочтение!
Использованная литература:
- Харрисон Д. и Д. Л. Рубинфельд. 1978. «Гедонические цены на жилье и спрос на чистый воздух». Дж. Environ. Экон. Manag.5 (1): 81–102.
- Алехандро Бальдоминос, Иван Бланко, Антонио Хосе Морено, Рубен Итуррарте, Оскар Бернардес и Карлос Афонсо, «Определение возможностей в сфере недвижимости с помощью машинного обучения», ноябрь 2018 г.
