Cypher Sleuthing: нетерпеливый оператор
Почему кажется, что один синтаксис запроса работает быстрее, чем другой, когда между операторами очень мало различий? Иногда запросы вызывают так называемый eager operator, чтобы поддерживать согласованные операции и избегать конфликтующих изменений данных.
Тем не менее, остается вопрос, что делает эта активная операция по-другому и почему это настолько важно, чтобы ее специально избегать в определенных ситуациях? В каких ситуациях мы хотели бы выбрать отсутствие желания и избежать автоматического вызова активного желания? Давайте взглянем!
Сайфер нетерпеливый
Документация Cypher на самом деле довольно хорошо объясняет концепцию нетерпеливого оператора, но мне еще не приходилось сталкиваться с этим разделом, пока я не провел небольшое исследование, чтобы лучше понять вопрос пользователя по этой теме. Еще один отличный ресурс, который включает примеры, - это сообщение в блоге моего коллеги, показывающее, как этого избежать в операторах импорта. Используя эти 2 ресурса, я построил несколько примеров, чтобы полностью понять, как это работает. В этом посте мы рассмотрим мои тестовые примеры, чтобы продемонстрировать.
Короче говоря, нетерпеливый оператор гарантирует, что каждая операция в запросе не конфликтует с другими операциями в том же запросе. Это предотвращает изменение данных из предыдущих операций последующими операциями, поддерживая целостность данных и предполагаемый порядок операций. Запросы с несколькими операциями, объединенными в цепочку, могут записать некоторые данные в один фрагмент, а затем прочитать данные в следующем фрагменте, который не синхронизирован. Eager должен гарантировать, что каждая операция применяется ко всем строкам, прежде чем переходить к следующему фрагменту запроса, чтобы избежать конфликтов чтения / записи.
Есть ли разница?
Почему имеет значение, вызывает ли Сайфер рвение или нет?
В запросах, которые не вызывают нетерпение, исполнитель выполняет каждую строку до завершения, прежде чем взять следующую строку и выполнить ее. Он обрабатывает весь запрос для каждой строки, добавляет результат к окончательному выводу, затем берет следующую строку и выполняет на ней весь запрос, добавляет результат к окончательному выводу и так далее. Этот процесс больше похож на поток и обычно добрее до кучи.
Вот оно в логическом и наглядном представлении:
Не нетерпеливый
- Строка 1: Операция1, Операция2, Набор результатов = Строка1 окончательная.
- Строка 2: Operation1, Operation2, Набор результатов = Row1 final, Row2 final.
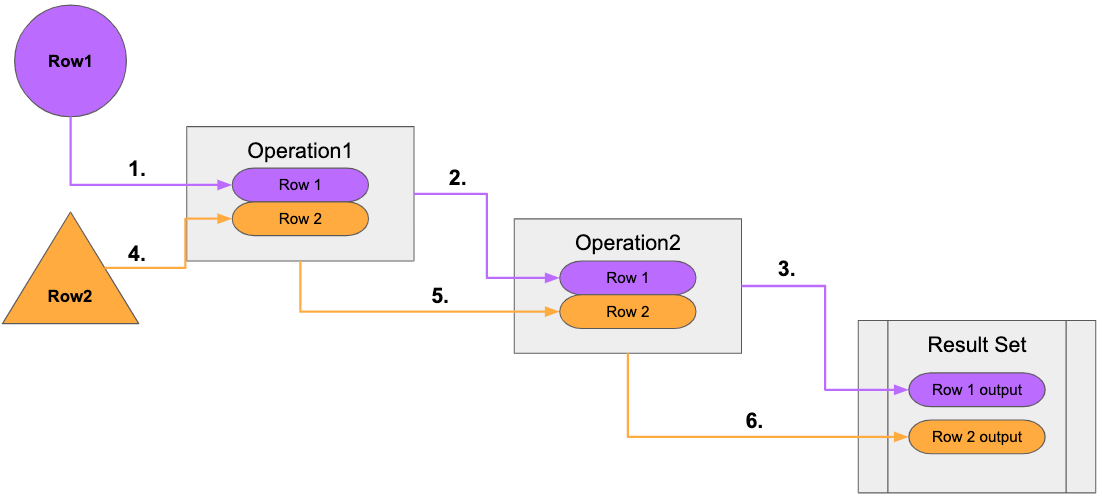
Жаждущий:
- Operation1: Row1, Row2
- Operation2: Row1, Row2
- Набор результатов = Конечная строка 1, Конечная строка 2

Как видно выше, когда вызывается eager, он вместо этого выполняется по принципу от операции к операции. Это может увеличить нагрузку на кучу, поскольку она выполняет одну операцию для всех строк перед передачей всех этих результатов следующей операции (которая выполняется для всех строк) и т. Д. Набор результатов не может начать компиляцию, потому что все результаты сбрасываются в конце после завершения всех операций для всех строк.
Стремление появляется все меньше и меньше, поскольку наши команды находят для Cypher более эффективные способы определения конфликтующих операторов и оптимизации производительности запросов. Однако время от времени вы можете встретить это в своих запросах, и этого, вероятно, можно избежать, изменив синтаксис запроса или разбив более длинные операторы на более короткие и более мелкие операции. По крайней мере, понимание того, когда он появляется и что он делает, может многое рассказать вам о том, как работает Cypher и почему язык работает именно так.
Простой пример с нетерпением
Давайте рассмотрим глупый пример, чтобы увидеть это в действии. У нас есть 5 идентификаторов, которые мы хотим создать в качестве узлов в нашем графе - 1, 2, 3, 4, 5. Наш запрос будет проходить через массив и создавать каждый узел, а затем добавлять ожидаемый следующий узел.
UNWIND [1,2,3,4,5] as id
MERGE (n:Row {id: id})
MERGE (x:Row {id: n.id + 1})
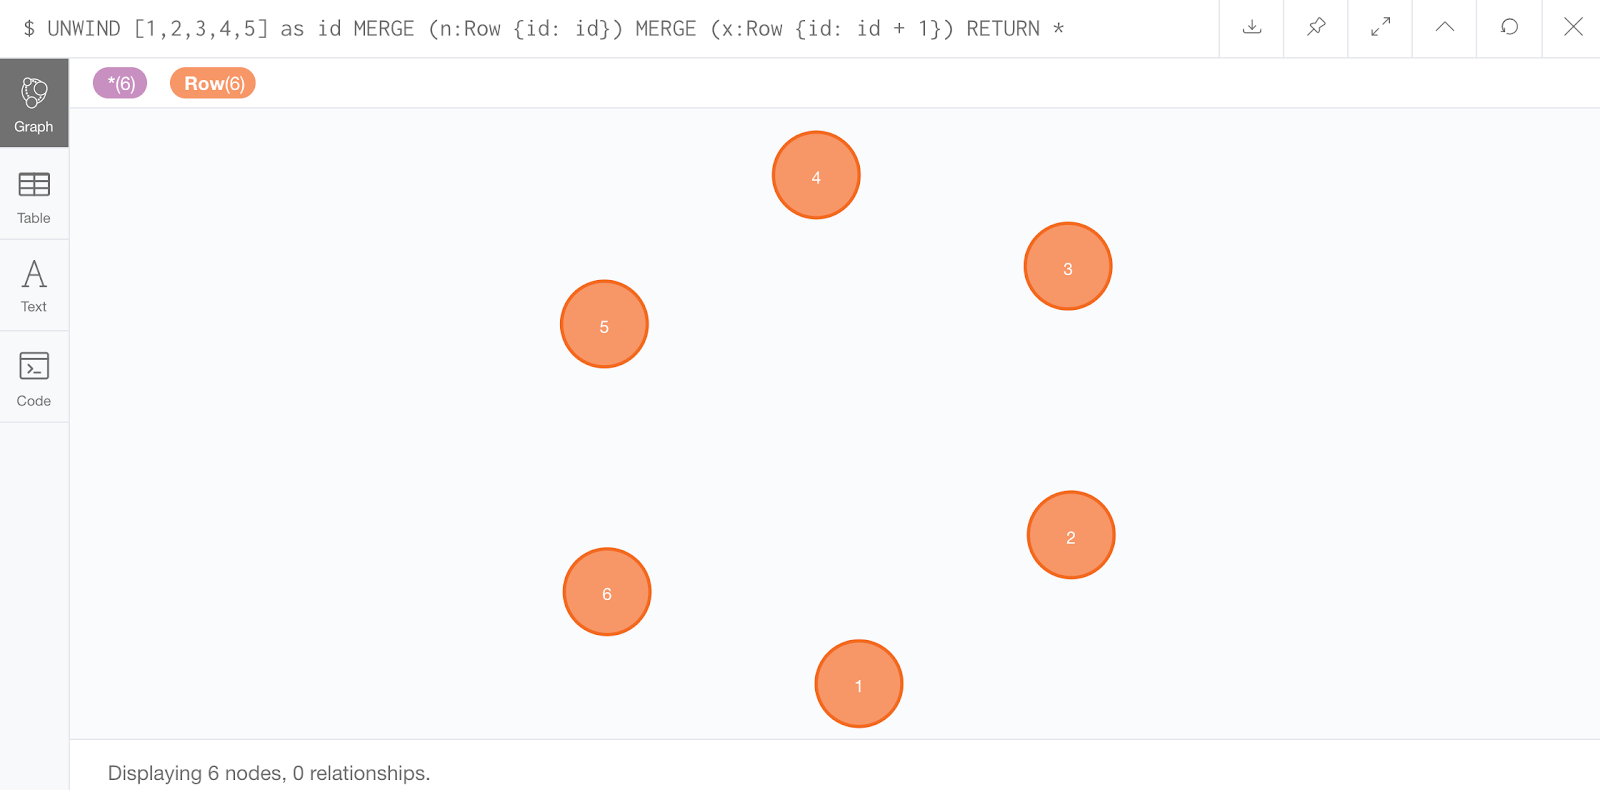
Из-за двух слияний с одной и той же меткой (Row) Cypher избегает потенциального конфликта, выполняя сначала первое слияние для всех строк, а затем второе слияние. Мы можем увидеть нетерпеливый вызов, если поместим ключевое слово PROFILE перед вышеуказанным запросом и выполним его.
PROFILE
UNWIND [1,2,3,4,5] as id
MERGE (n:Row {id: id})
MERGE (x:Row {id: id + 1})
Запустив это, вы должны увидеть результат, похожий на изображение ниже, где операция Eager темно-синим цветом внизу внизу:
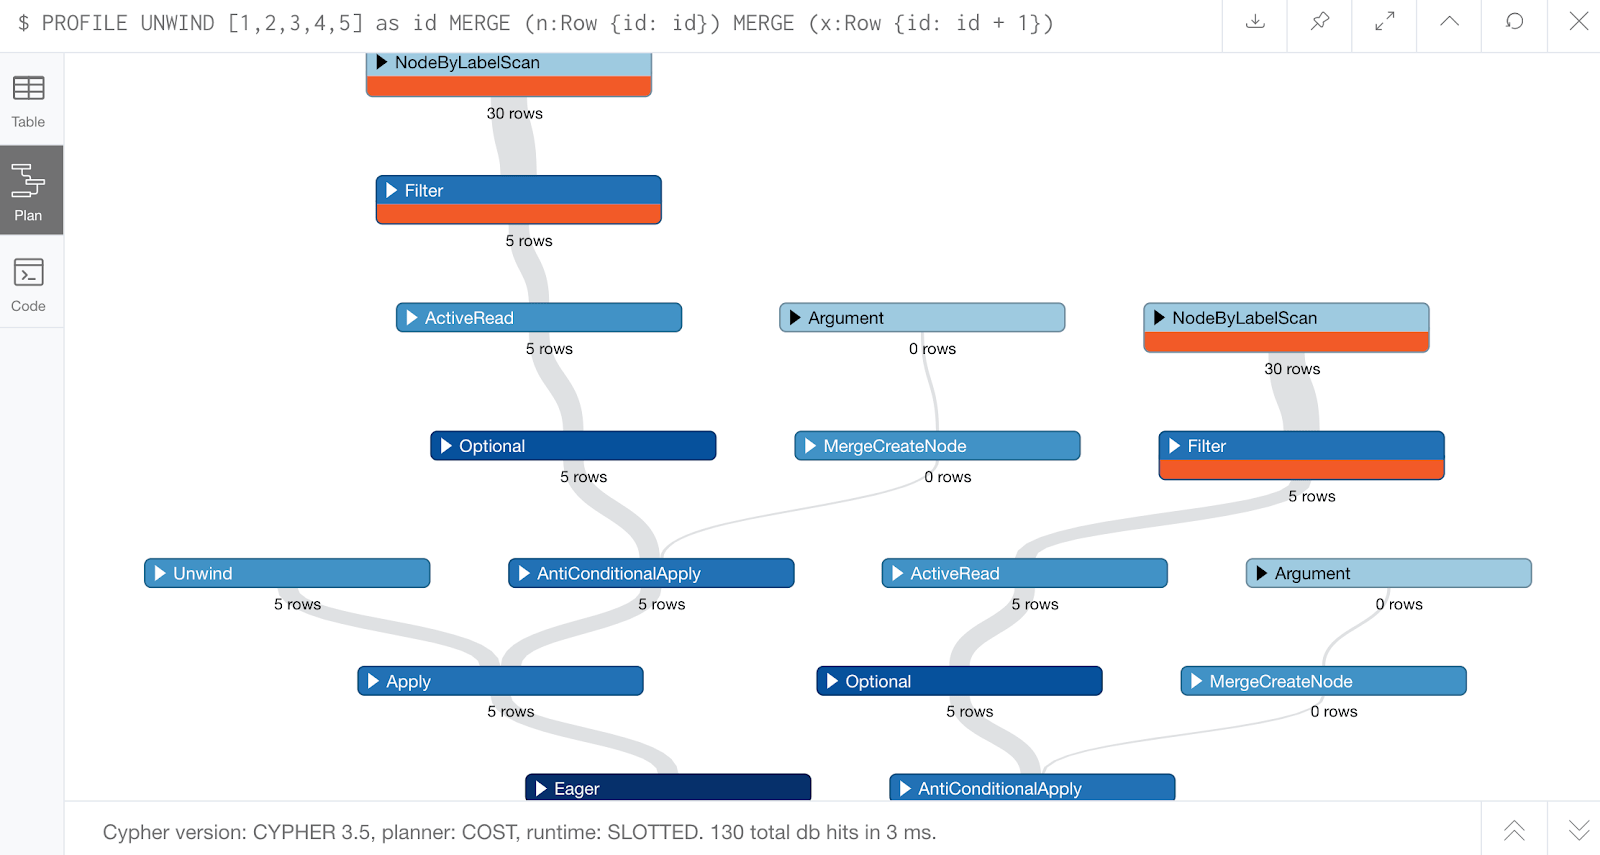
Если вы заметили, есть 2 основные воронки, которые приводят к результату. Первая воронка идет от NodeByLabelScan в верхнем левом углу. Это сводится к обнаруженной нами Eager операции. Другая воронка идет от другой NodeByLabelScan справа. Каждая из этих воронок предназначена для каждой из наших операций слияния. Первое слияние - это создание этих 5 узлов (по 1 для каждой строки, которую мы извлекаем из массива) и выполнение всех этих действий одновременно с энтузиазмом. Второе слияние предназначено для создания ожидаемого следующего узла и синхронизации с первым слиянием в нижней части воронки.
Это очень очевидно, если вы развернете каждую из NodeByLabelScan операций. В верхнем левом углу для первого слияния отображается (n) в деталях. Правый для второго слияния показывает (x) в деталях. Это переменные узла, используемые в каждом из операторов слияния из нашего запроса выше.
Как избежать нетерпения в нашем примере
Чтобы обойти нетерпеливого оператора, мы должны убедиться, что Сайфера не беспокоят конфликтующие операции. Лучший способ сделать это - разделить наш запрос на отдельные операции, чтобы Cypher не использовал в качестве меры предосторожности. Давайте сформируем это как два запроса, чтобы убедиться в этом.
PROFILE
UNWIND [1,2,3,4,5] as id
MERGE (n:Row {id: id})
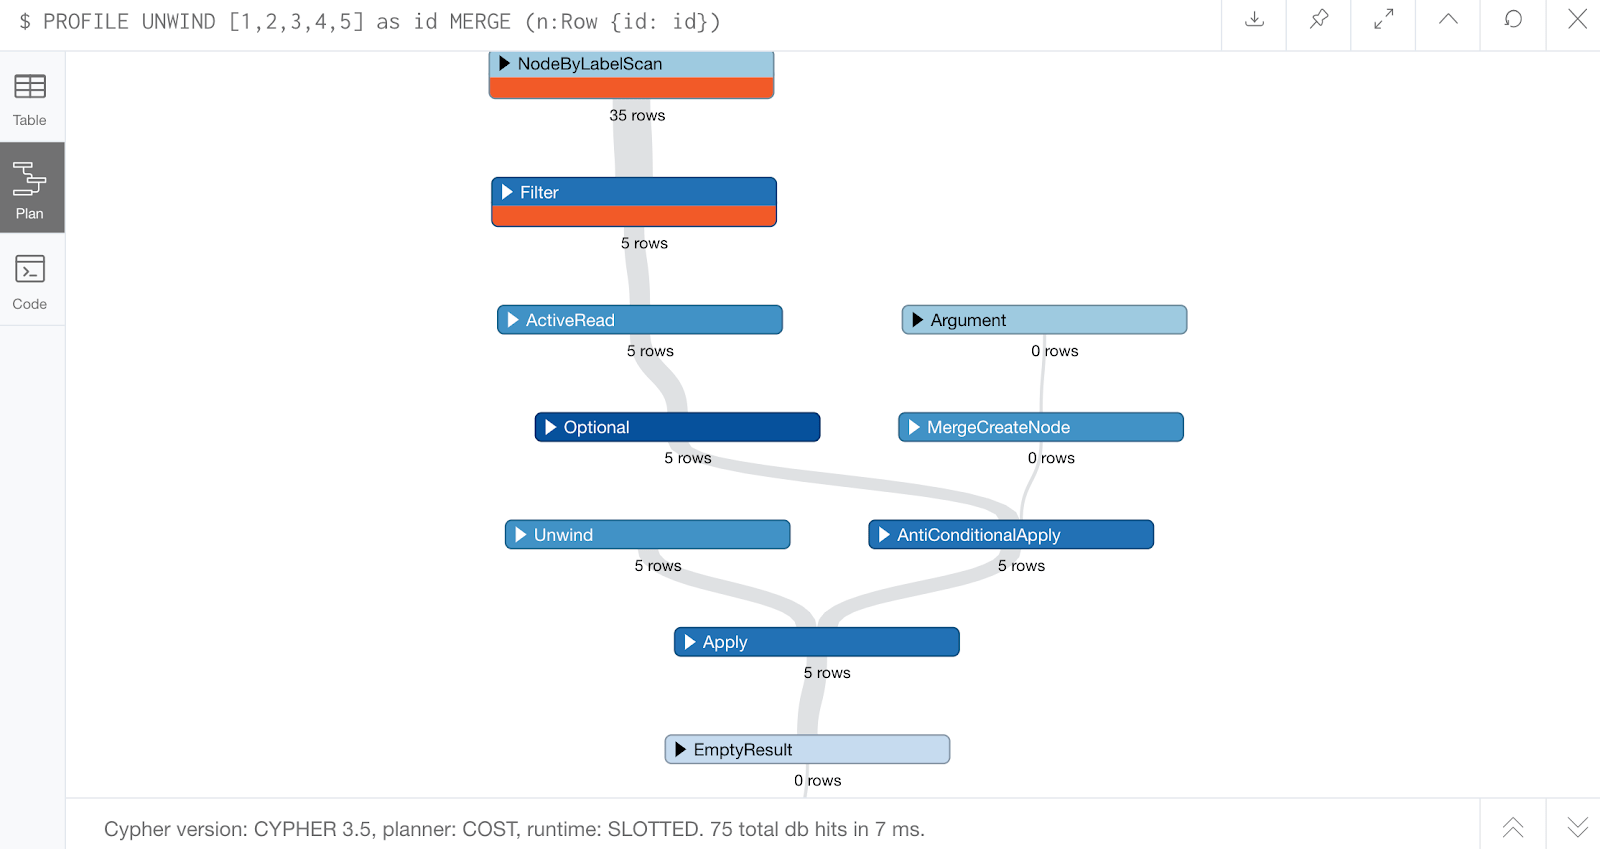
PROFILE
UNWIND [1,2,3,4,5] as id
MERGE (x:Row {id: id + 1})
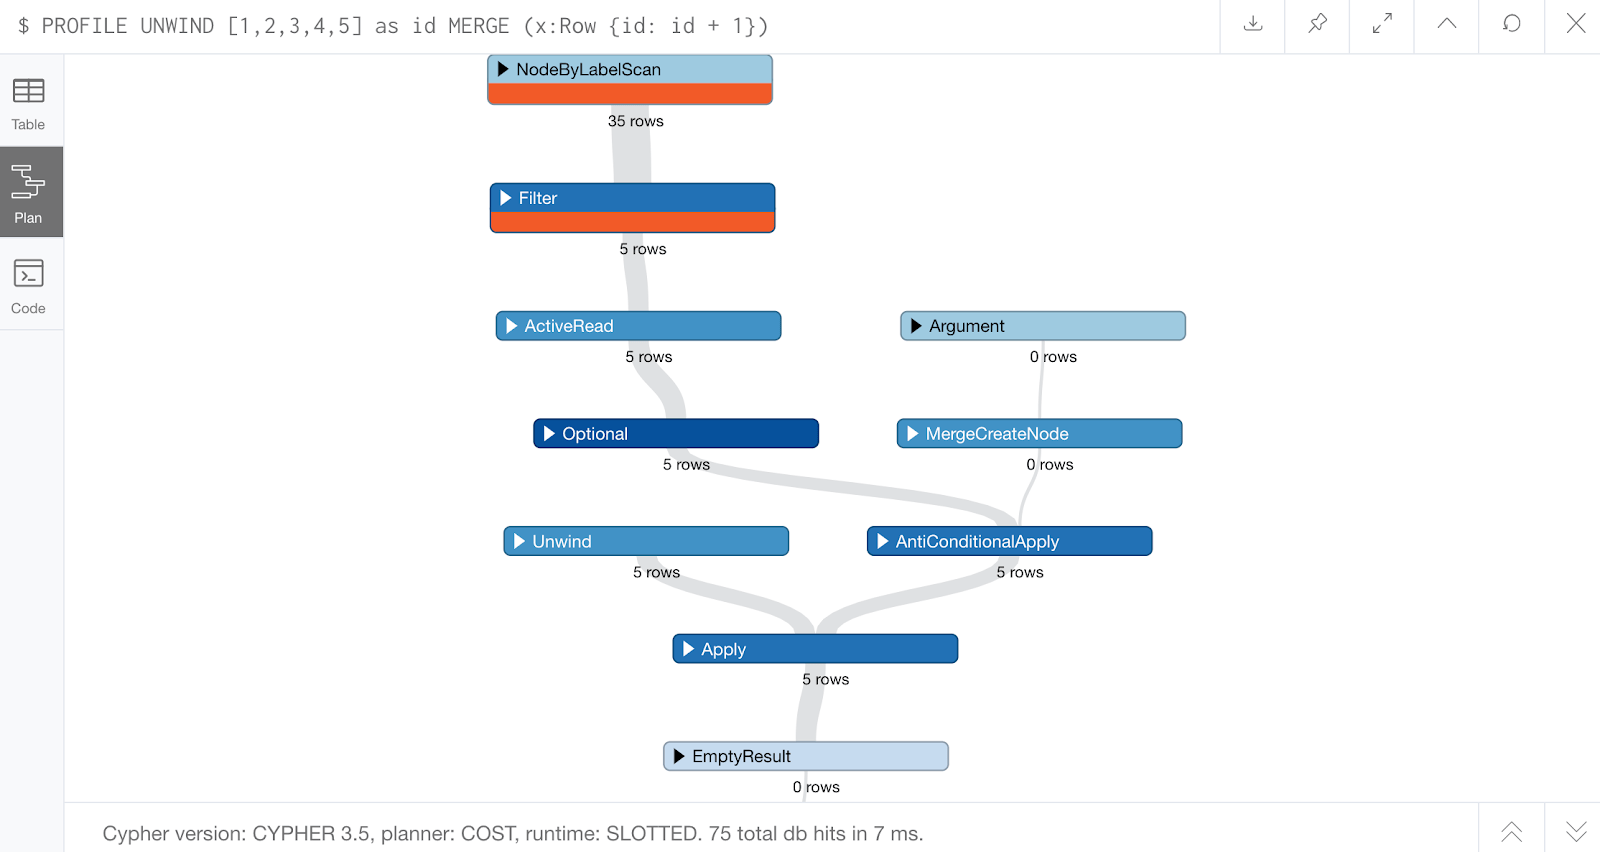
Большой! Ни для одного из них не видно активной работы.
Другой пример
Давайте попробуем еще один пример, чтобы дифференцировать и укрепить наши знания о нетерпеливости. В этом мы используем те же идентификаторы массивов, но на этот раз мы используем их как customer id значения и создаем связанные Employee узлы, которые назначаются этим клиентам и создают отношения между ними.
UNWIND [1,2,3,4,5] as id
MERGE (c:Customer {id: id})
MERGE (e:Employee {id: c.id*10})
MERGE (e)-[r:DEDICATED_TO]->(c)
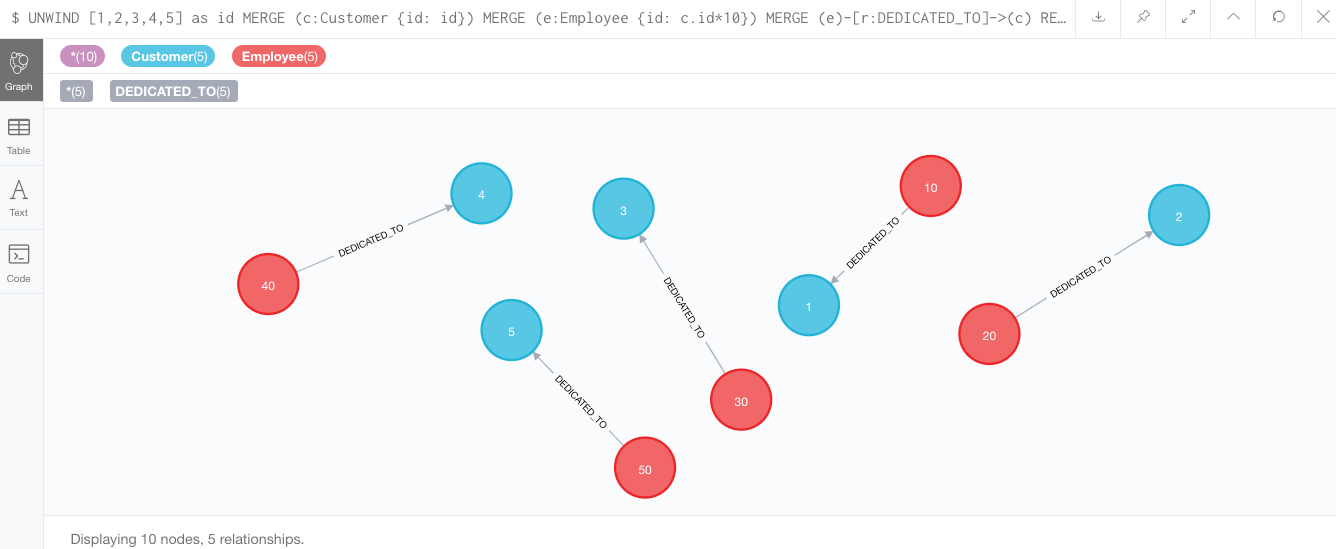
Теперь, если мы запустим этот запрос с ключевым словом PROFILE перед ним, мы увидим, что Cypher здесь не вызывает нетерпение.
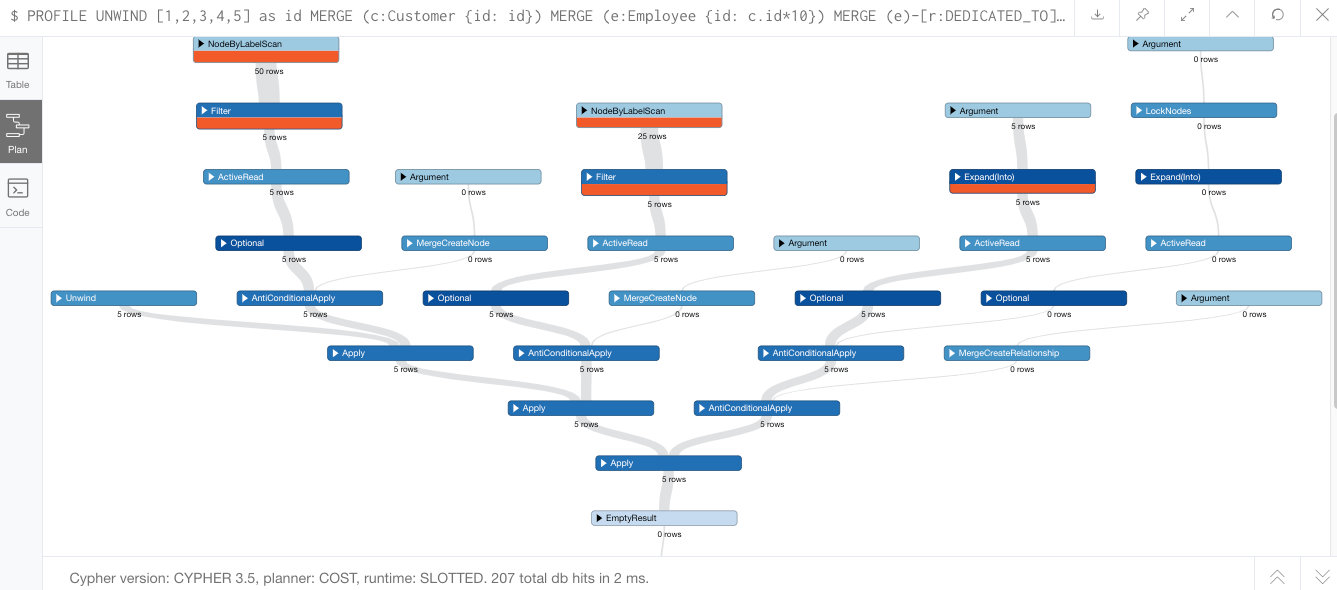
Это почему? Разве отношения не зависят от создания узлов? На самом деле нет. Это потому, что эти записи фактически не конфликтуют друг с другом. Мы не пытаемся записать, а затем снова прочитать те же данные. Мы пишем 3 отдельные операции - запись Customer узла, запись Employee узла, запись Customer/Employee отношения.
Мы можем лучше понять, как это работает, поместив в середину оператор чтения и выполнив для него PROFILE.
PROFILE UNWIND [1,2,3,4,5] as id
MERGE (c:Customer {id: id})
MERGE (e:Employee {id: c.id*10})
WITH c, e, id
MATCH (p:Customer {id: id})
MERGE (e)-[r:DEDICATED_TO]->(c)
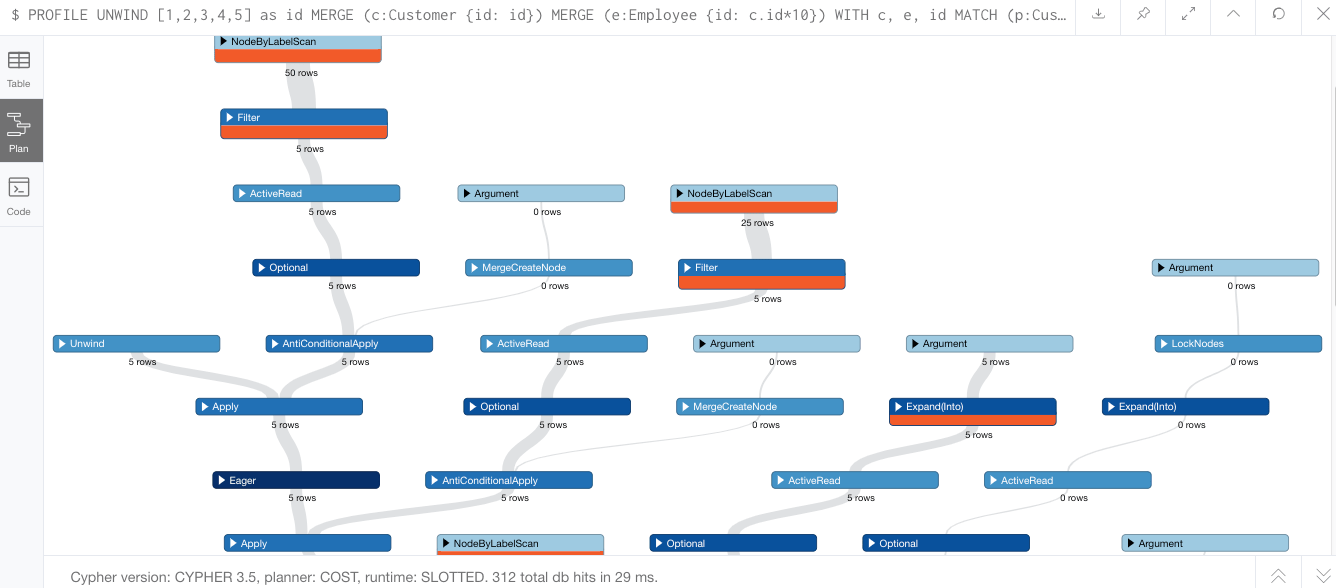
Стремление снова появляется в левом нижнем углу темно-синим цветом. Единственное различие между этим запросом и тем, который у нас был раньше, заключается в том, что мы записываем узлы Customer и Employee, а затем передаем эти результаты следующей операции, которая читает узел Customer (просто проверяя базу данных для узла, который мы только что создали) а затем используя этот узел для создания отношения. Мы просто взяли запрос с 3 операциями записи и превратили его в запрос с 2 операциями записи, 1 чтением и еще одной записью.
Чтение - это то, что вызывает операцию Eager, потому что мы потенциально читаем только что созданные данные. Выполняя слияние, а затем чтение, мы потенциально могли потерять результаты в нашем чтении, которые еще не были записаны при первой записи. Вот почему Cypher сначала выполняет все операции записи (слияние Customer, слияние Employee), а затем переходит к чтению и окончательной записи.
Удаление этого оператора чтения в середине позволяет избежать нетерпеливого оператора и гарантирует, что у нас не будет конфликтующих операций, и мы вернемся к оптимизированным операциям!
Заворачивать
Вам не нужно беспокоиться об этом операторе, если ваш набор данных невелик или если ваши операции запроса просты. Однако при интенсивной обработке и больших наборах данных это может быть что-то, что нужно проверить, если ваши запросы выполняются медленно. Если есть сомнения, по возможности разбейте операции на отдельные запросы и запустите PROFILE, чтобы увидеть, что Cypher делает за кулисами.
Удачного кодирования!
Ресурсы
- Cypher мануал: Жадный оператор
- Руководство Cypher: Стремление к исполнению планов
- Сообщение в блоге: Избегая нетерпеливости
- Настройка запросов: Профилирование запросов
- Задайте свои вопросы: Сайт сообщества Neo4j
