Как уроки применения компьютерного зрения в геолокации повлияют на анализ биоизображений (часть 1)
Автор Ник Вейр (старший специалист по данным, In-Q-Tel CosmiQ Works), Дж. Дж. Бен-Джозеф (сотрудник технического персонала, In-Q-Tel B.Next) и Дилан Джордж ( вице-президент, технический персонал, In-Q-Tel B.Next).
Это вторая часть совместной работы CosmiQ Works и B.Next, опубликованная в обоих блогах.
Введение
Марк Андрисен охарактеризовал компании-разработчики программного обеспечения как поедающие традиционный бизнес. Точно так же компьютерное зрение начало пожирать мир ручного анализа изображений. Однако когда мы выходим за рамки стандартных фотографий и входим в нишевые области, такие как биологические изображения (медицинские изображения, данные микроскопии) и спутниковые изображения, это оказывается менее верным. Компьютерное зрение поглощает эти данные, как чарльстонское жевательное зелье, оставленное на улице зимой в Новой Англии: изо всех сил пытается откусить его, отламывает мелкие кусочки, затем усердно пережевывает, прежде чем, наконец, проглотить (или выплюнуть обратно в отчаянии). IQT CosmiQ Works внимательно отслеживала развитие приложений ИИ и компьютерного зрения для спутниковых изображений, извлекая ключевые уроки о трудностях, связанных с переходом инструментов ИИ между областями. В то же время CosmiQ Works и команда IQT B.Next заметили, что разработка ИИ-продуктов для медицины на несколько лет отстает от соответствующих геопространственных приложений и только начинает набирать обороты. В этой серии блогов мы рассмотрим, почему ИИ изо всех сил пытается завоевать популярность как со спутниковыми снимками, так и с медициной. Мы также рассмотрим некоторые сходства и различия между спутниковыми снимками, микроскопией и обычными фотографиями, а также причины, по которым исследователи, разрабатывающие методы искусственного интеллекта для микроскопии, могут захотеть тщательно изучить работу, проделанную в геопространственной области.
Что такое компьютерное зрение и как оно пожирает мир изображений?
Компьютерное зрение — это термин, охватывающий широкий спектр методов, которые компьютеры используют для интерпретации изображений и видео. До 2010 года это в основном достигалось с помощью набора инструментов, включающего обнаружение границ, сегментацию водоразделов и другие эвристические методы.
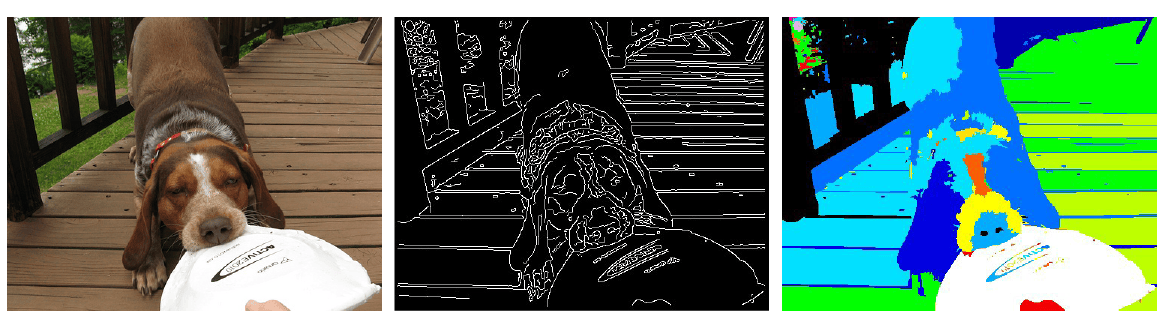
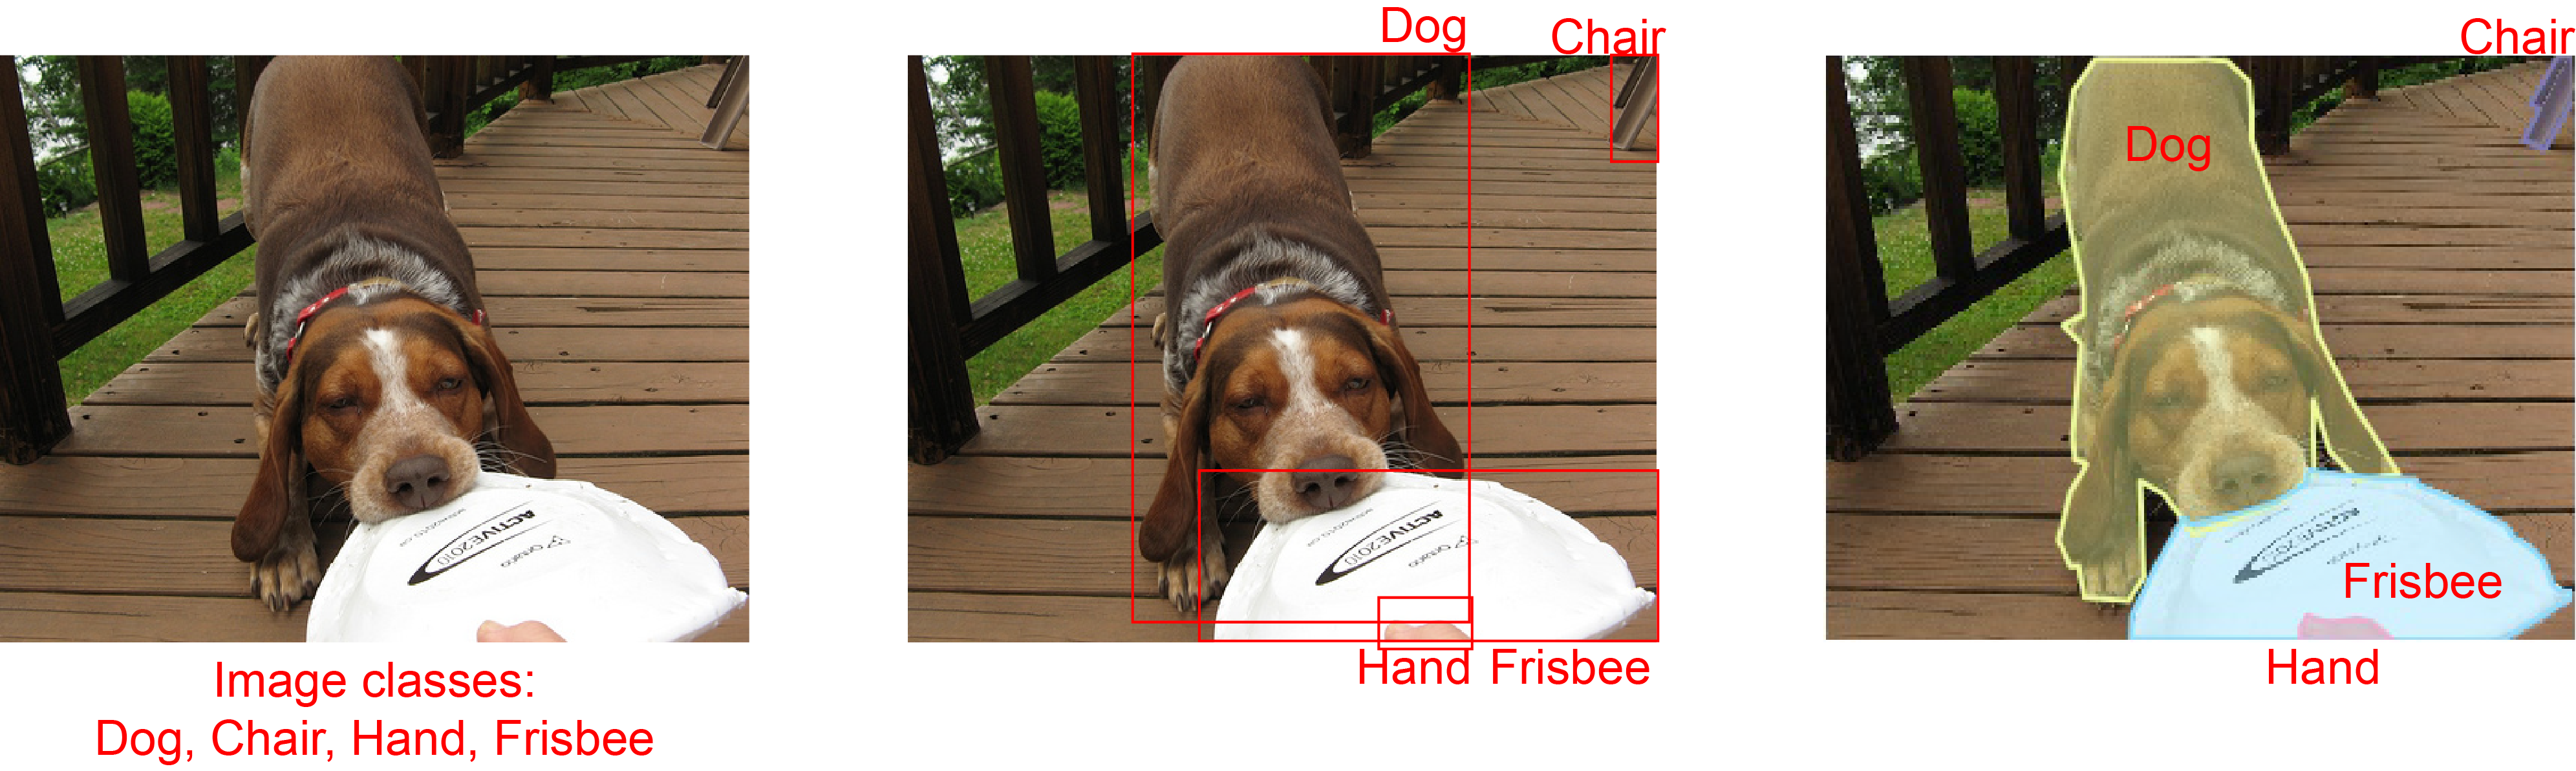
Взрыв глубоких искусственных нейронных сетей, начавшийся примерно в 2010 году, перевернул область компьютерного зрения. Глубокие нейронные сети неоднократно применяют простые математические операции для представления все более абстрактных функций исходного входного изображения. Глубокое обучение можно рассматривать как автоматический способ выбора правильных шагов для последовательной обработки данных и создания прогноза: например, чтобы предсказать, где находится объект на изображении. Глубокие нейронные сети проникли в обработку изображений с появлением сверточных нейронных сетей (CNN), которые были впервые описаны в 1980-х годах и получили распространение в новом тысячелетии, когда расширенные вычислительные мощности сделали возможными сложные сети. CNN позволяют исследователям компьютерного зрения достигать различных целей, от классификации изображений до идентификации интересующих объектов и, в частности, отслеживания границ каждого отдельного объекта.
По мере того, как такие компании, как Google, Amazon и Apple, начали создавать продукты, основанные на этих методах, многие из них начали расширять приложения за пределы обычных фотографий (например, фотографии с камеры телефона, камеры видеонаблюдения, камеры на приборных панелях автомобилей) в новые области: медицинские изображения, геопространственные изображения, 3D. данные, такие как обнаружение света и определение дальности (LIDAR), и даже проекции изображений аудио и генетических данных, среди прочего. Различия, присущие этим «необычным» типам изображений, создают уникальные проблемы, которые необходимо решить, прежде чем можно будет применять новейшие и лучшие методологии компьютерного зрения. Здесь мы подробно рассмотрим эти проблемы в геопространственной области, где IQT CosmiQ Works потратила несколько лет на изучение того, как применять самые современные методы компьютерного зрения к спутниковым изображениям. Многие из проблем, с которыми столкнулся CosmiQ, аналогичны анализу медицинских изображений, особенно данных микроскопии, которые будут более подробно рассмотрены в последующих блогах.
Расширение возможностей компьютерного зрения и искусственного интеллекта: испытания и невзгоды спутниковых снимков
Что такое спутниковые снимки?
Давайте начнем с самого фундаментального вопроса: что такое спутниковые снимки и чем они отличаются от естественных сцен? Давайте посмотрим на пример каждого рядом:
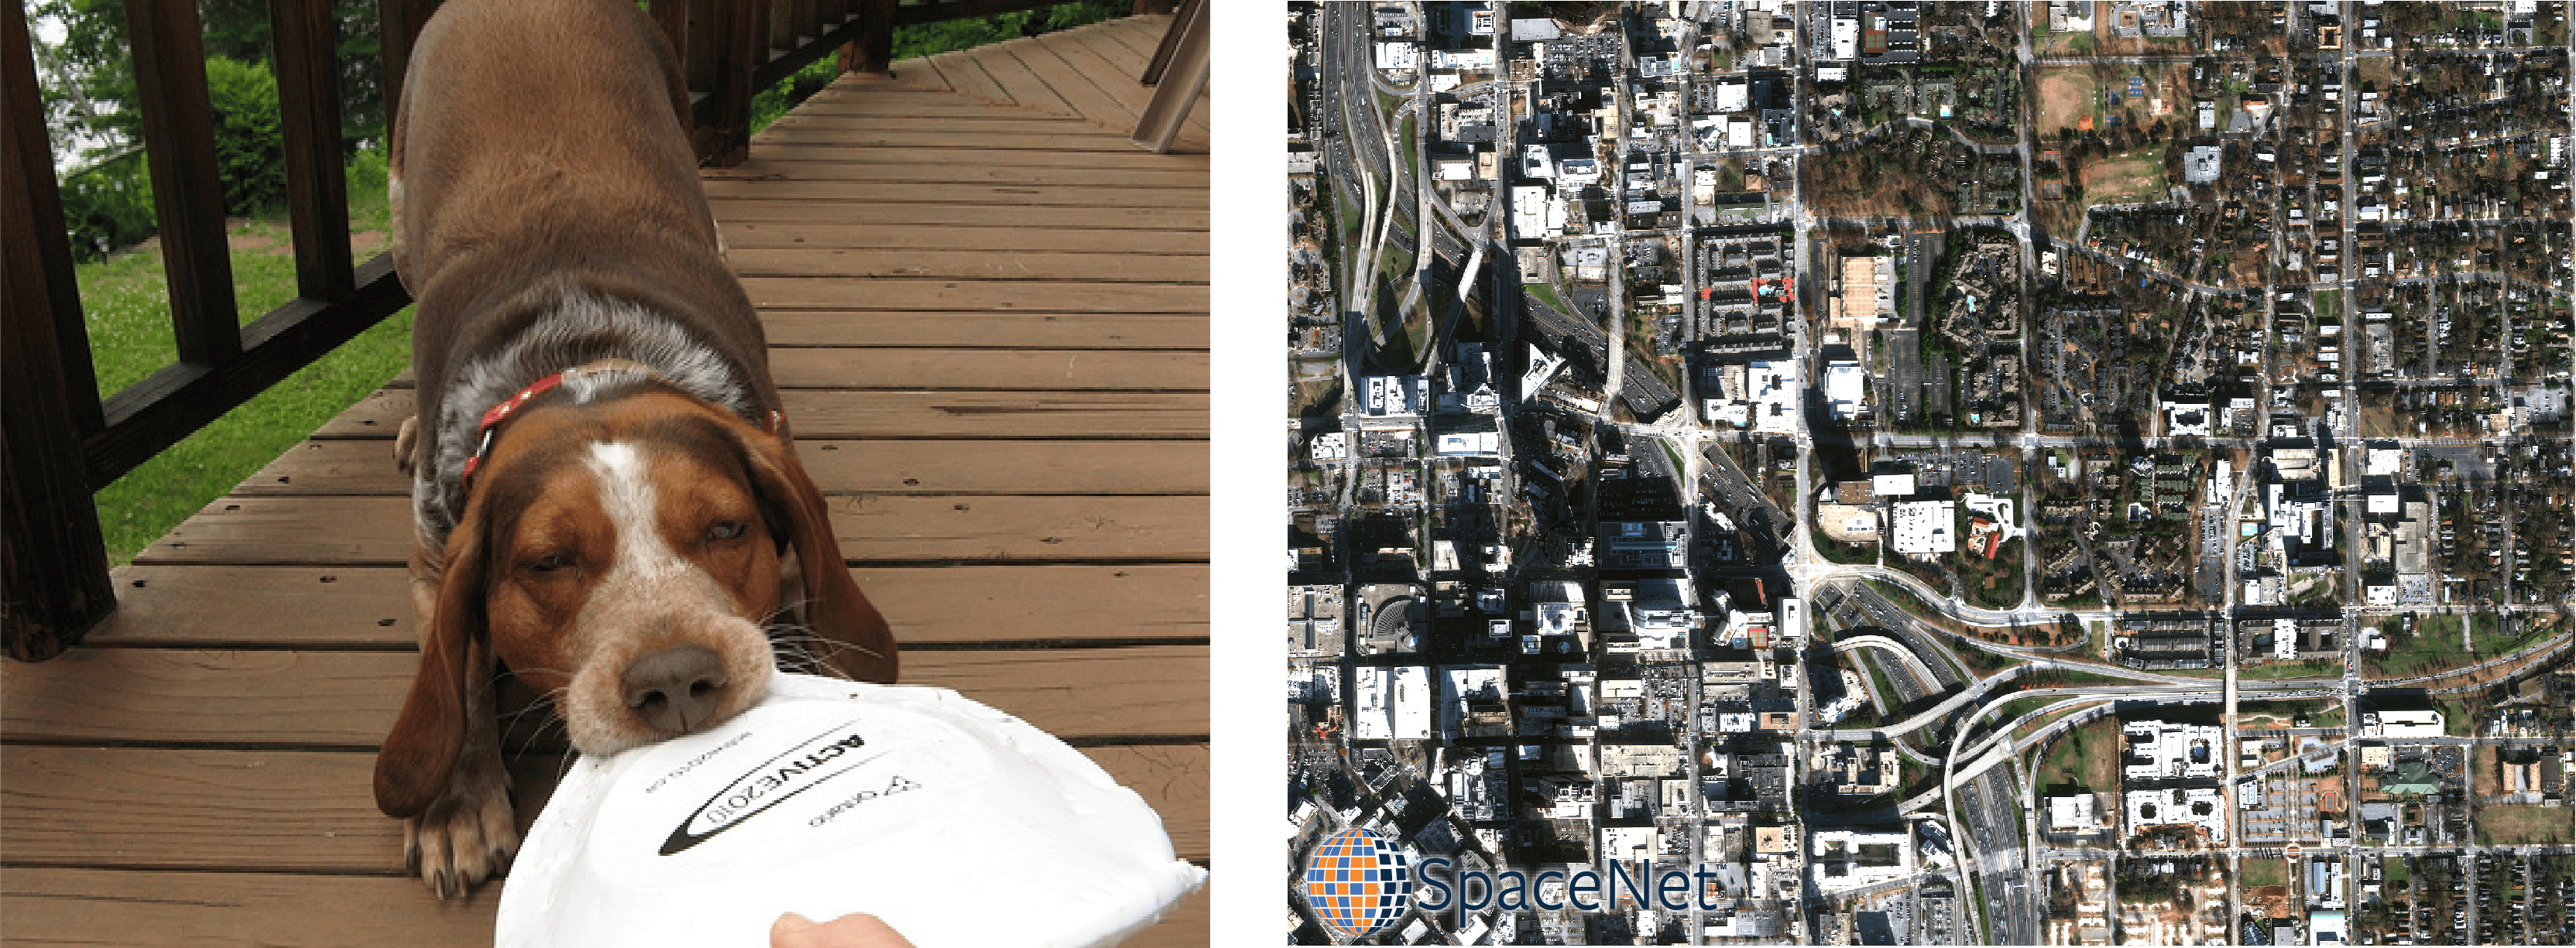
Давайте представим, что нас попросили разработать алгоритмы для идентификации и отслеживания границ интересующих объектов на этих изображениях (проблема «сегментации экземпляров», для экспертов CV). На фотографии естественной сцены нам нужно найти все объекты переднего плана (собака, фрисби, палец); на спутниковом снимке мы пытаемся найти все здания и дороги. В чем сходство и различие этих задач?

Начнем со сходства этих задач. В обоих случаях мы пытаемся выделить все отдельные целевые объекты, поэтому один и тот же тип алгоритма должен работать для обоих типов изображений. Это фотографии, поэтому сверточные нейронные сети должны помочь. Однако на этом сходство заканчивается и появляются проблемы, связанные со спутниками.
Размер и изобилие объекта
Неудивительно, что на спутниковых снимках целевые объекты обычно кажутся намного меньше, что затрудняет их поиск. На приведенной выше фотографии естественной сцены изображена только одна собака, и она содержит более 48 000 пикселей, что составляет около четверти изображения. Напротив, спутниковое изображение содержит много зданий, но они очень маленькие — здания в наборе данных SpaceNet Atlanta в среднем составляют около 1200 пикселей, или 2,5% размера собаки слева. Поскольку расположение пикселей и цвет предоставляют информацию, которая говорит нам, что такое собака, пожарный гидрант или здание, количество пикселей в каждом объекте определяет, сколько информации модель может использовать для его идентификации. Исследования показали, что CNN используют текстуру для идентификации объектов на изображениях, а объекты меньшего размера содержат меньше информации о текстуре. Конечный результат: более мелкие объекты труднее найти, что затрудняет анализ спутниковых изображений для современных современных моделей компьютерного зрения.
Точно так же, как размер объекта несовместим с обычными фотографиями и снимками со спутника, несовместима и плотность объектов. Давайте сравним распределение количества зданий на изображении в наборе данных SpaceNet Atlanta с количеством объектов на изображении в наборе обучающих данных COCO:
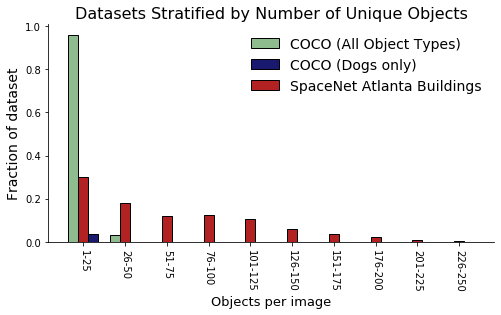
Разница разительна: в наборе данных спутниковых снимков SpaceNet больше изображений со многими объектами, чем в COCO. Напротив, количество объектов, представляющих интерес, на фотографиях естественных сцен гораздо более постоянно. Даже в случаях редких объектов на изображениях естественной сцены для изображений, содержащих объекты, необычно иметь более нескольких экземпляров цели: см. Разбивку категории COCO собаки выше. Конечным результатом является то, что изображения естественной сцены имеют гораздо более однородное количество объектов. Это особенно актуально для алгоритмов обнаружения объектов, где алгоритм должен узнать, сколько объектов нужно идентифицировать (или иметь это значение, предоставленное специалистом по данным).
Полосы визуализации
В отличие от повседневных фотографий, спутниковые изображения редко состоят из стандартной трехканальной комбинации красный-зеленый-синий (RGB). Многие спутники собирают данные на самых разных длинах волн света, включая экстра-синий прибрежный диапазон, желтый, ближний инфракрасный (NIR), коротковолновый инфракрасный (SWIR) и другие (рис. 6). Обширные исследования показали, что эти дополнительные полосы помогают идентифицировать такие объекты, как растительность, городские районы и водоемы, что делает их важными для включения во многие задачи спутникового компьютерного зрения. Восемь или более диапазонов часто предоставляются в коммерческих продуктах спутниковых изображений, таких как мультиспектральные продукты изображений от Maxar Technologies.
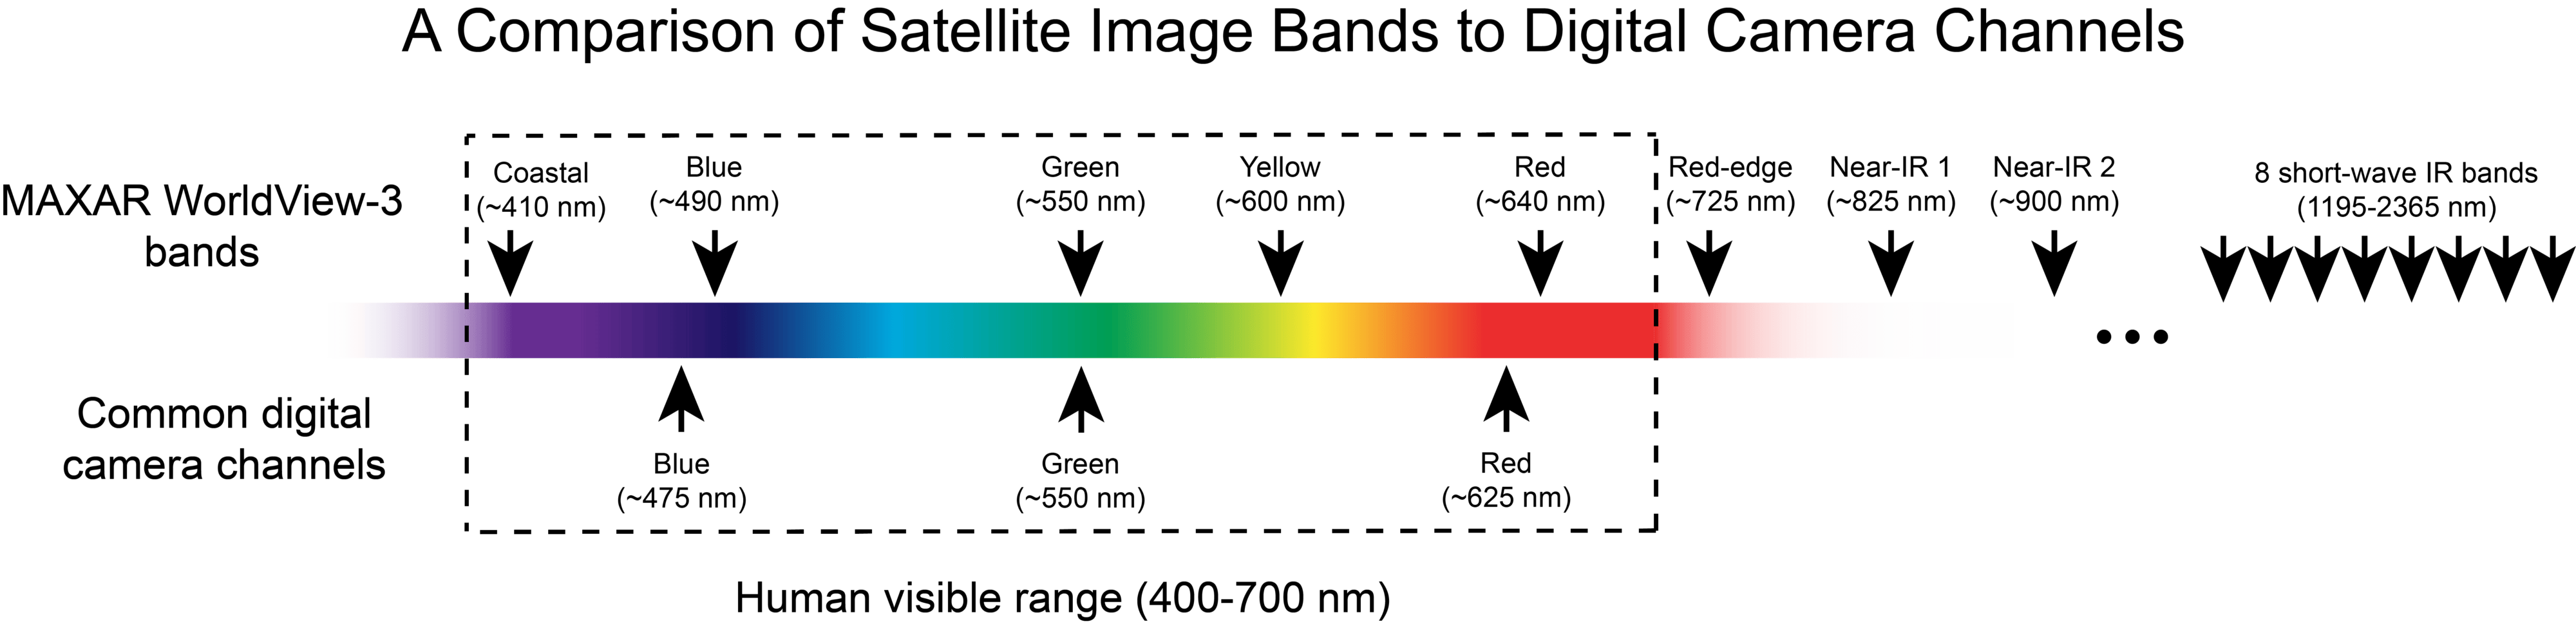
Однако, поскольку большинство моделей компьютерного зрения предполагают 3-канальные входные сигналы RGB, они не могут вместить эти дополнительные данные. Некоторые специалисты по геопространственным данным обходят это, начиная с предварительно обученных моделей для RGB, а затем обучая другие диапазоны с нуля, но обучение этих моделей может быть трудным и неэффективным. Нехватка моделей, разработанных и предварительно обученных на так называемых мультиспектральных спутниковых снимках, очень затрудняет эффективное использование этих данных.
Размер изображения
Огромный размер среднего спутникового изображения создает еще одну проблему. Наборы данных SpaceNet состоят из около 35 спутниковых снимков, охватывающих 10 городов мира. Их размеры различаются, но большинство из них имеют размер примерно 150 000 на 50 000 пикселей, что примерно в 900 раз превышает размер изображения 4 K UHD. Немногие модели компьютерного зрения могут вмещать изображения размером более 1024 пикселей по стороне, а это означает, что для анализа одного спутникового снимка специалисту по обработке данных минимально потребуется разделить его на более чем 7000 частей и запустить каждую отдельно — а это соответствует лишь примерно 0,1% ежедневная мощность сбора данных для MAXAR Worldview-3, спутника, который собрал большую часть набора данных SpaceNet! Мозаичное изображение таким образом также создает дополнительные проблемы: краевые эффекты распространены в алгоритмах машинного обучения, а согласование объектов на границах между двумя плитками может быть затруднено. Как мы более подробно рассмотрим в нашем следующем блоге, это также верно для микроскопических изображений, где сканы всего предметного стекла очень велики.
Доступность данных
Ограниченный общедоступный доступ к хорошо маркированным спутниковым изображениям замедлил исследования и разработки. Хотя компании начинают предоставлять услуги по маркировке повседневных изображений, очень немногие маркируют изображения сверху, учитывая дополнительные проблемы, которые они создают. В результате не так много хорошо размеченных общедоступных наборов данных спутниковых изображений для сравнительного анализа алгоритмов ИИ, а это означает, что обучать модели и надежно оценивать производительность сложно. Это замедляет исследования и затрудняет демонстрацию ценности продукта. Кроме того, большинство существующих наборов данных с открытым исходным кодом либо ограничены географически, либо относительно малы, либо имеют непоследовательные маркировки. Компании, которые хотят применить машинное обучение к изображениям сверху, вероятно, должны будут заказать маркировку пользовательского набора данных, подходящего для их варианта использования, что является сложной и часто непомерно дорогой задачей на нынешнем рынке.
Экспертиза домена
Последним барьером, на который стоит обратить внимание, является объем знаний в предметной области, необходимый для изучения приложений компьютерного зрения в геопространственной сфере. Помимо всех концепций науки о данных, для разработки алгоритмов компьютерного зрения необходимо понимать линейную алгебру, сверточные нейронные сети и статистику, и это лишь некоторые из них. ), форматы геопространственных данных (например, GeoJSON) и ряд других концепций, связанных с геопространственными данными. Добавьте к этому дополнительные программные инструменты, с которыми должны быть знакомы специалисты по геопространственным данным, такие как GDAL, QGIS или ArcGIS, и неудивительно, что попытка нанять хорошо оснащенных специалистов по геопространственным данным подобна попытке нанять единорогов. Как мы обсудим в следующем посте этой серии, этот барьер усиливается только в медицинской сфере.
Состояние геопространственного машинного обучения сегодня
Из-за вышеупомянутых различий и других проблем геопространственные приложения ИИ отстают от повседневных фотографий и видео. Это привело к возникновению проблемы курицы и яйца: для геопространственного анализа было разработано мало моделей ИИ, потому что существует мало распространенных коммерческих приложений для геопространственного ИИ (возможно, из-за того, что доступно мало явно полезных моделей). Компании, занимающиеся геопространственной аналитикой, относительно редки, а исследования в области геопространственной аналитики составляют ничтожную долю работ, представленных на конференциях по компьютерному зрению. Учитывая ограниченное число экспертов, ограниченный коммерческий рынок и отсутствие хорошо размеченных данных для разработки моделей, неудивительно, что геопространственные приложения ИИ пока не процветают.
Вывод
В этом блоге мы представили пример того, как могут возникнуть проблемы при переходе от повседневных фотографий к необычным изображениям. Многие из этих трудностей имеют аналоги в других областях, включая медицинские изображения, область, которую специалисты по компьютерному зрению и искусственному интеллекту только начинают исследовать в соответствии с продуктом. Оставайтесь с нами во второй части серии, в которой мы углубимся в ИИ для медицинских изображений и какие уроки эта область может извлечь из разработки продуктов геопространственного ИИ.
