Прошло некоторое время с тех пор, как я обновлял информацию об индивидуальном учебном проекте. Итак, вот оно! Нейронная сеть для предсказания учащегося, заходящего на сайт myCourseville, на какой курс пойдет этот учащийся.
Вот краткое изложение первой части (рассказ ниже). Во-первых, речь шла об общей идее нейронной сети. Затем он представил функции, используемые в первой модели, но результат равен 0.
Цель
Итак, поехали снова. На этот раз я хотел просто превзойти три наиболее часто посещаемых поля, которые дали 0,3 макро-балла F1.
Функции
В этом проекте использовались четыре функции. Первыми двумя были оценка и материал матрицы, которые представляли собой баллы, указывающие на свежесть времени, когда была произведена оценка, и материал был загружен соответственно.
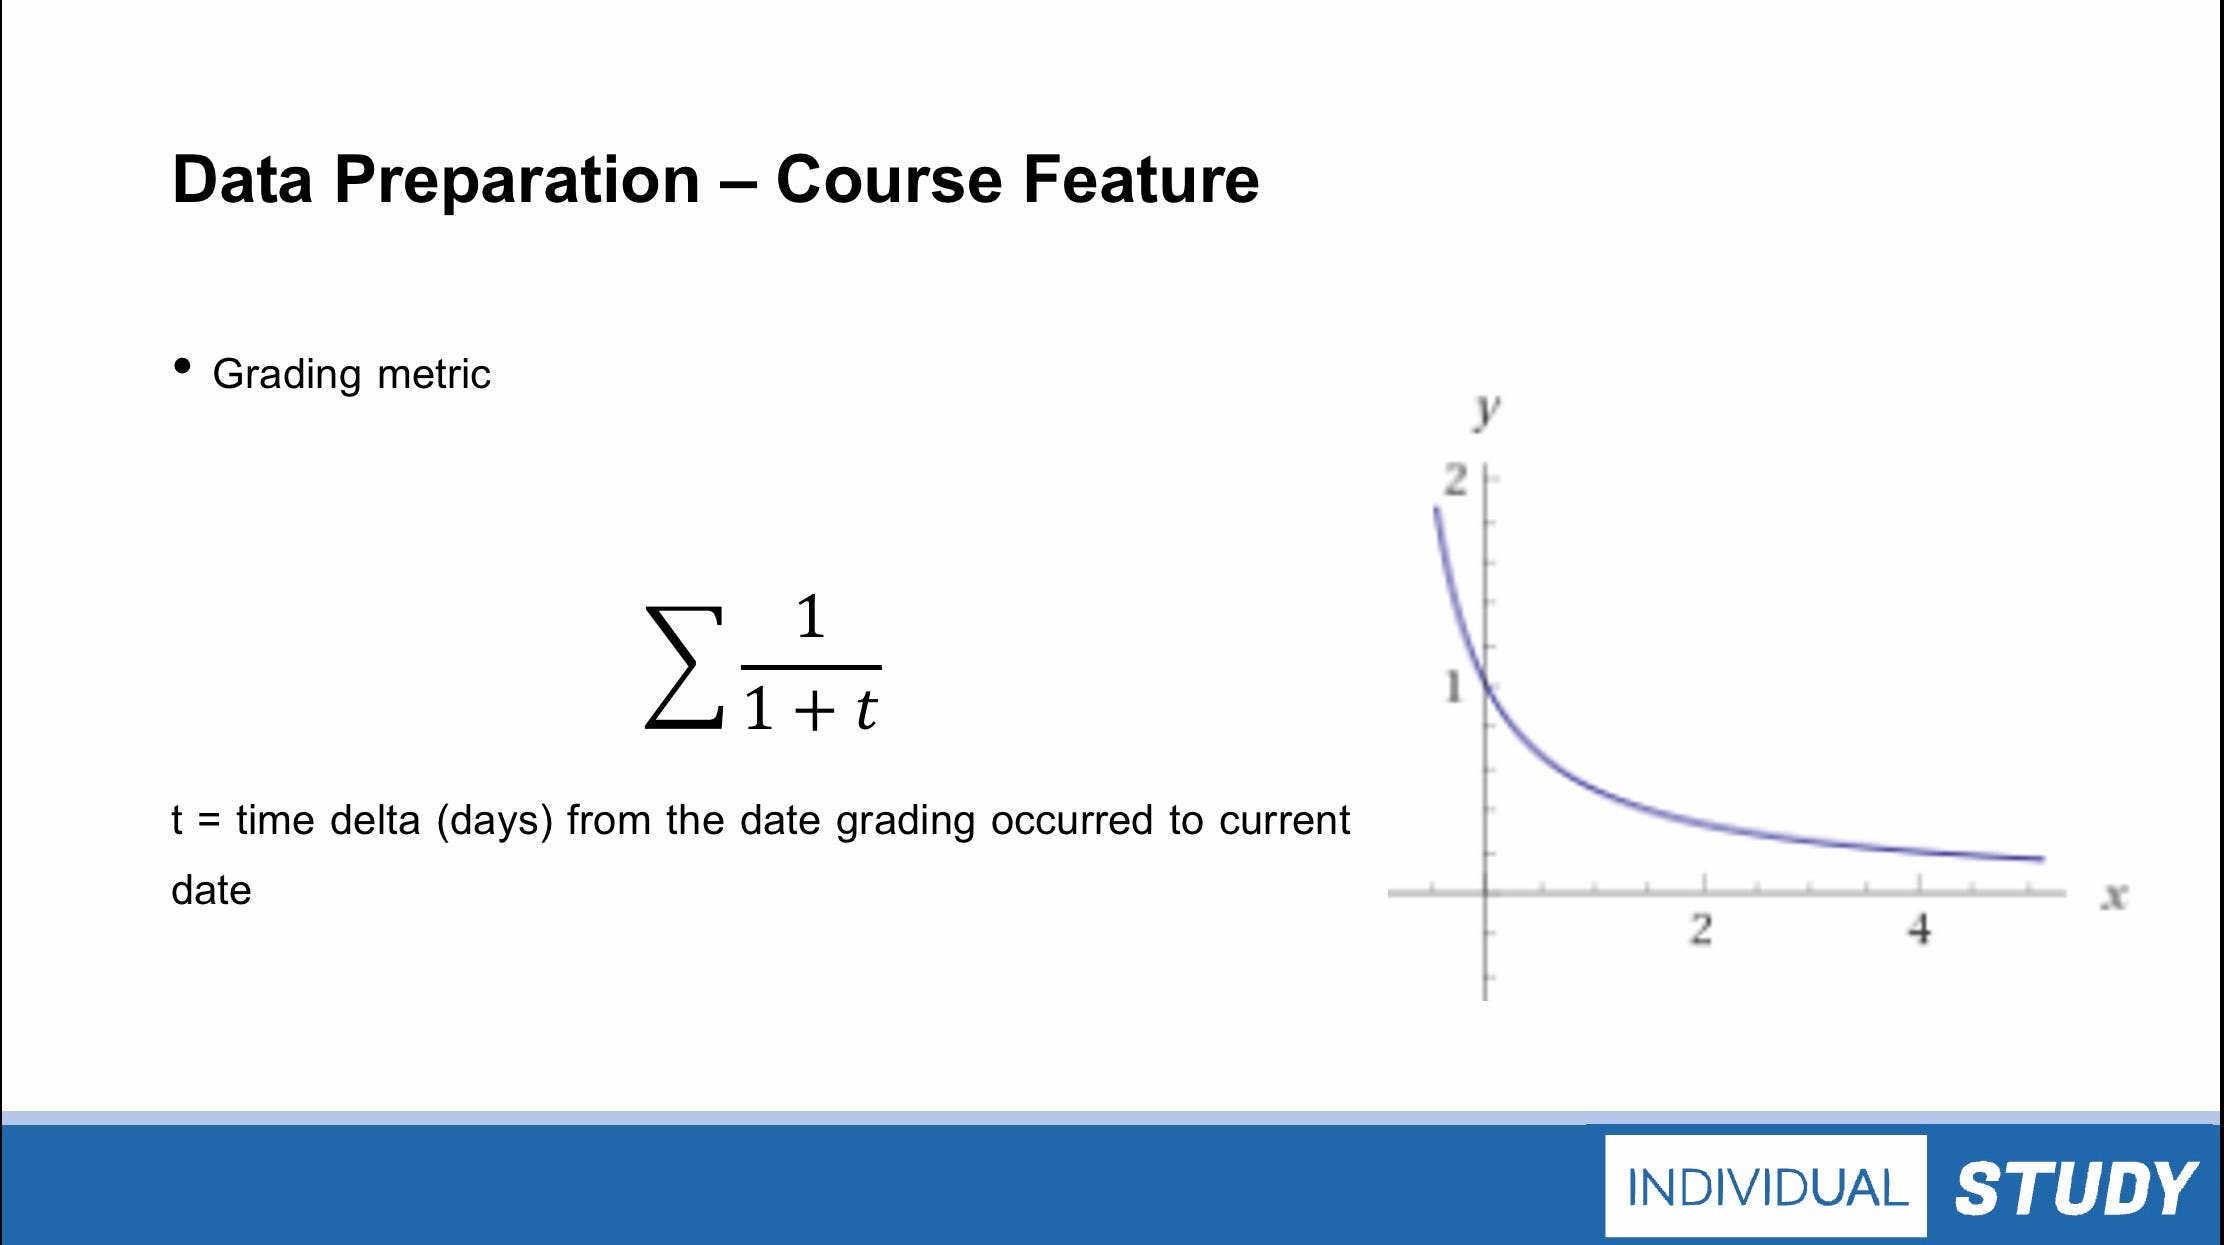
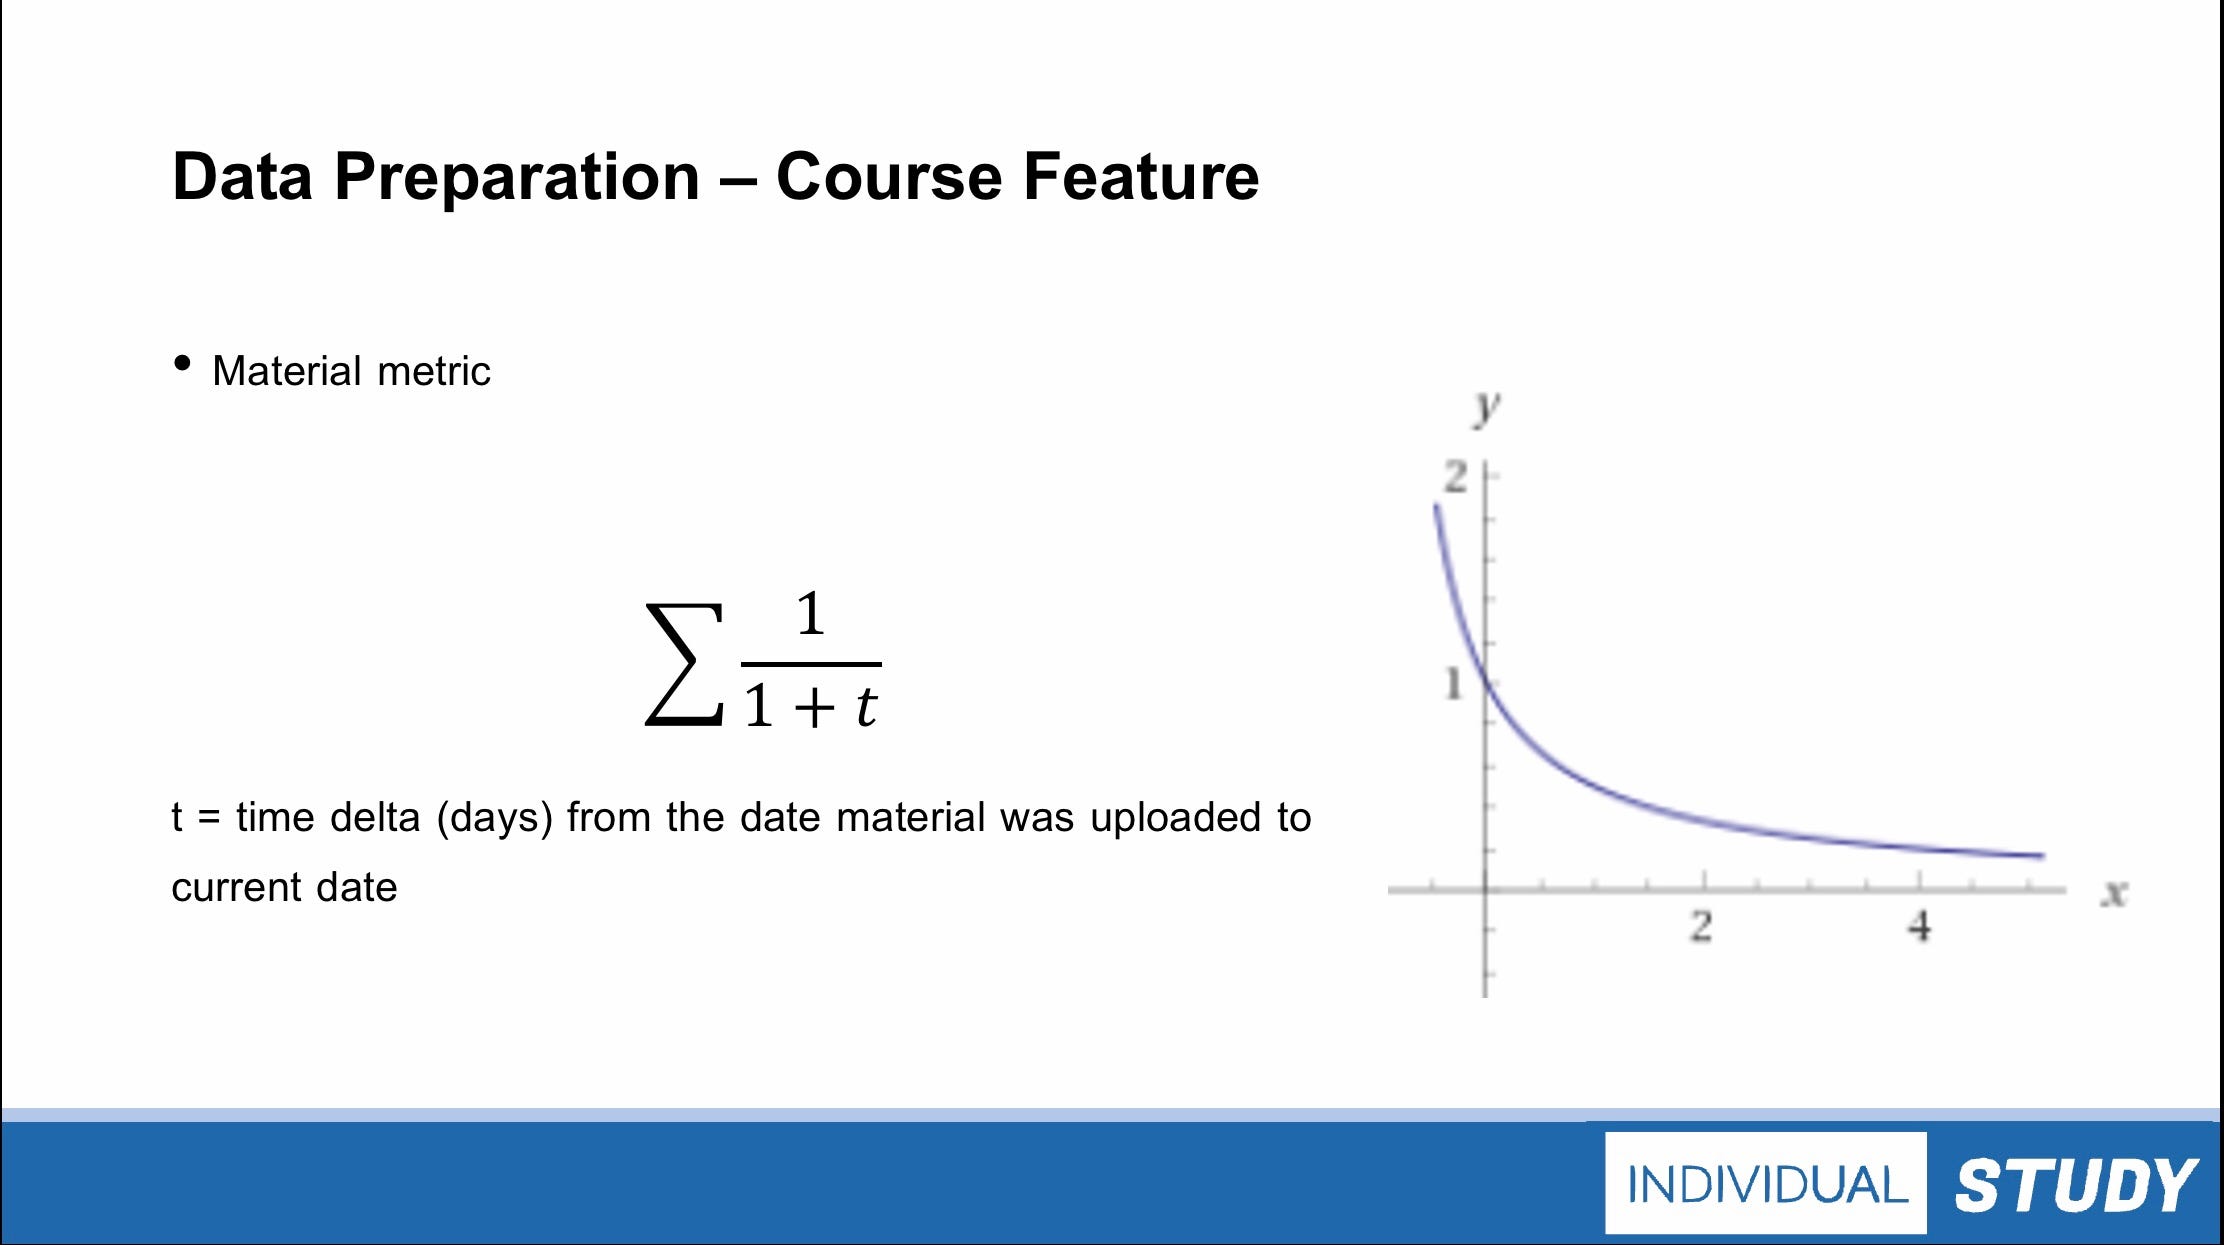
Последними двумя функциями были сеанс курса, курсыпоследнее посещение пользователя и сеанс активности, действия, которые пользователь выполнял на этих курсах. Оба сеанса были встроены, чтобы быть действительными входными данными для модели.
Модель
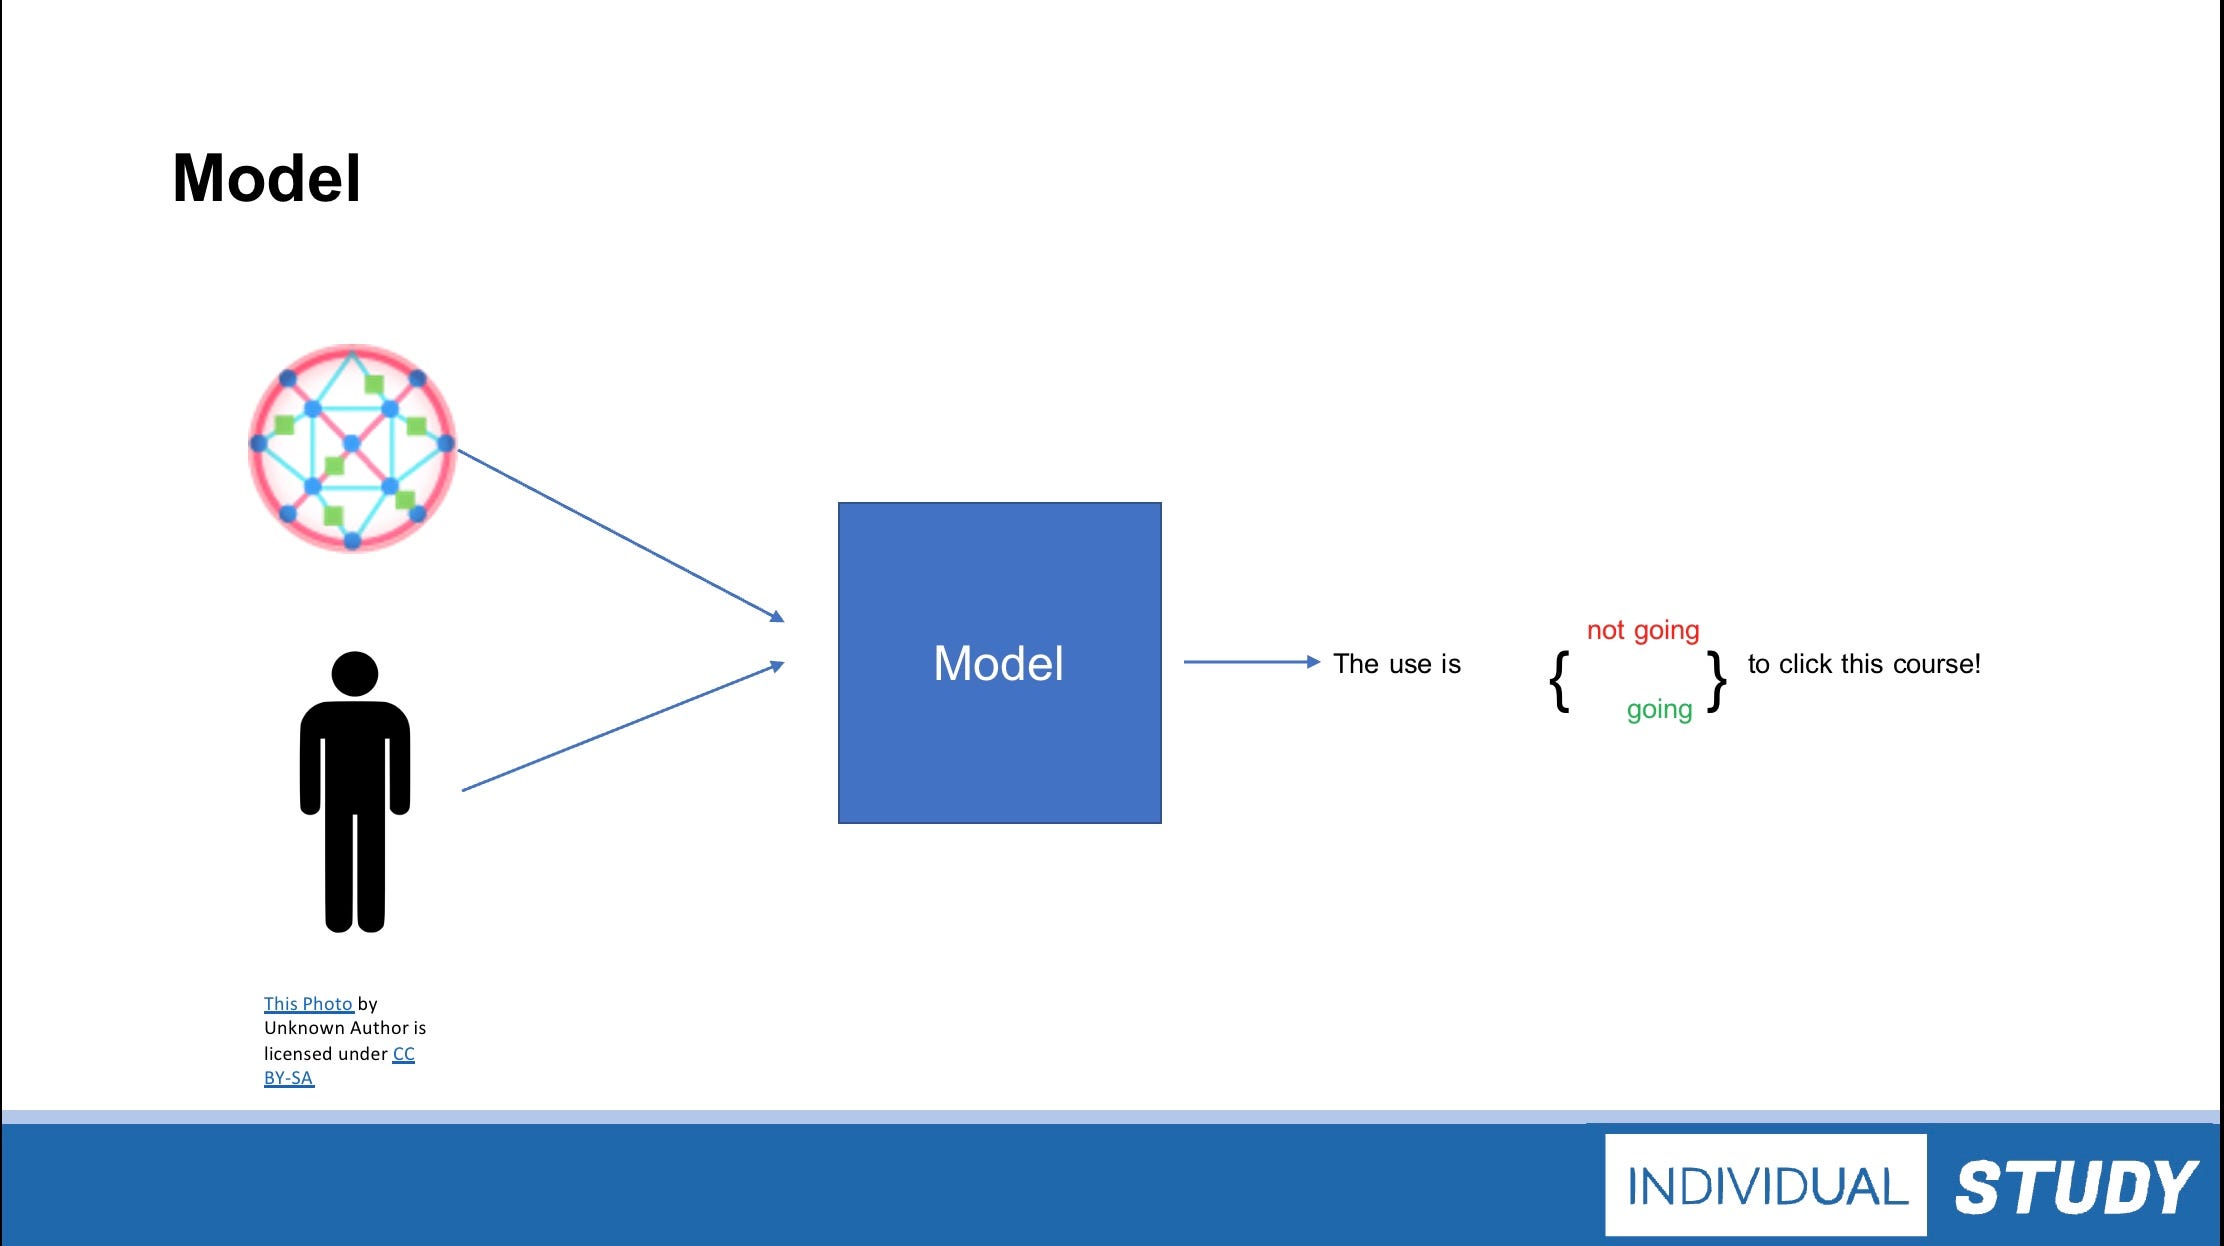
Это упрощенная диаграмма, которая описывает, как работает модель. В модель вводятся характеристики курса (матрицы оценок и материалов) и пользователя (курсы и занятия). Затем модель предсказывает, собирается ли пользователь войти в курс или нет. Курсы-кандидаты — это курсы, на которые записался пользователь.
Функция обработки
Обработка признаков была первой помехой этого проекта, потому что на извлечение всего этого ушло ВРЕМЯ ЖИЗНИ! Необработанные входные данные, которые представляли собой журналы активности пользователей, использующих myCourseville в 2017 году, передали 20 МИЛЛИОНОВ набора данных после их извлечения в функции, упомянутые выше.
Отсюда вопрос: Как я могу ускорить этот процесс? Как и многие другие, самое первое, что пришло в голову, это параллельная обработка! Для этого использовалась библиотека concurrent.futures.
С Intel Core i5–8265U @ 1,60 ГГц для завершения всех процессов потребовалось 15 часов и 4 минуты.
Данные были разделены на 14 миллионов наборов данных для обучения и 6 миллионов наборов данных для тестирования.
Модель 1 — простая плотная модель
Когда все готово, пришло время обучить модель. Первая модель была простой плотной моделью (и спойлер: все последующие модели были простыми плотными моделями с некоторыми корректировками).
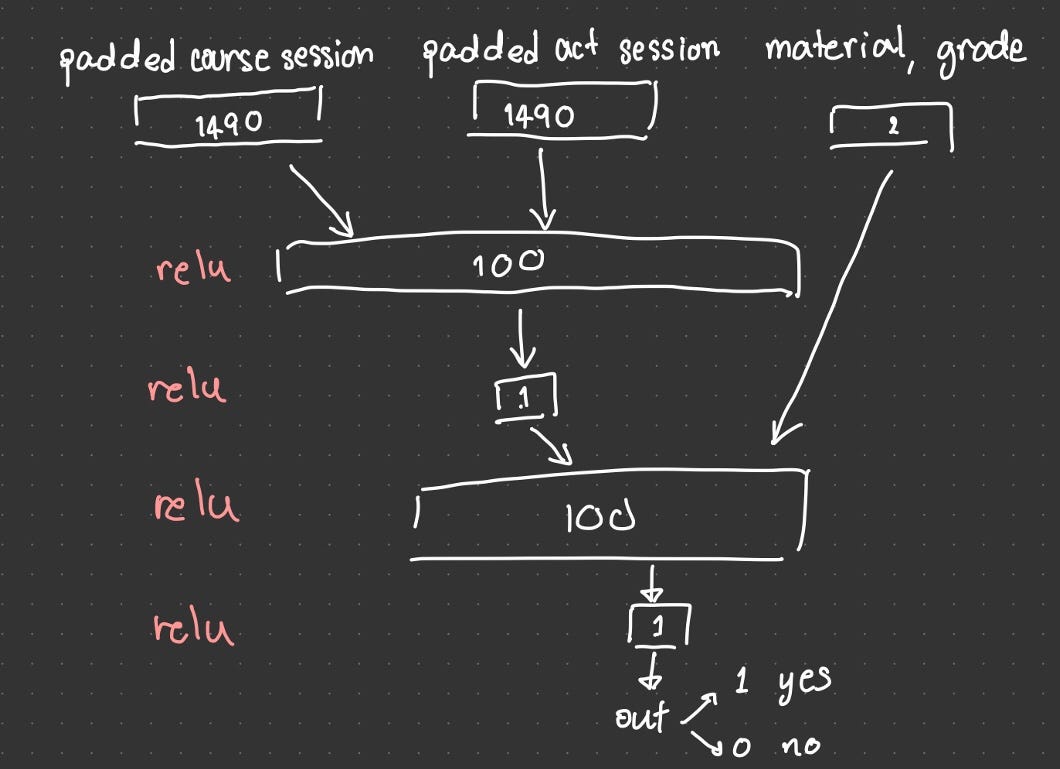
На этом рисунке показана структура модели 1. Как видно, сеансы курса и активности были дополнены до одинаковой длины 1490, что было самым длинным сеансом, обнаруженным в журналах активности за 2017 год.
К сожалению, при ограниченных ресурсах для обучения использовалось 50 000 наборов данных, а еще 50 000 данных использовались в качестве проверочного набора (оба взяты из набора обучающих данных).
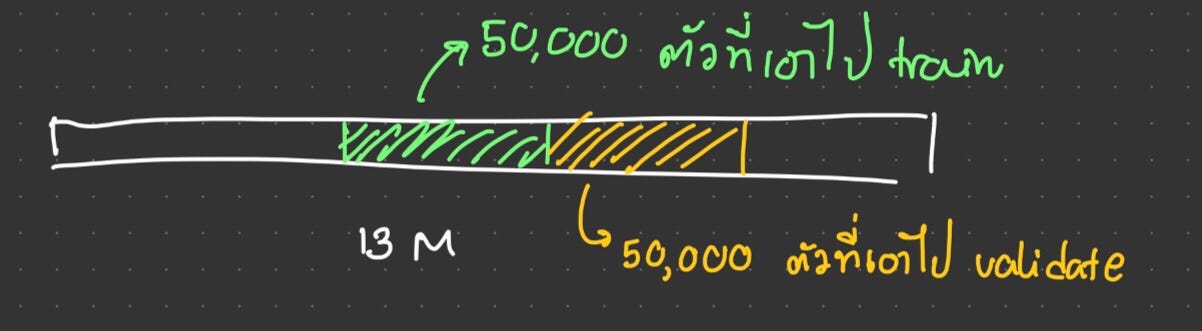
Зеленая фракция использовалась в качестве поезда, а желтая - в качестве подтверждения. Обратите внимание, что была выбрана последовательность данных, что было плохой идеей, потому что метка 0 будет намного больше, чем 1, а данные не были выбраны редко, что означало, что модель не могла полностью понять шаблон.
Неудивительно, что макро-оценка F1 составила 0,15, а все прогнозируемые данные были нулевыми.
Модель 2 — поиск по сетке
После первой модели функция активации последнего слоя была изменена с relu на сигмовидную, потому что требовался вывод в виде от нуля до единицы. Поиск по сетке проводился по таким гиперпараметрам, как скорость обучения, эпохи и т. д. Лучшие параметры дали макро-оценку F1 0,458 с 55 предсказанными на 50 000 проверочных данных.
Предвзятые данные
Как упоминалось ранее, данные обучения и проверки были довольно предвзятыми, поскольку они не были отобраны наугад, а обучение более 10 миллионов данных требовало ресурсов и времени. Таким образом, метод отбора был придуман. Кроме того, в процессе извлечения признаков, учитывая набор курсов одного пользователя (скажем, 10 курсов), если в журналах действий указано, что курс A был выбран, A будет помечен как 1, а девять других курсов будут помечены как 0.
Поскольку нулей гораздо больше, чем единиц, сначала были выбраны все единицы. Затем случайным образом выбирались нули в том же количестве, что и нули со случайным начальным набором для воспроизводимости. Затем данные были упорядочены по отметке времени активности. Это гарантировало, что они будут заказаны так же, как и до того, как они были выбраны.
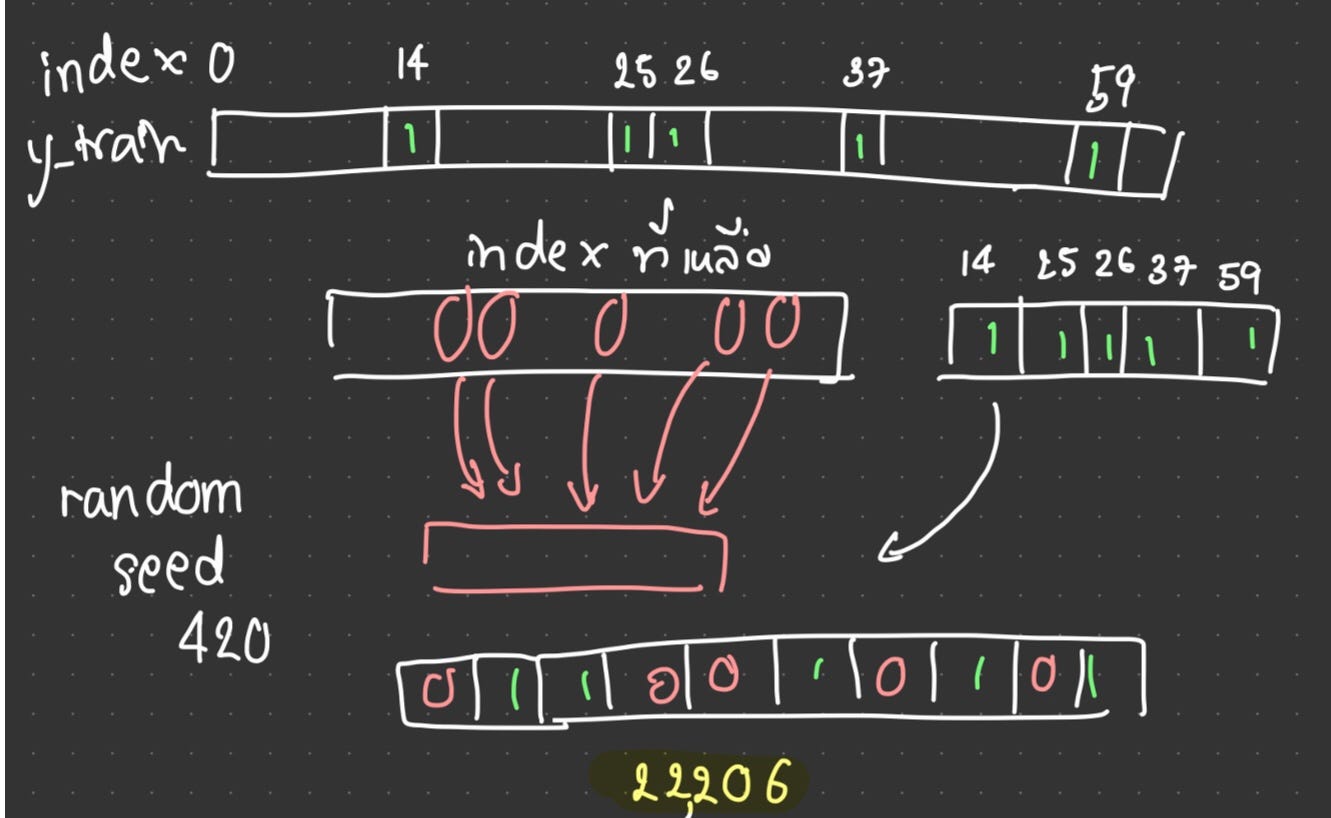
Осталось всего 22 206 данных. Следовательно, данные были разделены на обучение и проверку в соотношении 70:30. В это время можно было использовать все 22 206 данных.
Модель 3 — Большая плотная модель
Со стороны модели плотность увеличилась со 100 до 300.
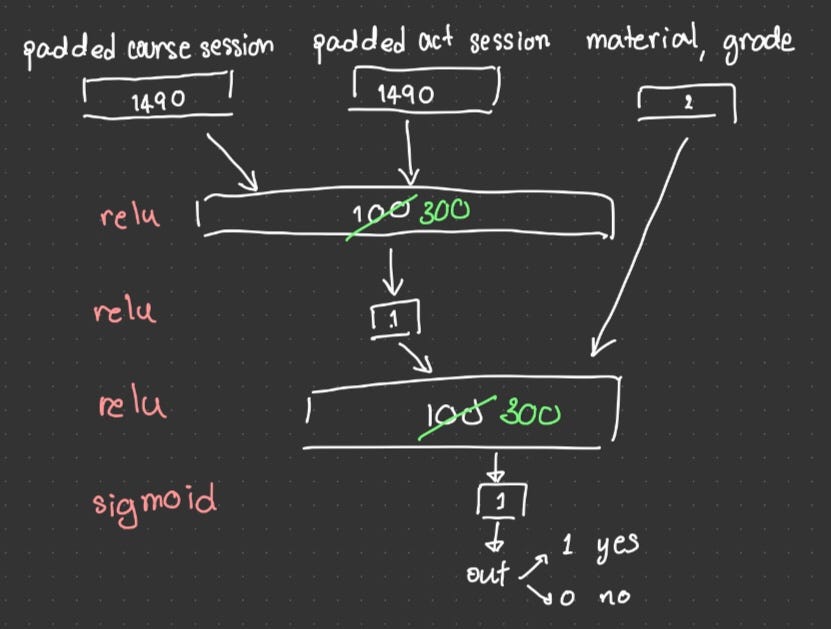
Эта модель дала макро-оценку F1 при проверке 0,53, что казалось многообещающим. Однако тестовые данные не прошли через метод отбора и не должны были проходить, поскольку в настоящее время модель не должна быть предвзятой и уже может видеть некоторую закономерность. К сожалению, для тестовых данных требовалось более 70 ГБ памяти из-за колоссального объема данных и заполнения, из-за чего каждому сеансу курса и сеансу активности приходилось 35 ГБ.
Чтобы предсказать все эти данные, тесты были разбиты на небольшие фрагменты одинакового размера и предсказаны параллельно. С небольшой помощью шаблона разработки адаптера , несоответствие ввода фрагмента и порядкового номера (для сортировки позже) можно было легко обработать.
В результате макро-балл F1 на тестовых данных составил 0,493. Модель выдала 1,36 миллиона единиц, в то время как тестовые данные на самом деле содержат 1,27 миллиона единиц.
Как насчет базовой линии?
Модель «Самая частая» будет предсказывать 1, если курс окажется в тройке самых частых курсов, которые посещает пользователь. Это дало макросу F1 оценку 0,3. Ура!
Эпилог
На самом деле это был мой четвертый индивидуальный учебный проект (или может быть 3,5?). Так что вся моя благодарность этим людям :)
Доц. Проф. Ативонг Сучато, доктор философии
Ассистент. Проф. Проадпран Пуньябуккана, доктор философии
Равит Пичаявет
и мой друг, который вместе участвовал в 2,5 проектах: Навабхорн Панди.
