Несколько полезных библиотек, которые призваны упростить процесс анализа данных для начинающих.
Область машинного обучения развивается семимильными шагами. Не менее быстрыми темпами в арсенал Data Science добавляются новые библиотеки. Сегодня одну задачу можно выполнить с помощью нескольких библиотек и более чем одним способом. Среди всего этого множества новых библиотек некоторые выделяются своей простотой использования и готовыми реализациями. В этой статье я расскажу о пяти таких библиотеках, которые могут ускорить процесс традиционного машинного обучения, тем самым снизив входной барьер.
Вот ссылка на код, по которой можно следовать.
1. Dabl (Базовая библиотека анализа данных)
Библиотека Dabl была создана Андреасом Мюллером, одним из основных разработчиков и сопровождающих библиотеки машинного обучения scikit-learn. Идея dabl состоит в том, чтобы сделать контролируемое машинное обучение более доступным для новичков и уменьшить количество шаблонов для общих задач. Дабл черпает вдохновение в scikit-learn и auto-sklearn. Библиотека активно развивается и поэтому не рекомендуется для промышленного использования. Обратитесь к официальному сайту для получения дополнительной информации и примеров.
Установка
# Installing the library
!pip install dabl
использование
Dabl можно использовать для автоматической предварительной обработки набора данных, быстрого EDA, а также для первоначального построения модели в рамках типичного конвейера машинного обучения. Давайте продемонстрируем некоторые варианты использования этой библиотеки с помощью titanic dataset. Мы начнем с импорта как библиотеки, так и набора данных.
#import the basiclibraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
#importing dabl
import dabl
#import the dataset
titanic_df = pd.read_csv('../input/titanic/train.csv')
titanic.info()

- Определение типов функций
В рамках предварительной обработки dabl пытается идентифицировать отсутствующие значения, типы функций и ошибочные данные. Если обнаружение семантических типов (непрерывный, категориальный, порядковый, текст и т. Д.) Не удается, пользователь также может предоставить type_hints .
titanic_df_clean = dabl.clean(titanic_df, verbose=1)

2. Исследовательский анализ данных с dabl
dabl предоставляет высокоуровневый интерфейс, который суммирует несколько общих высокоуровневых графиков. Все функции показаны для низкоразмерных наборов данных; для крупномерных наборов данных отображаются только наиболее информативные функции данной задачи. Давайте посмотрим на процесс в действии.
dabl.plot(titanic_df, target_col="Survived")
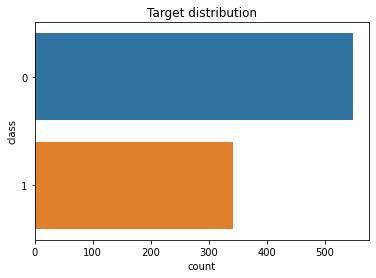


Все вышеперечисленные графики были созданы с помощью одной строчки кода.
3. Первоначальное построение модели с помощью dabl
dabl также может быстро найти базовую модель для наших данных. SimpleClassifier реализует стандартный scikit-learn API подгонки и прогнозирования.
ec = dabl.SimpleClassifier(random_state=0).fit(titanic_df, target_col="Survived")

2. Эмот
Emot - это пакет обнаружения эмодзи и смайликов для Python. Это может пригодиться, когда нам нужно предварительно обработать текстовые данные, чтобы удалить смайлики и эмодзи. Библиотека принимает строку в качестве входных данных и возвращает список словарей.
Установка
# installation and importing the library
!pip install emot
использование
Давайте посмотрим на несколько строк, содержащих смайлики и смайлики. Мы будем использовать Emot, чтобы преобразовать эти смайлы в текст.
import emot
text = "The weather is ☁️, we might need to carry our ☂️ :
# Detecting emojis
("emot.emoji(text)

# Detecting emoticons
emot.emoticons(text)

3. Flashtext
Flastext - это пакет Python, который позволяет извлекать ключевые слова из предложения или заменять ключевые слова в предложениях. Он основан на алгоритме FlashText и значительно быстрее регулярных выражений для задач НЛП.
Установка
# installation and importing the library
!pip install flashtext -q
использование
Набор данных взят из предыдущего конкурса Kaggle: Реально или нет? НЛП с твитами-катастрофами , цель которого заключалась в создании модели машинного обучения, чтобы предсказать, относятся ли твиты к категории бедствий. Это был удачный пример проблемы двоичной классификации. Давайте импортируем библиотеку и набор данных и быстро посмотрим на данные.
from flashtext import KeywordProcessor
twitter_df =  pd.read_csv('data/tweets.csv')
twitter_df.head()

Создадим корпус всех твитов в обучающей выборке.
corpus = ', '.join(twitter_df.text)
corpus[:1000]

- Извлечение ключевых слов / поиск слов в корпусе
Давайте посчитаем, сколько раз слово "наводнение" встречается в корпусе?
processor = KeywordProcessor()
processor.add_keyword(‘flood’)
found = processor.extract_keywords(corpus)
print(len(found))
58
Слово flood появляется 58 раза в приведенном выше корпусе.
2. Замена слов в текстовом документе
Мы также можем легко заменить слова в документе. Давайте воспользуемся библиотекой для замены всех вхождений слова. ‘_4 _’ (без учета регистра) с ‘fire'.
processor = KeywordProcessor(case_sensitive = False)
processor.add_keyword('forest fire','fire')
found = processor.replace_keywords(corpus)
print(found[:100])

Слово Forest Fire заменяется только словом огонь. Точно так же мы могли бы заменить в документе специальные символы, гиперссылки и т. Д.
4. SweetViz
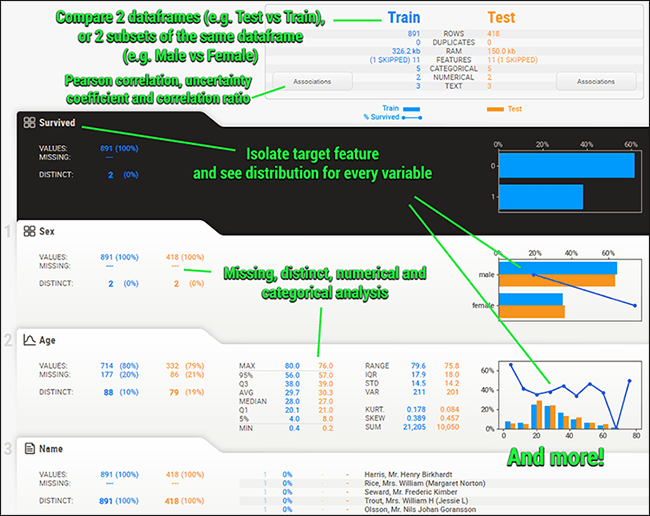
Sweetviz - это библиотека Python с открытым исходным кодом, которая генерирует красивые визуализации высокой плотности для запуска EDA (исследовательского анализа данных) с помощью одной строки кода. Результатом является полностью автономное HTML-приложение.
Библиотека может выполнять быстрый анализ следующих задач:
- Целевой анализ
- Визуализируйте и сравните
- Смешанные ассоциации
- Вывод типа: автоматически определяет числовые, категориальные и текстовые функции, с дополнительными ручными переопределениями и многим другим.
Давайте посмотрим на демо через Titanic Dataset
Установка
# Installing the library
!pip install sweetviz
использование
В Sweetviz есть функция Analyze (), которая анализирует весь набор данных и предоставляет подробный отчет с визуализацией.
# importing sweetviz
import sweetviz as sv
#analyzing the dataset
advert_report = sv.analyze(titanic_df)
#display the report
advert_report.show_html('titanic.html')
5. Нумеризатор
Numerizer - это модуль Python для преобразования чисел естественного языка в целые и плавающие числа. Это порт Ruby gem numerizer. Это может быть полезно при предварительной обработке текстовых данных.
Установка
!pip install numerizer
использование
Мы увидим, как быстро числитель преобразует текстовые числа в числа.

Заключение
Это были некоторые из интересных и полезных библиотек Python для науки о данных, с которыми я недавно столкнулся. Эти библиотеки заменяют существующие, но могут быть использованы для их дополнения. Конечная цель - улучшить и оптимизировать процесс машинного обучения и снизить планку для новичков. Если вы знаете о других, которых можно добавить в список, упомяните их в комментариях ниже.
