Сравнение баз данных Neo4j и графов с реляционными базами данных
Фон
В то время как эволюция технологии баз данных за последние два десятилетия определялась спорами о сравнении NoSQL и реляционных технологий, существует негласная сила, которая неуклонно набирает обороты в течение того же периода времени. Это собственная база данных графов. Популяризованная Neo4j [1], собственная графовая база данных теперь широко применяется во многих отраслях и используется во многих реальных случаях использования.
В этой статье я хочу поговорить об уровне хранения в собственных графовых базах данных, потому что на нем на удивление гораздо меньше онлайн-ресурсов по сравнению с NoSQL или реляционными базами данных. Самый полезный материал, который вы найдете, - это, вероятно, книга разработчиков Neo4j [2], в которой многие важные детали замалчиваются. Только когда я прочитал исходный код, я наконец понял все до байтового уровня.
Я также должен упомянуть, что теоретически базы данных на основе собственных графов должны иметь множество форм. Пока узлы графа и их соединения являются первоклассными примитивами в структуре хранилища, это считается нативным для графа. Но пока что дизайн Neo4j кажется наиболее проверенным подходом. Так что я остановлюсь на этом как на каноническом примере собственного хранилища графов и баз данных.
Графики в модели реляционного хранилища
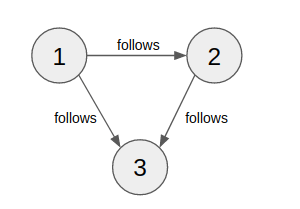
Прежде всего, давайте посмотрим, как можно смоделировать граф в мире реляционных баз данных. Рассмотрим очень простой график, показанный на рисунке 1. Представьте, что он представляет отношения пользователей Twitter. Узел 1 следует за узлами 2 и 3. Узел 2 следует за узлом 3.
В реляционной модели у вас будет таблица с профилями пользователей и, возможно, таблица с действиями пользователей, например, когда они начали подписываться друг на друга. Но что наиболее важно в контексте графика, вам нужна таблица отношений, в которой хранятся связи между пользователями.
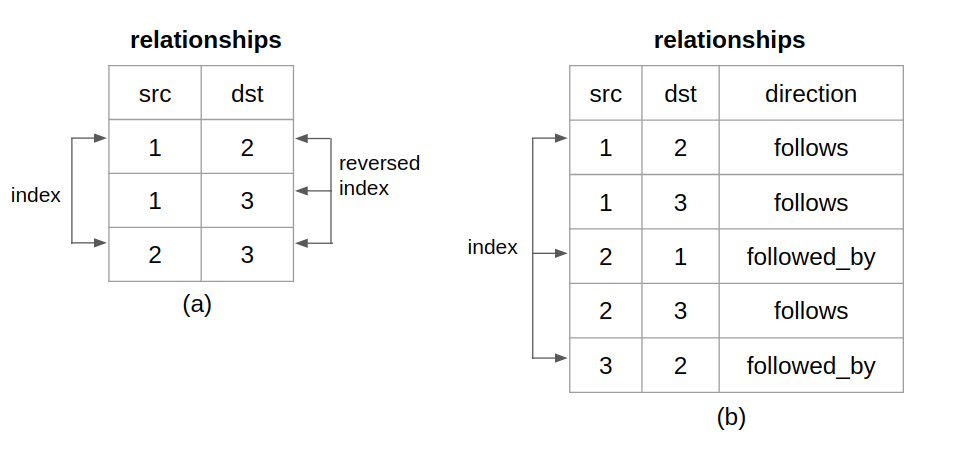
Обычно это можно сделать двумя способами. Вы можете сделать это, как показано на рисунке 2 (a): сохранить источник и назначение ребра (отношения) в виде строки и сделать это для всех ребер. Когда вам нужно найти исходящие границы (за которыми следует конкретный пользователь), вы можете использовать индекс для «поиска» начала исходящих отношений этого пользователя.
Кроме того, обычно вам также нужно искать входящие ребра (которые следят за конкретным пользователем), поэтому вам понадобится обратный индекс для сканирования входящих отношений всех пользователей. Оба индекса требуют O(log(n)) временной сложности при поиске.
Обратный индекс хуже, потому что у вас не может быть разреженного индекса, который просто указывает на начало входящих отношений пользователя. Входящие отношения не упорядочены - представьте, что у вас есть строка <2,1> в таблице. Таким образом, ваш обратный индекс должен полностью указывать до конечного уровня.
Вы можете сделать это, как показано на Рисунке 2 (b). В этом случае вы должны сохранить край дважды и иметь дополнительный столбец для указания направления. Вы можете избавиться от обратного индекса, но прямой индекс по-прежнему необходим - и у вас будет больше проблем с согласованностью данных (симметричные повторяющиеся края), о которых нужно беспокоиться на уровне приложения.
В общем, наличие индекса не только замедляет запись, но и увеличивает размер данных. И, в конце концов, он предлагает только O(log(n)) эффективность.
Собственная модель хранения графиков
Давайте посмотрим, как модель собственного графа решает эти проблемы. Собственную модель хранения графов можно резюмировать на рисунке 3, который основан на графике на рисунке 1. Позвольте мне провести вас через него.
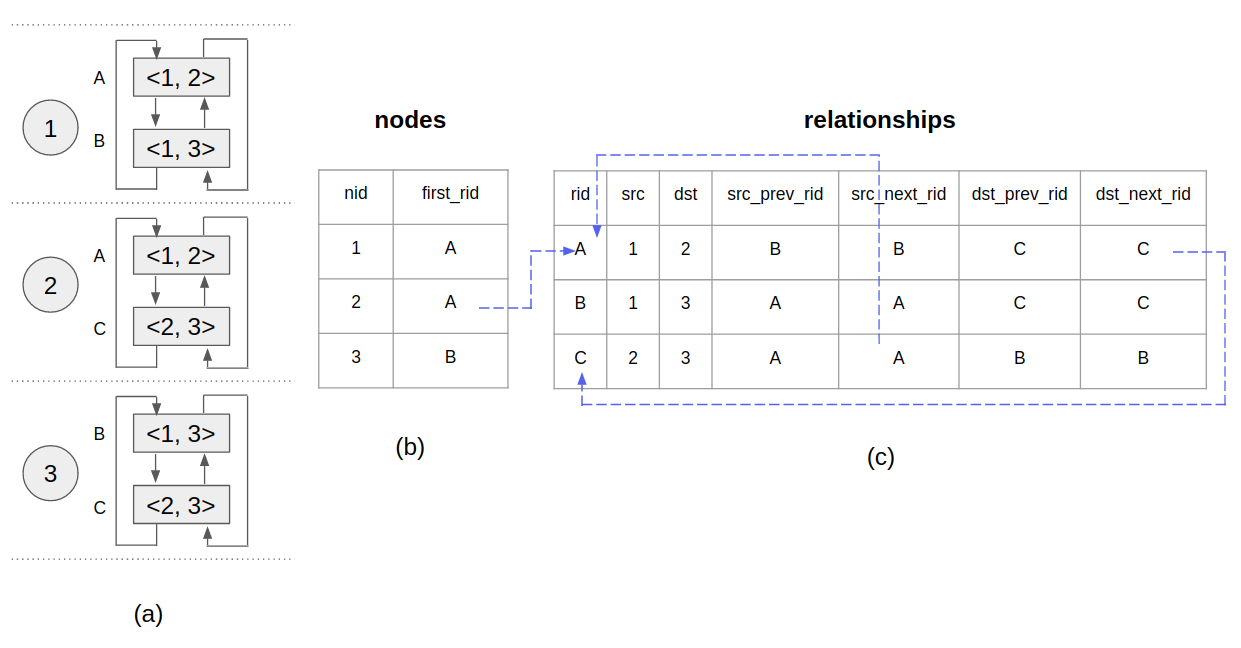
Рисунок 3 (а) представляет собой концептуальную модель. Он перечисляет все ребра, связанные с каждым узлом, и организует их как двусвязные списки. Обратите внимание, что ребро связано с узлом, если узел является либо источником, либо местом назначения этого ребра. Например, край A <1,2> связан как с узлом 1, так и с узлом 2.
На рисунке 3 (b) показано фактическое хранилище узлов. Каждая запись хранит идентификатор первого отношения (first_rid) узла. Например, первое отношение для обоих узлов 1 и 2 - A.
Рисунок 3 (c) - это фактическое хранилище отношений. Каждая запись хранит источник (src) и место назначения (dst) отношения. Кроме того, он также хранит идентификаторы предыдущего и следующего отношения как для исходного, так и для целевого узлов (src_prev_rid, src_next_rid, dst_prev_rid, dst_next_rid). По сути, это сохраняет концептуальные двусвязные списки как для источника, так и для пункта назначения, но сохраняет заданное ребро только один раз.
Допустим, вы хотите получить все исходящие отношения узла 2. См. Синие стрелки на Рисунке 3 в качестве иллюстрации. Сначала вы переходите в хранилище узлов и видите, что first_rid узла 2 равно A. Затем вы переходите в хранилище отношений, чтобы найти A. A не является исходящей связью для 2, потому что 2 dst для A. Но это нормально. Вы следуете за dst_next_rid в A (потому что 2 - это пункт назначения в отношениях A). Это указывает на C. C - это исходящая связь для 2 (2 - источник в C). Вы продолжаете идти к src_next_rid, который возвращается к A. Тогда вы знаете, что исчерпали все связи узла 2.
Теперь предположим, что вы хотите добавить новый узел 4 и заставить 2 следовать за 4. См. Рисунок 4 для обзора изменений. Опять же, давайте пройдемся через это.

Рисунок 4 (а) иллюстрирует конечный результат, которого вы хотите достичь. На рисунке 4 (b) показана обновленная концептуальная модель.
В хранилище узлов добавляется новая запись для хранения first_rid узла 4, который равен D [рисунок 4 (c)]. В хранилище отношений вставляется новая запись D [рисунок 4 (d)]. Его src и dst равны 2 и 4 соответственно.
Его dst_prev_rid и dst_next_rid тривиальны, потому что его dst узел 4 имеет только одно отношение, а именно D. Немного сложнее всего обновить двусвязный список отношений для узла 2. Я выделил их красным. Должно быть довольно просто увидеть, как красная часть узла 2 на рисунке 4 (b) отражается на рисунке 4 (d).
В этом суть собственной модели хранения графов. Я намеренно опустил части меток и свойств узлов / отношений и коснулся только структуры графа. Но их можно легко построить как поисковое хранилище, учитывая идентификаторы узла / отношения.
Есть и другие практические соображения. Например, все отношения конкретного узла находятся в одном двусвязном списке. Вы можете расположить входящие в начале списка и исходящие в конце списка, чтобы облегчить быстрое сканирование направленных отношений.
Другой пример - определить, существует ли связь между двумя узлами. Вы можете перебирать исходящие или входящие ограничения источника. Однако один из этих двух узлов может иметь широкие связи (например, пользователи-знаменитости в Twitter). Возможно, имеет смысл записать бит плотности в хранилище узлов, чтобы сигнализировать об этом, что дает вам указание перебрать отношения между другими узлами.
Физическое хранилище Native-Graph
В приведенных выше примерах у меня могло сложиться впечатление, что узлы и отношения хранятся в виде реляционных таблиц. Они не. Это еще одно важное нововведение в собственном хранилище графов для баз данных.
Вы, наверное, заметили, что записи узлов и отношений имеют фиксированный размер - они просто содержат идентификаторы фиксированного размера. Таким образом, хитрость заключается в том, чтобы последовательно хранить одни и те же записи в непрерывном большом двоичном объекте хранилища - например, в файле (или в наборе файлов).
Затем для любого заданного идентификатора вы можете напрямую обратиться к ID * record_size в непрерывном большом двоичном объекте, чтобы прочитать / записать запись. Это то, что позволяет искать O(1). Бит in_use может быть введен для каждого слота записи в непрерывном большом двоичном объекте хранилища, чтобы пространство можно было предварительно выделить и освободить при стирании записи.
Я написал небольшую демонстрационную программу Golang на GitHub [3], чтобы проиллюстрировать всю идею. Программа использует mmap для получения большого двоичного объекта хранилища, который отражает файлы узлов и взаимосвязей, соответственно, и для чтения / записи записей узлов / взаимосвязей в эти области памяти.
mmap - полезный инструмент, поскольку он позволяет избежать двойного копирования с диска в ОС и из ОС в приложение. Чтение и запись намного быстрее и проще. Не стесняйтесь проверять репо и обязательно сообщать о проблемах, если обнаружите ошибки.
Несколько слов о структуре хранилища Neo4j
Запись узла Neo4j содержит информацию in_use, first_rid, идентификатор первого свойства, идентификатор первой метки и некоторые дополнительные биты (например, информацию о плотности, о которой мы говорили). Идентификатор свойства и идентификатор метки указывают на свойства и метки узла. Запись отношения Neo4j содержит информацию in_use; src; dst; предыдущие и следующие ссылки src и dst соответственно; идентификатор первого типа; идентификатор первой собственности; и некоторые дополнительные биты. Идентификатор типа и идентификатор свойства указывают на типы и свойства отношения.
Запись узла в стандартном формате Neo4j составляет 15 байтов. В Интернете бытует распространенное заблуждение, что запись узла использует один байт для in_use, по четыре байта для first_rid и первого идентификатора свойства, пять байтов для идентификатора первой метки и один байт для дополнительного.
В этом макете и отношения, и свойства будут иметь предел 2 ². Это не согласуется с тем фактом, что ограничения составляют 2³⁵ для отношений и 2³⁶ для свойств в стандартном формате Neo4j [4].
Разница в том, что не весь первый байт используется для in_use. Только последний бит первого байта предназначен для in_use. Первые три бита фактически используются для старших битов first_rid, а следующие четыре бита используются для старших битов первого идентификатора свойства. Математика подтверждает это следующим образом: 3 + 32 = 35, 4 + 32 = 36. Вам нужно будет прочитать исходный код, чтобы обнаружить это [5].
Запись отношения в стандартном формате Neo4j составляет 34 байта. Подобный метод используется для максимизации полезности каждого бита.
Ссылки
[1] Графическая платформа Neo4j
[2] Ян Робинсон и др., 2015, «Графические базы данных», 2-е издание.
[4] Документы Neo4j
[5] Neo4j на GitHub
