Взгляд на использование нескольких баз данных Neo4j 4.0 с neo4j-graphql.js
Neo4j 4.0 представляет поддержку нескольких активных баз данных, что позволяет использовать такие варианты использования, как мультиарендность, когда у нас есть одна база данных на каждого арендатора, гарантируя, что данные каждого арендатора хранятся отдельно.
В этом посте мы рассмотрим использование нескольких баз данных в Neo4j 4.0, а затем покажем, как использовать несколько активных баз данных с интеграцией Neo4j GraphQL neo4j-graphql.js, создавая мультитенантный GraphQL API.
Создание нескольких активных баз данных
Есть несколько подходов к мультиарендности и разные способы использования нескольких баз данных в Neo4j. В этом примере мы будем работать с данными о компаниях и отзывами пользователей. Мы определим «арендатора» на основе города, в котором расположен бизнес, сохраняя информацию о компаниях в разных городах в разных базах данных.
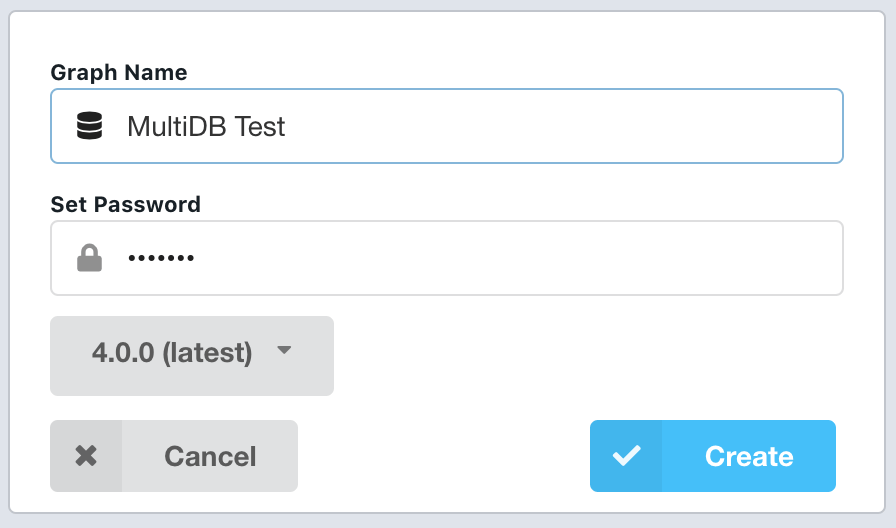
Сначала мы создадим новый график Neo4j 4.0 в Neo4j Desktop. Поддержка нескольких активных баз данных появилась в Neo4j 4.0 впервые, поэтому убедитесь, что у вас последняя версия, чтобы попробовать ее.
При первом запуске Neo4j создаются две базы данных: system и neo4j. Системная база данных содержит метаданные о системе управления базами данных, и мы используем их для выполнения административных функций, таких как создание новых баз данных, пользователей и конфигурации безопасности. Когда мы открываем браузер Neo4j в первый раз, по умолчанию мы подключаемся к базе данных neo4j. Команда :use позволяет переключаться между базами данных.
Давайте подключимся к базе данных system и создадим две новые базы данных, одну с именем sanmateo, а другую с именем missoula. Сначала переключаемся на базу данных system:
:use system
Затем выполните две CREATE DATABASE команды:
CREATE DATABASE sanmateo;CREATE DATABASE missoula;
Мы можем проверить, созданы ли наши новые базы данных, запустив SHOW DATABASES для системной базы данных:

Мы видим новые созданные нами базы данных, а также базы данных system и neo4j. Кроме того, мы видим, что neo4j - это база данных по умолчанию. Удалим neo4j базу данных:
DROP DATABASE neo4j;
А теперь давайте установим sanmateo в качестве нашей базы данных по умолчанию, установив dbms.default_database=sanmateo в neo4j.conf файле конфигурации. Мы можем проверить наши изменения, снова запустив SHOW DATABASES:

Загрузка данных наших бизнес-обзоров
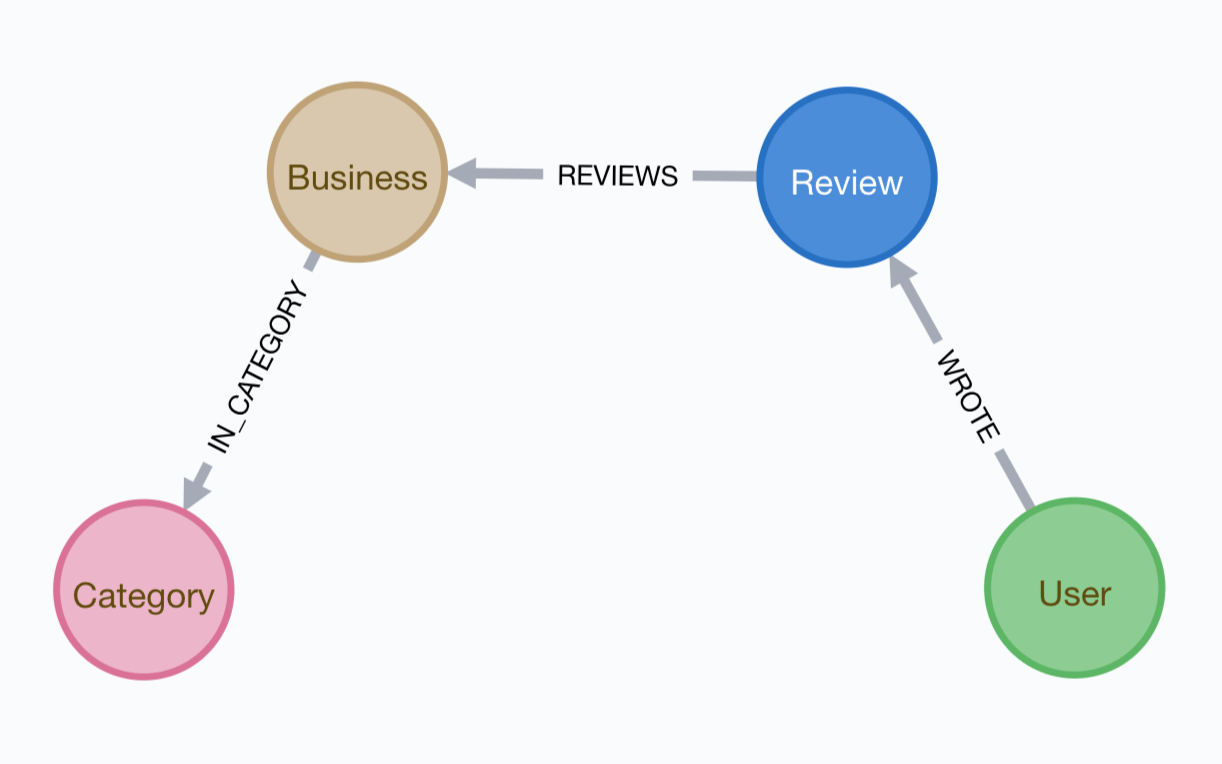
Теперь давайте загрузим некоторые данные в наши две базы данных. Наши данные содержат компании, категории, отзывы и пользователей, написавших отзывы. Мы загрузим данные из файла CSV с фильтрацией по городам, чтобы убедиться, что мы загружаем компании в соответствующую базу данных.
Сначала переключимся на базу данных sanmateo:
:use sanmateo
Затем запустите инструкцию Cypher, чтобы прочитать CSV и создать наши данные в базе данных, фильтруя только компании в Сан-Матео:
LOAD CSV WITH HEADERS FROM "https://cdn.neo4jlabs.com/data/grandstack_businesses.csv" AS row
WITH row WHERE row.businessCity = "San Mateo"
MERGE (b:Business {businessId: row.businessId})
  ON CREATE SET b.name     = row.businessName,
                b.city     = row.businessCity,
                b.state    = row.businessState,
                b.address  = row.businessAddress,
                b.location = Point({latitude: toFloat(row.latitude), longitude: toFloat(row.longitude)})
MERGE (u:User {userId: row.userId})
  ON CREATE SET u.name = row.userName
MERGE (r:Review {reviewId: row.reviewId})
  ON CREATE SET r.text  = row.reviewText,
                r.stars = toFloat(row.reviewStars),
                r.date  = date(row.reviewDate)
MERGE (u)-[:WROTE]->(r)
MERGE (r)-[:REVIEWS]->(b)
WITH *
UNWIND split(row.categories, ",") AS cat
  MERGE (c:Category {name: cat})
  MERGE (c)<-[:IN_CATEGORY]-(b)
Затем мы делаем то же самое для наших предприятий в Миссуле, сначала переключаясь на базу данных missoula:
:use missoula
Затем мы запускаем тот же оператор Cypher для загрузки данных для предприятий в Миссуле, но изменяем вторую строку, чтобы отфильтровать строки в файле CSV только для предприятий в Миссуле:
LOAD CSV WITH HEADERS FROM "https://cdn.neo4jlabs.com/data/grandstack_businesses.csv" AS row
WITH row WHERE row.businessCity = "Missoula"
MERGE (b:Business {businessId: row.businessId})
  ON CREATE SET b.name     = row.businessName,
                b.city     = row.businessCity,
                b.state    = row.businessState,
                b.address  = row.businessAddress,
                b.location = Point({latitude: toFloat(row.latitude), longitude: toFloat(row.longitude)})
MERGE (u:User {userId: row.userId})
  ON CREATE SET u.name = row.userName
MERGE (r:Review {reviewId: row.reviewId})
  ON CREATE SET r.text  = row.reviewText,
                r.stars = toFloat(row.reviewStars),
                r.date  = date(row.reviewDate)
MERGE (u)-[:WROTE]->(r)
MERGE (r)-[:REVIEWS]->(b)
WITH *
UNWIND split(row.categories, ",") AS cat
  MERGE (c:Category {name: cat})
  MERGE (c)<-[:IN_CATEGORY]-(b)
Запрос с драйверами
Теперь мы готовы запросить Neo4j. При использовании нескольких баз данных в Neo4j мы указываем базу данных, которая будет использоваться при создании объекта session из экземпляра драйвера Neo4j. Затем мы можем использовать этот объект сеанса для выполнения запросов к указанной базе данных. Например:
const neo4j = require('neo4j-driver');
const driver = neo4j.driver(
  'neo4j://localhost:7687',
  neo4j.auth.basic('neo4j', 'letmein')
);
const session = context.driver.session({
  database: "sanmateo"
});
session.run('MATCH (b:Business) RETURN count(b) AS count')
    .then(res => console.log(res.records[0].get('count')))
Использование нескольких баз данных с GraphQL
Затем мы хотим создать GraphQL API, который будет предоставлять наши данные с помощью neo4j-graphql.js, принимая во внимание наш вариант использования с несколькими арендаторами. У нас есть несколько вариантов предоставления доступа к нашему мультитенантному графу через GraphQL, и мы рассмотрим каждый из них:
- Просто используйте базу данных по умолчанию
- Создайте отдельные конечные точки GraphQL для каждого клиента
- Создайте одну конечную точку GraphQL, которая может обращаться к обеим базам данных.
Настраивать
Во-первых, создание нашей схемы GraphQL и экземпляра драйвера Neo4j одинаково для каждого подхода. Мы определяем наши определения типов GraphQL, а затем используем neo4j-graphql.js для создания GraphQL API:
const { makeAugmentedSchema } = require('neo4j-graphql.js');
const { ApolloServer } = require('apollo-server');
const neo4j = require('neo4j-driver');
const typeDefs = `
type User {
  name: String!
  wrote: [Review] @relation(name: "WROTE", direction: "OUT")
}
type Review {
  date: Date!
  reviewId: String!
  stars: Float!
  text: String
  reviews: [Business] @relation(name: "REVIEWS", direction: "OUT")
  users: [User] @relation(name: "WROTE", direction: "IN")
}
type Category {
  name: String!
  business: [Business] @relation(name: "IN_CATEGORY", direction: "IN")
}
type Business {
  address: String!
  city: String!
  location: Point!
  name: String!
  state: String!
  in_category: [Category] @relation(name: "IN_CATEGORY", direction: "OUT")
  reviews: [Review] @relation(name: "REVIEWS", direction: "IN")
}
`;
const schema = makeAugmentedSchema({ typeDefs });
const driver = neo4j.driver(
  'neo4j://localhost:7687',
  neo4j.auth.basic('neo4j', 'letmein')
);
С neo4j-graphql.js можно использовать несколько баз данных, указав значение в контексте преобразователя GraphQL. Если значение для context.neo4jDatabase не указано, используется база данных по умолчанию.
Использование базы данных по умолчанию
Если мы не укажем базу данных, то при выполнении наших запросов GraphQL будет использоваться база данных по умолчанию (как указано в neo4j.conf). Это бесполезно для нашего текущего варианта использования с несколькими арендаторами, но гарантирует, что у нас будет предсказуемый запасной вариант, если мы не укажем базу данных в объекте контекста:
const server = new ApolloServer({ schema, context: { driver } });
server.listen(3003, '0.0.0.0').then(({ url }) => {
  console.log(`GraphQL API ready at ${url}`);
});
Создайте две конечные точки GraphQL
Следующий вариант - создать отдельные конечные точки GraphQL для каждого клиента. В этом примере наше клиентское приложение будет отвечать за знание, к какой конечной точке GraphQL подключиться.
Мы используем Apollo Server для обслуживания схемы GraphQL, созданной neo4j-graphql.js. База данных Neo4j, которая будет использоваться, указывается в объекте контекста преобразователя GraphQL. Объект контекста передается каждому преобразователю, и neo4j-graphql.js как минимум ожидает экземпляр драйвера JavaScript Neo4j под ключом driver.
Чтобы указать базу данных Neo4j, которая будет использоваться, укажите значение в объекте контекста под ключом neo4jDatabase, который оценивает строку, представляющую желаемую базу данных. Если значение не указано, будет использоваться база данных Neo4j по умолчанию.
Здесь мы запускаем конечную точку GraphQL для нашей sanmateo базы данных на порту 3003 и отдельную конечную точку GraphQL для базы данных missoula на порту 3004:
const sanmateoServer = new ApolloServer({
  schema,
  context: { driver, neo4jDatabase: 'sanmateo' }
});
sanmateoServer.listen(3003, '0.0.0.0').then(({ url }) => {
  console.log(`San Mateo GraphQL API ready at ${url}`);
});
const missoulaServer = new ApolloServer({
  schema,
  context: { driver, neo4jDatabase: 'missoula' }
});
missoulaServer.listen(3004, '0.0.0.0').then(({ url }) => {
  console.log(`Missoula GraphQL API ready at ${url}`);
});

Создать одну конечную точку GraphQL
Мы также можем использовать функцию для определения объекта контекста. Это позволяет нам использовать значение из заголовка запроса или некоторого промежуточного процесса для указания базы данных Neo4j.
Здесь мы используем значение заголовка запроса x-database для базы данных Neo4j:
const server = new ApolloServer({
  schema,
  context: ({req}) => {
    return {driver, neo4jDatabase: req.headers['x-database']}

  }
})
server.listen(3003, '0.0.0.0').then(({ url }) => {
     console.log(`GraphQL API ready at ${url}`);
   });

Указав базу данных Neo4j, которая будет использоваться в объекте контекста, мы получим гибкость для реализации мультитенантности так, как мы считаем наиболее подходящей для нашего приложения, будь то создание нескольких конечных точек GraphQL с использованием заголовков запросов, или использование промежуточного программного обеспечения для определения базы данных во время запроса.
Ресурсы
Подробнее об использовании нескольких баз данных с Neo4j вы можете прочитать в Руководстве по Neo4j. См. Docs для получения дополнительной информации о neo4j-graphql.js, включая поддержку нескольких баз данных.
Код этого примера GraphQL можно найти на Github здесь.
Если вам это показалось интересным, подпишитесь на список рассылки GRANDstack, чтобы быть в курсе всех новостей GRANDstack: